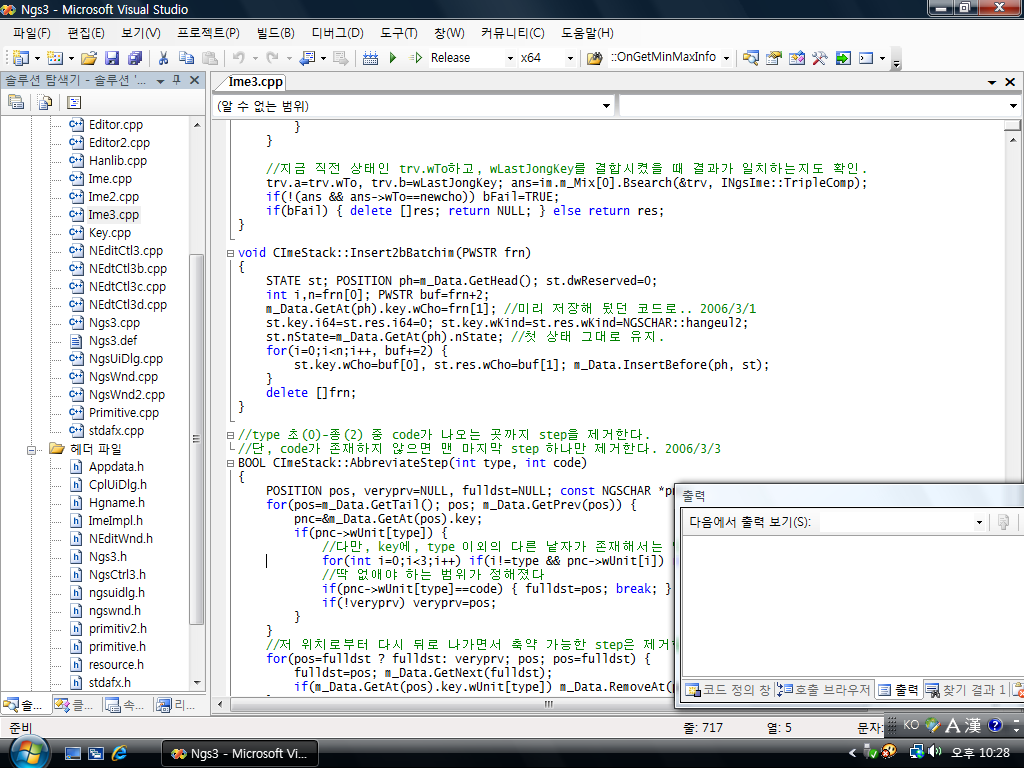
물론 지금은 개발툴도 2008로 업그레이드한 상태이다.
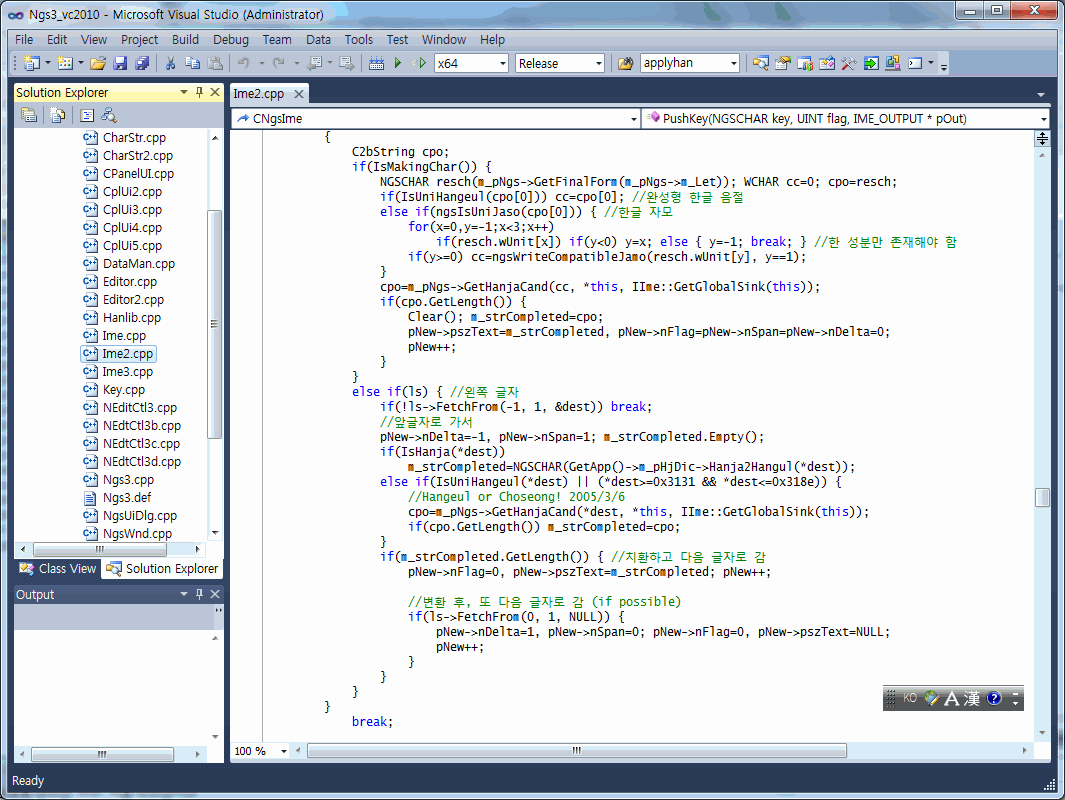
2012년 5월 현재, 비주얼 C++ 2010을 쓰고 있는 개발 인증샷.

Posted by 사무엘


Posted by 사무엘
http://www.dilascia.com/ruint.htm
본인이 이 사람 이름을 본 것은 비주얼 C++ 6.0을 쓰던 시절부터이다.
MSDN을 보면 각종 함수 레퍼런스, 툴 설명서뿐만이 아니라 고맙게도 일부 책이나 간행물 내용까지 수록돼 있었는데, 어느 프로그래밍 잡지의 C++ Q&A란을 애독하기 시작했다. 그리고 그 코너를 집필하는 사람이 바로 저 전설의 프로그래머 Paul DiLascia였다.
특히 비주얼 C++ 6.0 MSDN에는 bmp 파일 뷰어를 밑바닥부터 만드는 과정을 설명해 놓은 게 있었는데
친절한 설명도 설명이거니와 이 아저씨는 글빨 입담이 정말 구수하다는 것을, 생소한 영어를 읽으면서도 느끼지 않을 수가 없었다.
윈도우+MFC 프로그래밍의 달인인 건 의심의 여지가 없고, 나중에 알고 보니 이 사람은 원래 수학 전공에다 컴퓨터 예술 쪽에도 심취해 있는 다재다능 엄친아였다. 이름이 좀 유럽풍인 것 같아 보이나, 실제로는 뉴욕에서 태어나서 자란 골수 미국인이라고 한다. 조상이 이민자?
링크를 건 곳은 저 사람의 2003년 시절 인터뷰이다.
고수 프로그래머로서의 조언도 여럿 담겨 있는데, 그 내용이 무척 공감이 간다.
- 최신 기술 동향은 놓치지 않되, 남들이 좋다고 하는 데에 소신 없이 절대 우루루 휩쓸려 따라가지 말라. 가령 클라이언트처럼 C/C++가 독보적인 분야가 있고, .NET 같은 곳이 더 유리한 분야가 따로 있을 뿐이다. 자신의 문제 해결에 가장 적합한 툴이나 기술을 잘 고르는 요령이 무엇보다도 중요하다. 그런 것들은 도구일 뿐이며 절대적인 우열이 존재하는 게 아니다.
- Win32 API가 존재하는 한.. 윈도우즈 운영체제가 밑바닥부터 새로 뒤바뀌지 않는 한, 너무나 클래식(?)한 C/C++이나 MFC 같은 것은.. 결코 그렇게 호락호락 없어지지 않는다. 더 업데이트가 안 되고 있다는 말은 그만큼 API가 성숙하고 안정화됐다는 뜻으로 오히려 다행스러운 현상인 것이다.
- 늘 목표를 명확히 하고 내가 무슨 문제를 해결해야 하고 그 목표 달성을 위해 무슨 도구를 쓰는 게 가장 최적일까를 고민하라. 디자인 과정을 소홀히 하지 말라.
민장(minjang.egloos.com) 님 블로그에서도 비슷한 요지의 말을 봤던 것 같다.
그리고.....
"워드, 엑셀 같은 유명 소프트웨어에 들어있는 GUI 베껴서 따라 만드느라 시간 낭비 절대 하지 말라!" (그 시간에 실제 기능 구현에 필요한 자료구조/알고리즘 연구나 더 해라)
란 주문도 들어있다. ^^;;
아마 C++ Q&A 운영하면서 "나도 저기에 들어있는 그 기능, 그 UI 만들고 싶다. 어떡하면 좋은가?" 류의 뱁새가 황새 따라가려는 급의 문의를 엄청 많이 받았지 싶다.
* * * * *
Too many programmers spend all their energy implementing some cutesy UI feature like docking windows or pink scrollbars because they saw it somewhere else. Microsoft has 5000 programmers to create animated paper-clips. You don't. Don't fall into the code envy trap!
Don't get side-tracked implementing the latest GUI feature you saw in Word or Excel.
(그런 공룡 대기업들이나 부리는 '가진 자의 여유'를 당신이 따라할 여건은 안 된다는 걸 알아야 한다)
* * * * *
저건 우리나라의 유명한 비주얼 C++ 서적의 저자인 이 상엽 씨도 똑같은 말을 했다.
* * * * *
그래도 예술적 가치가 있는 프로그램 제작에 열을 올린다면 좋은 이야기다. 그것도 아닌 것을 예술인냥 착각하고 움직이지는 절대 말라는 것이다. 예술적 가치가 없는 부분이 어떤것인가를 물어 볼것이다. 거 있지 않은가? MS 사에서 도움말 강아지 이리저리 왔다 갔다 한다고 자신의 프로그램에 강아지 만들어 넣는거...Visual C++의 워크 스페이스 창이 도킹 되었다가 떨어졌다 하는데 나두 이거 만들구 싶다 라는거...
예를 간단하게 들어서 MP3 에 있는 압축기술이나 음성인식 또는 지문인식 등의 기능이 예술이라고 볼수 있고 그냥 강아지 이리저리뛰어 다니는 것은 처음 만들어 내지 않는다면 것은 잡다구리 테크닉이다.
* * * * *
그래서 <날개셋> 한글 입력기의 편집기 프로그램은... 9년이 넘게 개발되고 버전이 5.5가 넘어선 지금까지도 완전 윈도우 95의 기본 컨트롤과 UI 요소만 사용하여 만들어져 있다. ^^;;; 편집기의 경우 과거 3.41 버전에서 MFC를 떼어내는 과정에서, 이제 도구모음줄이 도킹을 할 수 없게 바뀌었다. 그게 원래 MFC가 구현해 주던 일이었기 때문이다.
사실, 편집기를 실행해 보면 도구모음줄 아이콘들이 좀 중앙에 안 있고 메뉴, 즉 위쪽에 너무 바싹 붙었다는 인상을 받는데 이것도 딱히 바꿀 방법이 없다.
아이콘 사이에 임의의 크기로 여백을 내는 것도 MFC가 윈도우 프로시저를 다 서브클래싱해서 굉장히 지저분한 작업을 한 끝에 구현한 것이다. 이런 점에서 MFC는 단순히 윈도우 API wrapper 역할만 하는 것은 아님을 알 수 있다. 하지만 그런 거 따라하는 일에 너무 심취하지 말라는 얘기이다.
아쉽게도 이 사람은 작년(2008) 9월, 40대 후반의 나이로 세상을 떠났다. 사인은 밝혀져 있지 않다. 비주얼 C++ 2008의 내장 MSDN에는 2006년자로 작성된 그의 글을 볼 수 있는데, 이제 더는 그런 글을 접할 수 없으니 안타깝다.
Posted by 사무엘
printf/scanf가 받는 % 문자는 이식성 면에서 매우 큰 문제를 일으킬 수 있다. 기계 종류와 운영체제/컴파일러(정확하게는 CRT 라이브러리)의 종류에 따라 미묘한 차이가 존재하기 때문이다.
이런 잡음이 제일 없던 꿈 같은 시절은 단연 32비트 시절이다. 포인터와 정수가 전부 4바이트가 됨으로써 %d와 %ld 같은 골치아픈 구분도 없어졌고, 포인터도 far/huge 같은 구분이 없어져서 모든 것이 32비트 단위로 끝이 났기 때문이다. %d, %x, %u 하나만으로 컴퓨터에서 통용되는 거의 모든 정수를 바로 읽고 쓸 수 있던 시절. -_-
* * * * * *
Note 1
참고로 정수가 아닌 실수는?
16비트 시절에는 터보 C/C++에 무려 10바이트 크기의 실수인 long double이 있었고, 파스칼에는 아예 6바이트짜리 Real이라는 기괴한 실수가 존재했다. CPU의 machine word가 16비트 크기이고, GPU는커녕 부동소숫점 전용 프로세서(FPU)마저 흔치 않아서 이런 연산도 소프트웨어적으로 직접 구현하는 게 당연시되던 시절이었으니까 그런 게 존재 가능했다.
요즘 세상엔 무조건 32비트 float 아니면 64비트 double이지, 저런 건 상상도 못 할 개념일 것이다. 픽셀 크기조차도 옛날에는 트루컬러 24비트이다가 요즘은 컴퓨터가 더 처리하기 편한 형태인 32비트이다.
* * * * * *
하지만 이렇게 32비트 천하통일 시대에 끝이 보이기 시작한 것은, 64비트 컴퓨터가 속속 등장하고 문자열도 일반적인 8비트 크기가 아닌 16비트 단위의 소위 wide string이 공존하게 되고부터이다.
그럼, 이번에도 역시 숫자부터 예를 들어 보겠다.
32비트 윈도우 + 비주얼 C++의 CRT는
32비트 정수를 주고받을 때는 당연히 그대로 %d나 %u를 주면 되고 별도의 크기 지정자가 필요 없다. 하지만 64비트 정수에 대해서는 I64라는 접두사를 넣어서 %I64d처럼 해야 한다.
이 규칙은 64비트에서도 완전히 동일하게 적용되기 때문에 이식이 쉽다.
특히 호환성을 극도로 중요시하는 윈도우는 64비트 기계에서도 int 형을 32비트 4바이트로 책정한 관계로, 64비트에서도 %d가 아닌 %I64d를 해 줘야 32비트 영역을 넘어서는 정수를 읽거나 쓸 수 있다. 64비트 기계이더라도 숫자는 일단 변함없이 32비트가 주류라는 인상을 넣은 것이다.
* * * * * *
Note 2
윈도우즈 문화권은 왜 이리도 호환성에 목숨을 걸까?
간단하다. 그쪽은 오픈소스 진영과는 근본적으로 분위기가 다르기 때문이다.
모든 것이 투명하게 소스 공개이고, 사용자들이 다 컴퓨터를 능수능란하게 다루는 능동적인 해커들인 세상에서는 뭔가 소프트웨어를 업데이트해도 줘도 못 먹는 사람이 없이 물갈이도 금방 된다. 소프트웨어 계층에 breaking change가 잦더라도 재컴파일 한 번으로 '끗'이며, 그렇게 문제가 되지 않는다.
하지만 여기는 사정이 다르다. 마우스로 느릿느릿 아이콘 클릭밖에 못 하고 악성 코드에 속수무책으로 당하는 컴맹도 많다. 또한 돈 내기 싫어서 구닥다리 OS를 계속 고집하는 사람도 많다. 오로지 MS라는 회사가 모든 내부 사정을 관장하고 고객을 다 떠먹여 줘야 한다. 그러니 무조건 한번 만들어 놓은 것에 대한 유지 관리가 편리한 시스템을 만들어야 하며, 새 제품을 단절 없이 많이 팔려면 하위 호환성이라는 보수적인 가치를 최우선 순위로 두고 목숨 걸 수밖에 없는 것이다.
* * * * * *
단, 딱 하나 문제가 될 수 있는 것은 소위 INT_PTR 타입으로, 32비트 기계에서는 32비트이지만, 64비트에서 실제로 64비트 크기로 확장되는 정수이다. 이게 진짜로 포인터의 크기와 같으며 machine word와 크기가 일치함이 보장되는 정수이다.
이런 정수를 다루는 프로그램의 이식성을 위해서 %Id가(64만 빼고) 별도로 추가되었지만, 이건 반대로 구형 CRT에서는 지원되지 않는 걸로 알고 있다.
그래도 다행인 건, binary format이 아니라 사람이 읽을 수 있는 문자열 형태로 숫자를 읽고 쓰는데 32비트 크기를 넘어서는 범위를 다루는 일은 굉장히 드물다는 것. 차라리 실수를 다루면 다뤘지 정수가 그러는 일은 드문 편이다.
참고로, 가변 인자 함수가 호출될 때, 모든 정수형은 기본적으로 int 형으로 promote가 일어난다. char이든 short이든 다 32비트 내지 64비트 크기로 폭이 증폭된다는 것이다. float는 double로 바뀐다. 그렇기 때문에 float나 double이나 동일하게 %f나 %g로 출력 가능하다. 단지, 값이 아니라 포인터가 전달되는 scanf를 호출할 때는, float에 대해서는 %f를, double에 대해서는 %lf라고 반드시 타입 구분을 엄격히 해 줘야 할 것이다.
64비트 정수를 전달할 때는 32비트 기계에서는 스택에 push가 두 번에 걸쳐 일어나지만, 본디 64비트이던 기계에서는 역시 한 번만에 인자 전달이 끝난다. 그렇기 때문에 %d %d %d 해 놓고 실제로 32, 64, 32비트의 순으로 변수를 전달했다면 32비트 기계에서는 마지막 숫자가 꼬이겠지만(push는 128비트, 하지만 pop은 96비트) 64비트는 둘째 정수가 범위만 32비트 내부에 있다면 세 숫자가 모두 제대로 출력이 된다(push와 pop 모두 64*3비트 동일).
물론 이 경우, 둘째 %d를 %I64d로 해 줘야 32와 64비트 기계에서 모두 잘 동작하는 portable 코드를 만들 수 있다.
윈도우 외의 다른 운영체제는 사정이 어떤가 모르겠다. 64비트 정수를 출력할 때 32비트 기계에서는 %lld, 심지어 64비트에서는 %ld 이렇게 차이가 존재한다고도 하는데.. =_=;;
gcc 자체가 I64와는 다른 관행을 사용하는데 기계마저 64비트로 가고 나면 이거 이식성 면에서 재앙이 발생하지는 않으려나 우려된다.
다음으로 문자열이 있다.
알파벳 이외의 문자는 다룰 일이 없는 서버나 게임 엔진 같은 아주 특수한 프로그램을 개발하는 게 아니라면 이제 유니코드 문자는 대세가 되어 있다. 물론 UTF8도 쓰이고 유닉스 계열 운영체제에서는 심지어 UTF32도 쓰이지만, 그래도 유니코드 문자열을 컴퓨터 메모리 상으로 저장하는 데 비용 대 효율이 가장 뛰어난 방법은 UTF16이다. 특히 윈도우는 NT 시절부터 이렇게 16비트 단위의 wide string을 내부적으로 다뤄 와서 wchar_t = 곧 unsigned short나 다름없을 정도이다.
printf는 ansi 버전과 wide 버전이 존재하며, format으로 지정해 주는 문자열과 %s로 전달하는 문자열의 타입은 대체로 일치한다. ansi 버퍼에다가 wide string을 출력한다거나 그 반대로 해야 하는 경우는 드물다. 하지만 그런 일이 아주 없는 것은 아니다.
이럴 때 윈도우에서는 %hs, %ls라는 지정자를 주어 h는 버퍼 크기와 상관없이 무조건 ansi, l은 버퍼 크기와 상관없이 무조건 wide라고 지정을 할 수 있게 했다. gcc 쪽은 잘 모르겠다.
그래서 함수 오버로딩이 지원되는 C++ 스트림이 짱이라는 말이 있을 정도이니까. 아무 곳에서나 그저 무조건 OK.
Posted by 사무엘
※ auto keyword
지금까지 signed와 더불어서 C/C++의 주요 '유명무실' 사문 예약어이던 auto가 비주얼 C++ 2010에서는 완전히 새롭게 거듭날 예정이다.
auto는 그 변수에 초기화해주는 값이 나타내는 타입을 그대로 부여해 준다. 즉,
int a=5; (...) auto b=a; 라면 b는 int형이 되고
vector<int> arr; auto itor=arr.begin(); 이라면 itor의 타입은 vector<int>::iterator 가 된다.
그래서 말 그대로 auto는, 뒤에 나오는 대입값을 보고 자료형을 '자동'으로 알아서 판단하라는 의미가 된다.
이런 게 언제 C++ 표준으로 상정됐는지는 모르겠는데, 기능과 문법을 만들어 놓은 방식이 정말 기발하고 참신하기 그지없다.
이 키워드 하나가 수많은 번거로운 자료형 하드코딩 타이핑 내지 typedef들을 예방해 주리라 기대된다.
당연한 말이지만 auto 자체는 sizeof 같은 연산자의 피연산자가 될 수 없다. 또한 auto가 무슨 비주얼 베이직의 variant 타입처럼 아무 자료형이나 수시로 집어넣을 수 있는 타입을 의미하지는 않는다.
auto 형으로 선언되는 개체나 변수는, 마치 참조자를 선언할 때처럼 반드시 선언과 동시에 값 대입 내지 초기화가 되어야 할 것이다.
C++은 함수의 인자 개수와 인자의 자료형으로만 오버로딩을 구현하지, 함수의 리턴값으로 오버로딩을 구현하지는 않기 때문에 이런 기능을 모호성 없이 구현할 수 있는 것이다.
이 외에 다른 이상한 C++ 문법도 도입되고 C++ 라이브러리 쪽에도 무슨 변화가 있는데 그건 잘 모르겠고,
프로젝트 파일 포맷이 또 바뀔 예정이라고 한다.
※ 비주얼 C++ 프로젝트 파일
여기서 잠깐 역사 수업. 비주얼 C++ 프로젝트 파일의 역대 계보는 다음과 같다.
1기 *.vcp는 16비트 1.x 초창기 시절에 쓰였다.
2기 *.mdp는 32비트 통합 IDE인 Developer Studio 초창기 시절인 4.x에서 쓰였다. 세월이 세월이니만큼, 1기와 2기는 지금은 거의 찾을 수 없는 전설의 파일 포맷이 돼 있다.
3기 *.dsw와 *.dsp는 드디어 여러 프로젝트를 한데 묶어 관리하는 워크스페이스라는 개념이 도입된, 5와 6 두 버전에서 쓰였다.
그 후 닷넷급이라 할 수 있는 비주얼 C++ 200x에 가서는 4기인 *.sln, *.vcproj 방식이 등장했다. 비주얼 베이직/C++/C# 모든 언어들의 프로젝트 사이에 일관성이 생겼으며 워크스페이스라는 명칭이 솔루션으로 바뀌었다. 그리고 프로젝트 파일은 내부 구조가 XML 형태로 바뀌었다.
이제 프로젝트 파일의 내부 구조가 또 바뀔 일은 없을 거라고 생각했는데 2010에서는 vcxproj라고 또 바뀔 거라고 하니 이게 웬일?
설마 MS 오피스 2007처럼 또 zip 압축을 하는 건 아닌가 모르겠다.
하지만 개발툴의 프로젝트 파일은 소스 버전 관리의 편의성 같은 이유도 있고 해서 다들 plain text 방식으로 저장하지, 바이너리 방식을 쓰지는 않을 텐데 말이다.
더구나 개발툴의 버전이 바뀔 때마다 각종 컴파일러 옵션들은 시시때때로 추가되거나 삭제, deprecate되기도 하기 때문에, 이런 프로젝트 파일들은 유연성, 하위 호환성, 확장성을 최대한 유지하는 게 짱이다. 즉 plain text가 정답이라는 뜻이다.
경험상 비주얼 C++ 2005하고 2008은 프로젝트 파일 포맷이 거의 차이가 없다.
sln과 vcproj 파일 앞줄에 있는 버전 번호만 1 줄여 주면, 2008로 만든 프로젝트도 2005에서 아무 문제 없이 바로 읽어들일 수 있다.
※ 비주얼 C++ 6.0이 나온 지 좀 있으면 벌써 12주년
얘기가 여기까지 왔는데 또, 애증이 교차하는 비주얼 C++ 6.0 얘기를 하지 않을 수 없다.
무려 11년 전엔 1998년에 출시되었고 아직까지도 애용되고 있는 소프트웨어로는 스타크와 더불어 양대 산맥이 아닌가 생각된다.
너무 구닥다리가 되어 외형이 후져 보이고(비록 당대로서는 MS 오피스 97 스타일의 새끈-_-한 UI였지만),
64비트 지원 안 되고 최신 하드웨어 기술 및 C++ 표준이 반영 안 돼 있는 것 자체만 빼면 정말 잘 만든 물건이긴 하다.
가끔은 6.0 특유의 그 클래스 마법사가 그리워질 때도 있다.
MFC는 이제 <날개셋> 타자연습 소스 열어볼 때 말고는 별로 접할 일도 없어졌구나.
그 비주얼 C++이 곧 있으면 연도도 2010이고 버전 번호로도 10.0이 나올 예정이다. 감회가 새롭다.
참고로 비주얼 C++ 2005는 2005년 하반기에 나왔지만 2005라는 타이틀이 붙은 반면,
2008은 비슷한 2007년 하반기에 출시됐지만 1이 더해진 2008이라는 타이틀이 붙었다.
※ 여자 프로그래머
7월 1일.. 경의선 전철 개통, 용인-서울 고속도로 개통, 거기에다 비정규직법 상정 2주년-_- 등 여러 굵직한 일이 많았는데, 나도 이제 병특 끝난 지 1주년이 됐다.
그리고 직장 생활 경력이 3년을 넘어갔다. 최소한 말단 신입사원 딱지는 떼는 짬밥이 됐고, 주임/대리급을 바라보는 신분이다. 하지만 옛날 회사나 지금 회사나 여전히 제일 나이가 어리고 내 밑으로 신입을 대한 적이 없으니, 예나 지금이나 늘 막내이다.
그리고 내가 지금까지 다닌 회사에서 여자 개발자를 본 적은 전혀 없다.
IT 회사라고 해도 여직원 하면 오로지 디자인, 기획 아니면 회계/경리이다. 개발자가 여자인 경우는.. 글쎄다.
하지만 외근 나간 연구소에서는 그래도 비주얼 C++ 띄워 놓고 코드와 씨름하고 있는 여자분들을 주변에서 여럿 볼 수 있어서 인상적이었다.
차라리 학교에 있을 때는 그런 모습을 심심찮게 볼 수 있었다. 내가 나온 학교는 공대 중에서 성비가 상당히 균형 잡힌-_-;; 편에 드는 곳이었으며, 전산과 역시 예외가 아니었기 때문이다.
하지만 나는 학교 시절엔 과 친구들하고 거의 어울리지 않고 동아리 같은 것도 안 하고 지냈기 때문에 그런 학우들로부터는 이렇다할 '임팩트'를 받지 못했다.
여직원하고 "아.. 그 땐 이런 함수를 쓰면 돼요"
"이 클래스는 여기서 상속 받았고 이 가상 함수는 이런 용도로 오버라이드하면 됩니다. 대략 이렇게 구현을 하면 어떨까요?"
"아 그렇게 생각해 보니 이렇게 짜면 버퍼 오버런이 우려되고, 멀티스레드 환경에서는 잠재적으로 또 문제가 있겠군요"
이런 이야기를 나눈다면.. 졸라 감회가 새로울 것 같다. 태어나서 이성하고 그런 얘기는 한 번도 한 적이 없으니까. =_=
하긴, 부부 교사도 있고,
커플이 나란히 코레일에 입사하여 기관차 운전 연수를 받던 부부 기관사도 봤는데, (촬영 당시 곧 결혼 예정이라고 쓴 걸 봤음)
부부 개발자라고 없을 이유는 없으리라 생각한다. -_-
Posted by 사무엘
꽤 희귀한 기회 덕분에,
한때 시대를 풍미했던 상업용 소프트웨어의 소스를 구경하게 됐습니다.
윈도우 3.1에서 돌아가는 녀석이었거든요.
저야 도스박스에다 윈도우 3.1 + 비주얼 C++ 1.5도 갖추고 있어서 이걸로 돌려도 되지만
32비트로 포팅을 해 보고 싶어서 최신 개발툴로 프로젝트를 만들고 빌드를 해 봤습니다.
당연히 바로 빌드는 안 되고 수백여 군데에서 에러가 나는데...
16비트 윈도우 코드의 특징을 한눈에 알 수 있었습니다.
1. precompiled header가 없었는지 매 소스 파일마다 <windows.h> 인클루드.
2. 말로만 듣던 far, huge 포인터의 압박. 메모리 모델별로 malloc이라든가 포인터를 다루는 함수도 따로 존재. _fmalloc 같은.
3. POINT 구조체. 옛날엔 POINT 구조체의 x,y 멤버가 16비트 크기였기 때문에 32비트 long 하나로 POINT를 나타내는 게 관행이었으며, 심지어 lParam *을 POINT *로 바로 캐스트하는 MAKEPOINT 같은 매크로까지 존재했습니다. 하지만 지금은 좌표계가 32비트로 커지고 이것 때문에 MoveTo, SetWindowOrg, SetViewportExt 같은 함수들은 모두 Ex가 붙은 형태로 프로토타입이 바뀌게 됐죠.
4. 옛날에는 핸들(HANDLE, HINSTANCE, HGDIOBJ, HWND 등등)은 전부 void *의 typedef였고, 아무 형변환 없이 마음대로 섞어 썼습니다. 이 폐해를 막으려고 지금은 STRICT(엄격한 타입 구분)라는 개념이 추가됐지만 어마어마한 분량의 레거시 코드를 컴파일시키려면 그 옵션을 꺼야 하죠.
5. WM_CTLCOLOR 메시지. 옛날에는 이 메시지 하나만 왔지만 지금은 WM_CTLCOLORBTN, DLG, EDIT, LISTBOX 등으로 세분화됐습니다. 다만, 16비트 관행을 물려받은 MFC는 여전히 OnCtlColor 라는 한 함수로 이 메시지들을 모두 처리합니다.
6. 멀건 윈도우 3.1 대화상자에다가 은빛 3차원 효과를 입혀 주는 ctl3d.dll과 교신을 하는 흔적. 그러고 보니 그때는 이런 효과가 지금의 공용 컨트롤 6.0 매니페스트 같은 그런 매개체였던 것 같습니다. MFC에도 CWinApp 클래스에 Enable3dControls 같은 멤버 함수가 있을 정도였는데, 이제는 완전히 deprecated로 처리되죠.
7. DLL도 아니고 EXE에 웬 export 속성이 지정된 함수? 그것도 __declspec(dllexport) 같은 지금 통용되는 문법으로 작성된 것도 아닙니다.
16비트 윈도우 EXE는 헥사 에디터로 들여다보면, 윈도우/대화상자 프로시저처럼 운영체제로부터 호출을 받는 콜백 함수들의 이름을 따로 name table에다 등재를 해 놓는 경우가 많더군요. 꼭 그렇게 할 필요는 없는데 왜 그러는지 궁금.. 디버깅 정보와 관련이 있는지, 아니면 속도를 높이려고 그러는지 이유는 모르겠습니다.
8. C++ 문법이 바뀌어서 옛날에는 허용되었으나 지금은 허용되지 않는 몇몇 문법들
맥이나 리눅스 같은 다른 플랫폼들은 도스 같은 극악의 호환성 발목은 없었겠지만, 16비트를 겪은 시절조차 전혀 없었는지가 문득 궁금해지네요.
참고로 저는 C/C++은 32비트 도스 익스텐더 환경에서(왓콤, DJGPP) 처음 시작했고 16비트는 거의 접한 적이 없는 세대입니다. ^^
Posted by 사무엘
컴퓨터 프로그램에서 뭔가 데이터를 저장할 기억 장소를 확보하는 방법은 크게 다음과 같은 세 가지이다.
먼저, 함수 안에서 선언하는 지역 변수이다. 지역 변수는 스택에다 할당되며, 그 함수와 사실상 일심 동체이기 때문에 거듭 실행되면 계속 스택을 점유하여 기억 장소도 계속 할당된다. 따라서 스레드 충돌 걱정을 할 필요도 없으며, scope을 벗어나면 소멸도 100% 자동으로 되기 때문에 memory leak가 생길 여지도 전혀 없다. 끼칠 수 있는 영향의 범위 자체가 가장 좁다.
그리고 전역/static 변수가 있다. 이들은 scope이 말 그대로 굉장히 정적이며, 프로그램 실행 기간 내내 살아 있고 프로세스 내부의 모든 스레드들이 공유한다. 잘 알다시피 static은 메모리에 저장되는 형태는 전역 변수와 완전히 같고, 접근성은 지역 변수와 같은 중간 존재이다.
이런 변수가 C++ 개체라면, 생성자나 소멸자 함수가 호출되어야 하는데 이는 main 함수의 실행을 전후하여 CRT 라이브러리가 알아서 해 준다.
마지막으로 heap에다 할당되는 동적 메모리가 있다. 이것은 가장 동적이고 자유로운 야생마 같은 형태의 메모리로, 프로그램 언어 차원에서 보장해 주는 scope이란 개념이 없다. 전적으로 프로그램이 양도 얼마든지 할당하고 아무 스레드에서나 해제 가능하다. 그 대신 C/C++에서 온갖 포인터 관련 버그, memory leak의 온상이 되는 존재이기도 하다.
그런데 멀티스레드 환경이 보편화하면서 첫째와 둘째의 또다른 형태의 중간에 속하는 scope이 필요해진 게 있으니, 바로 한 스레드 안에서만 global인 공간이다.
사실 표준 C 라이브러리조차도 멀티스레드 환경을 고려하지 않고 디자인되어 지금 문제되고 있는 요인들이 적지 않다.
함수의 실행 결과를 나타내는 에러 코드를 예전에는 그저 전역 변수 하나에만 집어넣으면 됐지만 멀티스레드 환경에서는 최소한 스레드마다 독립된 공간에 저장해야 한다.
strtok 함수는 예전에는 토큰 해석 위치를 그저 static 변수에다가 집어넣으면 됐지만, 이랬다가는 여러 스레드가 동시에 이 함수를 호출했을 때는 재앙을 각오하야 한다.
qsort 함수는 콜백 함수만 달랑 받지 콜백 함수에 따로 사용자가 지정한 데이터 따위를 넘겨 주지는 않는다. 결국 콜백 함수가 외부로부터 정렬 옵션 같은 걸 얻고자 한다면 전역 변수로부터 참고를 해야 하는데, 서로 다른 정렬 옵션으로 여러 스레드가 동시에 qsort를 호출하면 어떤 상황이 벌어지게 될까?
이런 기초적인 문제를 해결하기 위해 멀티스레드 운영체제는 thread local storage를 관리하는 기능을 제공한다. 윈도우 API에서는 TlsAlloc()으로 TLS 슬롯 번호를 하나 받아서 그 값을 전역 변수로 저장한다. (해제는 나중에 TlsFree()로) 그래서 TlsGetValue()와 TlsSetValue()에다가 아까 받은 TLS 슬롯을 넘겨줌으로써 machine word와 같은 크기의 정수/포인터 값을 읽고 쓰면 된다.
한 프로세스 안에서 동일한 슬롯 번호이지만, 이 함수를 호출하는 스레드가 무엇이냐에 따라 서로 제각기 독립된 값을 읽고 쓸 수 있음이 보장된다는 것이다. 스레드별로 공유해야 하는 값이 그냥 정수 하나라면 그 값을 바로 집어넣으면 되지만, 더 큰 영역의 메모리라면 따로 heap에다 할당한 메모리의 포인터를 집어넣으면 된다.
한 프로세스가 가질 수 있는 TLS 슬롯은 윈도우 95/NT4 시절에는 64개였다. 그러나 윈도우 2000/XP/비스타급에서는 수백, 1천 개가 넘어가도 괜찮게 바뀌었다. 나뿐만이 아니라 한 프로세스에 같이 로드되어 있는 다른 수십 개의 DLL들이 다 TLS 슬롯을 요청하기도 하기 때문에 TLS 슬롯 요청은 최소화하는 습관을 들여야 한다. TLS는 EXE보다도, 내가 생성하지 않은 스레드에 느닷없이 붙어서 돌아가야 하기도 하는 DLL을 만들 때 더욱 필요한 존재이다.
CRT 라이브러리의 DLL 에디션도 strtok 같은 함수를 구현하기 위해 TLS를 사용한다. 직전의 토큰 위치를 TLS 슬롯이 가리키고 있는 별도의 메모리에다 저장해 놓고 그때 그때 참고한다는 것이다.
또한 qsort처럼 콜백 함수가 사용할 데이터를 별도로 얻는 방법이 없는 함수를 사용하면서도 스레드 안전은 보장되게 코드를 짜야 할 때, 그 데이터를 TLS에다가 저장해 놓은 뒤 내가 짠 콜백 함수는 그 TLS를 사용하도록 만들 수도 있다.
TlsGet/SetValue()는 일종의 없는 scope을 새로 구현하는 함수이다. 그렇기 때문에 함수 실행 결과값을 기존 scope에 속하는 전역/지역 변수에다가 저장해 놓는다는 게 완전 무의미하다. 그러므로 콜백 함수가 TLS를 사용한다면 이 함수도 매번 무지막지한 빈도로 호출해야 한다. 따라서 이 함수는 다른 어떤 함수들보다도 성능에 초점을 맞춰 구현되어 있으며, 인자값의 검증을 거의 하지 않는다고 MSDN에 명시되어 있기도 하다.
물론 근본적으로 비주얼 스튜디오 2005에서 도입된 strtok_s는 TLS를 꺼낼 필요가 없이 토큰 위치를 아예 별도의 인자로 넘겨준 포인터에다 저장하도록 프로토타입이 바뀌어, 문자열을 중첩적으로 토큰화할 수도 있게 됐다.
그리고 qsort_s는 콜백 함수에다 넘겨줄 데이터를 별도로 같이 지정도 할 수 있다. 이렇게 하는 게 전역 변수급(TLS 포함) 메모리의 사용을 줄이고, 가능한 한 함수 인자와 지역 변수만 사용함으로써 모듈 사이의 독립성도 높이는 좋은 방법일 것이다.
DLL의 함수를 매번 LoadLibrary, GetProcAddress, FreeLibrary로 퍼 와서 쓰는 게 불편하기 때문에 import library가 존재하듯이, TLS도 비주얼 C++의 컴파일러 확장을 이용하여 좀더 쉽게 사용하는 방법이 있긴 하다. __declspec(thread)로 선언된 변수는 컴파일되는 바이너리의 내부에 .data, .text 처럼 섹션이 .tls라고 하나 더 생기고 거기에 보관된다. 하지만 이건 운영체제 관점에서 오버헤드가 굉장히 크고 옛날 운영체제에서는 동작하지 않기도 해서 잘 쓰이지 않는다.
#pragma data_seg로 섹션을 하나 더 만들어서 share 속성을 주어, 메모리 맵을 쓰지 않고 모든 프로세스에서 공유되는 메모리 영역을 만드는 것과 비슷한 차원인데, 물론 사용되는 기술 계층은 서로 차이가 있다.
우리가 다른 프로세스에서 멀티스레드로 동작하는 DLL을 만들고 있는데 우리 프로그램이 스레드마다 꽤 복잡한 C++ 오브젝트라든가(별도의 메모리 내지 리소스의 할당/해제가 필요한) 대용량 오브젝트를 운영해야 한다면 어떻게 해야 할까? TLS 슬롯에는 그 포인터밖에 집어넣을 수 없으며 메모리는 별도로 할당해야 한다. 그러나 디버거 쪽 훅을 설치하지 않는 이상 스레드의 생성, 소멸을 일일이 다 감시할 수는 없다. 그 대신 스레드마다 새로 생성된 TLS 슬롯의 초기값은 언제나 0임이 보장되기 때문에 오브젝트의 생성은 TlsGetValue의 값을 매번 검사하여 NULL일 때 하면 된다.
소멸은 약간 주의해야 한다. 프로세스의 실행 중에 스레드가 하나 실행이 끝났다면 DllMain에 DLL_THREAD_DETACH 통지가 오기 때문에 그때 우리 스레드 TLS 슬롯이 가리키는 포인터를 해제해 주면 되나, 문제는 모든 스레드의 소멸에 대해 일일이 이런 통지가 오지는 않는다는 것이다. primary thread의 실행이 종료됨으로써 DLL_PROCESS_DETACH 한 방으로 끝인 경우도 빈번하기 때문이다.
한 스레드가 여타 스레드의 모든 TLS 슬롯 값들을 enumerate하는 방법은 윈도우 API에 존재하지 않는다. 그렇기 때문에 각 스레드가 갖고 있는 포인터들은 별도의 전역 변수 링크드 리스트 같은 데에 별도로 관리하고 있다가 프로세스가 단번에 종료되면 이들을 한꺼번에 해제도 해 줘야 한다. 어차피 프로세스가 종료되는 마당에 memory leak 정도야 문제될 게 없지만, inter-process한 커널 오브젝트처럼 "cleanup"이 반드시 제때에 이루어져야 하는 자원도 있을 수 있기 때문이다.
물론 가장 이상적인 경우는 DLL을 만드는 우리가 매 스레드별로 Init 내지 Uninit 함수를 만들어서 우리 DLL을 사용하는 응용 프로그램이 스레드 실행의 시작과 종료를 알려 주는 것이다. 이렇게만 하면 모든 논란이 일축된다.
Posted by 사무엘
컴퓨터가 충분히 발전하여 오늘날의 운영체제 시스템 개념을 실현하게 된 것은 중앙 처리 장치가 최소한 32비트로 커지고부터이다. 보호 모드, 가상 메모리, 스레드 같은 것들. 4GB 정도는 돼야 주소 공간이 아쉬운 대로 넓다고 말할 수 있기 때문이다. 아무리 메모리 부족하고 열악한 임베디드 기기라 해도, 일단 최소한 디스플레이가 있는 general-purposed 컴퓨터라면, 16비트 시절의 원거리/근거리 포인터 같은 기법을 재도입할 정도로 열악하지는 않다.
물리 메모리와 가상 메모리의 대응을 운영체제가 CPU 차원의 지원으로 즉각 수행할 수 있게 되고 시분할 동시작업도 하드웨어 차원에서 할 수 있게 된 것은 소프트웨어 개발자에게 매우 큰 편의와 잠재성을 제공하게 되었다. 이를 입증하는 윈도우 3.1과 95의 큰 차이는 마우스 포인터 모양만 봐도 알 수 있다. 옛날에는 프로그램을 로딩하고 있을 때는 마우스 포인터가 완전 모래시계로 바뀌고 시스템 전체가 응답 불가 상태였지만, 지금은 화살표 오른쪽에 작은 모래시계가 붙고 시스템은 여전히 사용 가능하다(물론 좀 느려지기는 하지만). 또한, 모래시계 포인터는 해당 프로그램 안에서만 모래시계이지 다른 응용 프로그램에서는 여전히 화살표이다. 이른바 선점형 멀티태스킹 덕분이다.
단일 스레드 환경에서 사용자의 입력도 받으면서 작업도 동시에 수행하려면 타이머로 정말 찔끔찔끔 작업을 하거나, 작업 루틴 내부에서 수시로 입력을 체크(윈도우 API로는 PeekMessage 같은)해 주어야 했다. 효율은 효율대로 떨어지고 코드는 더욱 복잡해질 수밖에 없었다. 멀티스레드에서는 그런 번거로운 짓을 할 필요가 없다. 하지만 단일 스레드에서 전혀 신경쓸 필요가 없던 또다른 걱정거리가 생겼는데, 그것은 바로 스레드 동기화이다.
실행되고 있는 여러 스레드에 CPU 시간이 어떻게 분배되는지는 정말 전혀 예측할 수 없다. 심지어 a++; 같은 간단한 문장도 기계어로는 두세 개로 번역되는데 이 명령을 수행하던 도중에 스레드의 context가 바뀔 수가 있다. 여러 스레드가 동일한 데이터에 동시에 접근하여 값을 읽고 쓰다 보면, 다른 스레드에 의해 계산 전 값이 덮어써지거나, 아직 처리가 덜 끝난 중간 상태가 다른 스레드에 의해 뒤엉켜 버릴 수가 있다.
쉽게 말해서 a=0이고 a의 값을 1 증가시키는 스레드를 100개를 만들어서 아무 통제도 없이 이들을 동시에 실행시켰다고 가정해 보자. 그렇다면 스레드 실행이 모두 끝난 후 a의 값이 100이 되어 있을까? 천만의 말씀이다. 한 스레드가 a의 값이 0임을 인지만 한 찰나에 다른 스레드로 context가 넘어가고, 그 스레드 역시 a의 값을 0으로 인식하게 된다. 그러면 두 스레드는 모두 1이라는 값을 기록하게 되고.. 그렇다면 a는 도저히 100이 될 수가 없어짐이 명확하다. a++ 같은 지극히 단순한 연산이 이러한데 하물며 링크드 리스트나 트리 같은 복잡한 자료 구조를 변형하는 루틴에 여러 스레드가 동시에 접근한다면 어떤 재앙이 벌어질까?
멀티스레드 환경에서는 필연적으로 한 데이터를 여러 스레드가 공유하게 된다. 문서를 입력 받는 GUI 스레드와, 내부적으로 문서의 맞춤법 검사를 하는 스레드. 작업을 진행하는 스레드와 그로부터 작업 상황을 출력하는 스레드 등. 컴퓨터는 사용자가 프로그램을 짜 준 작업 중 어느 구간이 반드시 원자성이 보장되어야 하는지, 어느 구간이 반드시 여러 스레드들이 순차적으로 실행되어야 하는지를 알지 못한다. 이는 사용자가 지정해 주어야 하며, 운영체제는 스레드 동기화를 위한 여러 기법들을 제공하고 있다.
아무 통제 없는 무법천지인 멀티스레드 환경만으로는 프로그래머가 뭔가 의미 있는 작업을 하는 게 불가능하기 때문이다. 흔히 멀티스레드 환경을 여러 사람이 사용하는 한 화장실에다 비유하는데 무척 재미있고 적절한 비유 같다. 사람은 바글바글한데 화장실 문을 잠글 수 없다면 누가 감히 용변을 볼 수 있을까?
먼저, 여러 스레드들이 공유하여 시시때때로 값을 바꿀 수 있는 변수라면 C/C++의 경우 volatile로 선언하는 것이 필수이다. 고급 언어로 한 메모리 영역으로 표현되는 변수라 할지라도, 기계상으로는 메모리와 레지스터라는 차이가 존재할 수 있기 때문이다. 아울러 멀티스레드를 고려하다 보면 프로그램 모듈간의 독립성도 결국 고려하지 않을 수 없게 된다. 당장 쓰기 쉽다고 습관적으로 남발하던 전역/static 변수들은 멀티스레드 환경에서는 재앙으로 돌아올 가능성이 높다.
윈도우 운영체제는 정수 변수값을 1 증가하거나 감소시키는 것을 원자성이 보장되게 수행해 주는 InterlockedIncrement/Decrement라는 함수를 제공한다. 앞서 말했듯이 심지어 a++; 같은 간단한 연산조차도 컴퓨터에서는 CPU 한 사이클로 해결되지 않으며, 연산 수행 도중에 스레드 context가 바뀌고 결과가 꼬일 수 있다. 여러 스레드가 동시 접근할 수 있는 COM 오브젝트를 만든다면 reference count를 관리하는 함수를 이 함수를 이용해서 만들면 될 것이다. 고작 숫자를 1 더하고 빼는 것밖에 없지만 이것이 운영체제가 제공하는 가장 간단한 형태의 스레드 동기화 기능이라고 볼 수 있다.
이것보다 좀더 복잡하고 임의적인 루틴에 동기화 제동을 걸고 싶다면 임계 구간(critical section)이 좋은 선택이 될 수 있다. 크리티컬 섹션 오브젝트를 전역 변수로 선언하여 초기화해 준 후, 한 번에 한 스레드만이 차례대로 접근해야 하는 구간의 앞에 EnterCriticalSection을 해 주고, 끝에 LeaveCriticalSection을 해 주면 된다. 방법도 쉽다. 아까의 Interlocked* 함수는 크리티컬 섹션이 가미된 a++ 연산이라고 보면 된다.
이 정도면 다 된 것 같은데 동기화와 관련해서 또 필요한 게 있을까? 크리티컬 섹션은 간단하고 쓰기 쉽고 성능도 매우 좋은 반면, 타 스레드가 임계 구간을 빠져나올 기미가 안 보이더라도 한없이 기다리는 수밖에 없다. 또한 동일한 코드에 대한 스레드 접근만 제어할 수 있지, 다른 스레드(심지어 다른 프로세스)가 임의의 다른 작업을 끝낼 때까지 나의 스레드 실행을 멈추는 식으로 제어를 할 수는 없다.
이쯤 되면 그림이 나온다. 스레드 동기화 기능들을 수행하는 중요한 역할 중 하나는 busy waiting을 없애는 것이다. XT, 286 시절에는 컴퓨터 실행을 좀 느리게 하기 위해서 for i=1 to 5000: next 같은 문장을 썼지만 지금은 그건 큰일 날 짓이다. 자발적으로 일정 시간 CPU 시간을 내어 주고 프로그램 실행을 멈추는 Sleep 같은 운영체제 함수를 써야 한다. 어떤 스레드가 작업을 끝낼 때까지 쉬는 것도, while(bProcessing); 이런 식으로 수도 없이 뺑뺑이를 도는 polling은 절대 피해야 한다.
그렇기 때문에 일정 조건이 만족될 때까지 스레드를 CPU의 사용 없이 자동으로 기다리게 하는 함수가 있으며 이와 관련된 스레드 동기화 오브젝트들이 커널 차원에서 제공된다. “어떤 스레드가 임계 구간을 빠져나갈 때까지”란, 그 조건의 subset일 뿐인 것이다.
커널 오브젝트는 단순 크리티컬 섹션보다는 느리다. 이를 사용하기 위해서는 user 모드와 kernel 모드 사이의 전환 overhead를 감수해야 한다. 하지만 이들은 쓰임이 훨씬 더 범용적이며, 단순한 변수가 아니라 핸들과 이름으로 식별하기 때문에 inter-process하며 시스템 전체에서 통용이 가능하다. (이런 커널 오브젝트의 존재 여부로 프로그램의 중복 실행을 감지할 수도 있을 정도이다.) 크리티컬 섹션은 스레드의 waiting이 아주 implicit하게 일어나지만, 커널 오브젝트는 이를 WaitForSingleObject 같은 함수로 explicit하게 지정 가능하며 기다리는 한도를 제어할 수 있다. 또한 다른 커널 오브젝트들과 덩달아 함께 기다리게 할 수도 있다.
뮤텍스는 크리티컬 섹션의 커널 오브젝트 버전에 가깝고, 세마포어는 임계 구간에 들어갈 수 있는 스레드의 최대 개수를 지정할 수 있어서 뮤텍스보다 더욱 범용적이다.
한편 이벤트는 굳이 임계 구간이 아니더라도 사용자가 임의의 신호를 날려서, 그 신호를 기다리며 잠들어 있던 스레드를 깨울 수 있게 한 원초적이고 general-purpose한 동기화 수단이다.
결국 스레드 동기화 수단이 여럿 등장했는데, 구현 형태는 달라도 결국 여기에 적용될 수 있는 동사는 딱 둘.. ‘잠그기, 풀기’로 요약된다. 그래서 MFC는 이런 것들을 CSyncObject라는 클래스로 요약하여, Lock과 Unlock이라는 가상 함수로 공통 기능을 추상화해 놓고 있다.
참고로 이런 것뿐만 아니라 프로세스, 파일, 스레드 핸들 그 자체 같은 다른 커널 오브젝트들도 동기화 오브젝트에 해당하는 것이 여럿 있다. 그래서 해당 프로세스의 실행이 끝날 때까지, 혹은 스레드의 실행이 끝나고 파일 트랜잭션이 끝날 때까지 프로그램을 기다리게 하는 게 가능하다.
Posted by 사무엘
윈도우 API로 다른 프로그램을 "실행", 즉 기술적으로 말하면 프로세스를 생성할 때 쓰는 함수는 크게 다음과 같다.
WinExec, LoadModule, CreateProcess, ShellExecute
어느 것을 사용하더라도 다음과 같은 정보를 받는 란은 꼭 존재한다:
실행 파일 이름, 명령인자, 그리고 메인 윈도우를 표시할 디폴트 방식(SW_SHOW 등).
즉, 윈도우 운영체제는 GUI 기반이라는 특성상 프로그램 메인 윈도우를 기본적으로 최대화하여 실행하라, 창을 숨겨 놓고 실행하라는 식의 지시를 내릴 수 있다. 이런 정보들은 WinMain 함수의 매개변수로 고스란히 그대로 전달된다. 물론 응용 프로그램이 그걸 무시하면 어쩔 수 없지만.
앞의 W..., L... 두 함수는 매개변수가 매우 단순한 편해서 쓰기는 편하나, 16비트 API 시절의 잔재로 치부되어 유니코드 버전조차 존재하지 않으며, 사용이 비추(discourage)되고 있다.
CreateProcess가 32비트 이상급 윈도우 API에서 표준으로 통용되는 가장 원초적인 프로그램 실행 함수이다. 그 대신 받아들이는 매개변수가 무진장 많으며 쓰기가 좀 어렵다. 여기에 대해서는 뒤에서 다시 좀 다루기로 하겠다.
끝으로 ShellExecute는 그 이름이 암시하듯, 커널 계층이 아닌 쉘이라는 꽤 상위 계층에서 구현된 함수로 단순히 파일을 실행하는 게 아니라 인터넷 URL을 기본 웹 브라우저에서 열거나 텍스트 파일을 메모장에서 여는 일도 다 담당한다. 동작 자체도 "open", "print" 등 아예 명령 문자열로 지정할 수 있다. 즉, 쓰임이 훨씬 더 포괄적이다. 이 함수도 EXE를 실행할 때는, 내부적으로 어차피 CreateProcess를 응당 호출한다.
C...는 리턴값이 프로그램의 실행 성공 여부를 나타내는 BOOL 형태인 반면, 나머지 세 함수들은 값이 약간 특이하다. 32보다 큰 정수를 되돌리면 성공을 뜻하고 그렇지 않으면 실패라는 뜻이다.
왜 이렇게 되었냐 하면 이 legacy 함수들은 원래 리턴값이 "인스턴스/모듈 핸들"이었으며 32 이하의 핸들값은 에러를 나타내는 값으로 의미가 예정되었었기 때문이다. 일종의 과거 잔재이다.
오늘날 윈도우 프로그래밍에서 HINSTANCE라고 부르는 핸들은, 과거에는 프로세스 ID와 비슷한 개념이었다. 이 핸들은 자신이 실행한 파일을 식별하는 정보도 있었던지라 동일 EXE를 중복 실행한 것을 WinMain 함수와 함께 넘어온 hPrevInstance로 분간할 수 있었다. 또한 EXE를 실행하여 생긴 인스턴스 핸들과, 그 EXE 안에서 DLL를 읽어들임으로써 이를 식별하는 모듈 핸들(HMODULE)도 별개의 존재였다.
하지만 32비트로 넘어오면서 운영체제의 메모리/파일 관리 모델이 완전히 바뀌었고 오늘날은 HINSTANCE와 HMODULE의 구분이 완전히 없어졌다. 단순히 프로세스 메모리 공간에 맵핑되어 있는 파일 이미지를 가리키는 포인터일 뿐이다. 메모리 영역 overlap에 따른 재배치만 일어나지 않는다면, 해당 DLL/EXE의 preferred base가 그대로 핸들값이 되는 것이다. 인스턴스 핸들이 이렇게 특정 프로세스 안의 주소 공간을 가리키는 포인터가 되는 바람에(national), 이제 이 핸들로 여러 프로세스들을 식별(international)하는 것은 불가능해졌다.
CreateProcess는 사용자가 보내준 파일 + 명령행 사이에다 null 문자를 잠시 삽입하여 토큰화를 했다가, 함수 실행이 끝난 후 문자열을 원래대로 되돌려 준다. C 언어의 strtok 함수를 떠올리면 된다. 이런 이유로 인해 명령행을 넘겨주는 포인터 영역이 read-only const여서는 안 되며 쓰기가 가능해야 한다. (물론 윈도우 NT 계열 운영체제에서 W 버전이 아닌 A 버전을 호출하면 어차피 쓰기 가능한 메모리 버퍼로 인코딩 변환이 일어나기 때문에 read-only 메모리를 넘겨줘도 문제될 건 없다.)
프로그램을 실행할 때는 이 프로그램에다 기본으로 넘겨 줄 각종 환경 변수, 콘솔 프로그램인 경우 표준 입출력 스트림의 핸들, 디버그 실행 여부 등 갖가지 고급 정보를 넘겨줄 수 있으며,
프로그램이 실행되었을 경우 생성된 프로세스의 핸들과 ID 등도 돌려받게 된다. 가령, 이 프로그램이 실행이 완전히 끝날 때까지 내가 기다려야 할 때 이 핸들에 대해 WaitForSingleObject를 호출하고 있으면 된다는 뜻이다. 단, 이 핸들을 Close하는 것도 우리 책임이다.
불필요하게 높은 계층에 자리잡고 있는 ShellExecute 대신, 커널 계층에 있는 CreateProcess를 좀더 간편하게 활용하기 위해 본인은 이 함수를 클래스로 감싸서 쓰고 있다. OpenFileName, TaskDialogIndirect (윈도우 비스타) 같은 복잡한 대화상자 UI 함수만큼이나 CreateProcess도
- 각종 디폴트 argument나 구조체들 챙기기
- 소멸자에서는 결과물로 받은 핸들들 닫아 주기
- 커맨드 라인을 알아서 자체 버퍼에다 생성하고, 필요한 경우 매개변수 전체를 따옴표로 싸 주기
- 이 프로그램의 실행이 끝날 때까지 기다리는 멤버 함수도 추가.
같은 자질구레한 일을 클래스로 감싸 놓으니, 프로그램 실행하기가 한결 편리하다.
Posted by 사무엘
class CAppFrame: public CWnd {
public:
void PostNcDestroy() { delete this; }
};
class CMyApp: public CWinApp {
public:
BOOL InitInstance();
};
CMyApp g_App;
BOOL CMyApp::InitInstance()
{
m_pMainWnd=new CAppFrame;
m_pMainWnd->CreateEx(0, AfxRegisterWndClass(0), _T("Hello World"), WS_OVERLAPPEDWINDOW,
100, 100, 500, 500, NULL, NULL);
m_pMainWnd->ShowWindow(SW_SHOW);
m_pMainWnd->UpdateWindow();
return TRUE;
}
위의 코드는 MFC를 써서 만들 수 있는 가장 간단한 GUI 프로그램이다. 빈 창만 달랑 뜨는 게 허전하면, message map 넣고 OnPaint에다가 Hello, world! 출력하는 코드만 추가해 주면 된다.
MFC로 창을 띄우기 위해서는 본질적인 것 딱 두 가지만 기억하면 된다.
첫째, CWnd에서 상속 받은 클래스를 만들기
둘째, CWinApp에서 상속 하나 받아서 전역 개체를 하나 반드시 만들고, InitInstance를 오버라이드하여 내 윈도우 클래스를 생성하는 코드를 짜 주기
물론 요즘은 닷넷 프레임워크 같은 더 객체 지향적이고 깔끔한 API도 나와는 있지만 저 정도만 해도 그냥 C언어 + Win32 API만 썼을 때와는 비교할 수도 없이 간단하게 내가 원하는 일을 곧장 시작할 수 있다. 윈도우 클래스 등록, 윈도우 프로시저 등 온갖 지저분한 내부 처리를 상당 부분 MFC가 알아서 해 주기 때문이다.
MFC의 핵심부이며 가장 자주 다루게 되는 부분은 역시 윈도우를 나타내는 CWnd 관련 개체이다. 응용 프로그램의 메인 윈도우부터 시작해서 대화상자와 대화상자 안의 자그마한 컨트롤까지 매우 다양한 용도로 쓰이는 HWND를 한 뿌리 클래스와 상속 클래스만으로 원활히 제어하기 위해 MFC는 굉장히 심도 있게 설계되었으며 내부적으로 자질구레한 일들을 매우 많이 해 주고 있다. 단순히 ShowWindow(hWnd, SW_SHOW)를 wnd.ShowWindow(SW_SHOW)로 바꿔 주는 것을 훨씬 넘어서는 수준이다.
더구나 메시지 맵을 통해 컨트롤 서브클래싱(기존 윈도우 컨트롤의 동작을 부분적으로 조작하는 것)까지 매끄럽게 연결시킨 것까지 보면, 솔직히 굉장히 잘 만든 프레임워크임을 인정하지 않을 수 없다.
이런 프레임워크를 만들 때 근본적으로 문제가 되는 것은 CWnd라는 C++ 오브젝트와 운영체제의 HWND 사이의 씽크를 맞춰 주는 작업이다. 둘은 원래 개념적으로 생성 주기나 scope이 서로 완전히 다른 존재이다. 하지만 MFC는 한 HWND를 가리키는 CWnd 오브젝트가 중첩되지 않도록 배려하고 있으며, 나의 C++ 코드에 의해 생성되지 않은 외부 HWND에 대해서도 임시 맵까지 만들어 가면서 CWnd를 동기화해 주고 있다. 멀티스레드 환경까지 감안하면 이는 더욱 복잡한 작업이 된다.
new 연산자로 CWnd가 생성될 때 CreateWindow를 같이 해 주고, HWND가 완전히 소멸되어 WM_NCDESTROY가 왔을 때 CWnd까지 delete로 지워 주는 것은 대부분의 경우엔 바람직한 디자인 패턴이나, 이것이 언제나 유용한 것은 아니다. 가령 modal 대화상자는 자체적으로 message loop까지 갖추고 있기 때문에 heap이 아닌 스택에다가 간단히 지역변수로 선언하는 경우가 더 유용하기 때문이다. 더구나 대화상자는 사용자가 대화상자를 닫았더라도, 이 C++ 클래스 갖고 있는 데이터 변수들을 후에 활용하는 경우가 많기 때문에 HWND 개체가 사라진 뒤라도 C++ 개체는 남아 있어 줘야 한다.
이래저래 CWnd와 HWND 사이의 관계와 생성/소멸 주기는 여러 모로 이해하기 까다롭다. CWnd 클래스 중에서 new로 생성되고 HWND의 소멸과 동시에 소멸되어야 하는 오브젝트라면, PostNcDestroy 함수를 오버라이드하여 delete this를 넣어 주어야 메모리 누수가 발생하지 않는다. 응용 프로그램의 주 프레임 윈도우라든가 modeless 대화상자가 이런 예에 속한다.
저 소스 코드에서는 CWnd를 날것으로 사용했지만, CWnd에서 파생되어 아예 전문적으로 응용 프로그램의 주 프레임 윈도우를 담당하고 있는 MFC 클래스인 CFrameWnd는 PostNcDestroy가 이미 저렇게 구현되어 있다. 그뿐만 아니라 이 클래스는 LoadFrame 함수에서 이미 윈도우 클래스의 등록까지 다 알아서 해 주기 때문에 저 소스 코드에서처럼 AfxRegisterWndClass를 번거롭게 호출할 필요도 없다. 사용자가 준 ID와 일치하는 응용 프로그램 타이틀, 아이콘, 심지어 단축키 액셀러레이터 테이블 따위를 모두 엮어서 윈도우의 기반을 자동으로 구성해 주기 때문이다.
MFC를 써서 아주 간단한 프로그램을 짜고 싶은데 비주얼 C++의 MFC 마법사가 기본으로 생성해 주는 코드는 군더더기가 너무 많다. 그래서 이럴 때 본인은 MFC 없이 일반 Win32 응용 프로그램으로 프로젝트를 시작한 후, 저 코드 템플릿을 갖다 붙이고 프로젝트 세팅을 “MFC 사용”으로 수동으로 바꾸는 방법을 쓴다.
필요한 건 MFC가 잘 캡슐화해 준 message loop, 몇몇 GDI 오브젝트 같은 것밖에 없는데 이것만 쓰기에는 MFC는 덩치가 너무 커지고 static link를 하기에도 오버헤드가 너무 큰 것도 불만이다. 차라리 known DLL만 쓰기 때문에 매우 가벼운 바이너리를 만들 수 있는 비주얼 C++ 6.0이 그리울 때도 있다. 어차피 이후 버전에서 추가된 기능은 거의 안 쓰기 때문에.
<날개셋> 타자연습은 소스를 보면 알겠지만 딱 MFC를 써서 개발되었다. 하지만 한글 입력기는 3.0부터 MFC를 쓰지 않으며, 믿거나 말거나 MFC를 어설프게 흉내 내어 본인이 내부적으로 자체 개발한 프레임워크 라이브러리를 static link하여 개발해 오고 있다. 하지만 자체 라이브러리는 오버헤드 줄이고 최대한 가볍게 만드느라, Win32 API라든가 각종 핸들을 캡슐화한 수준이 MFC 수준으로 범용적이고 체계적이고 편하지는 못하기 때문에, 여전히 MFC가 그리울 때가 있다. ^^;;
Posted by 사무엘
Posted by 사무엘
그런즉 이제 애호박, 단호박, 늙은호박 이 셋은 항상 있으나, 그 중에 제일은 늙은호박이니라.
- 사무엘
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |