« Previous : 1 : 2 : 3 : 4 : 5 : ... 32 : Next »

※ 10.0 (2010)

사용자 삽입 이미지

2008 이후 2010도 참 걸출한 작품이었다.
IDE가 MS Office 엔진이 아닌 WPF 기반으로 다시 만들어졌으며, 프로젝트 파일은 현재처럼 확장자에 x자가 붙고 내부 형식이 미묘하게 달라졌다. IDE와 툴체인 및 SDK 간의 분리가 가능해지고 융통성이 생겼다.
인텔리센스 엔진이 구닥다리 ncb 파일을 버리고, 전문적인 백그라운드 컴파일러와 DB 엔진을 기반으로 전면 개편됐다. 덕분에 정확도가 6.0이나 200x 시절보다 훨씬 더 향상됐다. 그리고 이제 #include 헤더 파일에 대해서도 우클릭해서 '요 파일 열기'가 가능해졌다.

CRT와 MFC DLL에 대해 side-by-side assembly 강제 정책은 철회됐으며... C++11 문법이 초보적인 수준으로나마 도입됐다. R-value 참조자 &&라든가 auto 람다 함수를 쓸 수 있게 됐다.
다만, 내 개인적으로는 시퍼런 IDE 외형이 좀 구리고 이질적으로;; 느껴진다. 그리고 UI 요소를 customize할 때 toolbar의 폭을 마우스 드래그가 아니라 픽셀수 숫자로 입력한다던가(뜨악~);; 몇몇 UI 기능은 200x시절보다 불편해졌다.
그게 오늘날 202x까지 개선 없이 그대로 이어지고 있다. 개발 우선순위가 낮아서 그런지 이런 것까지 살펴볼 여유가 없는가 보다.

※ 2012 (버전 11)
사용자 삽입 이미지

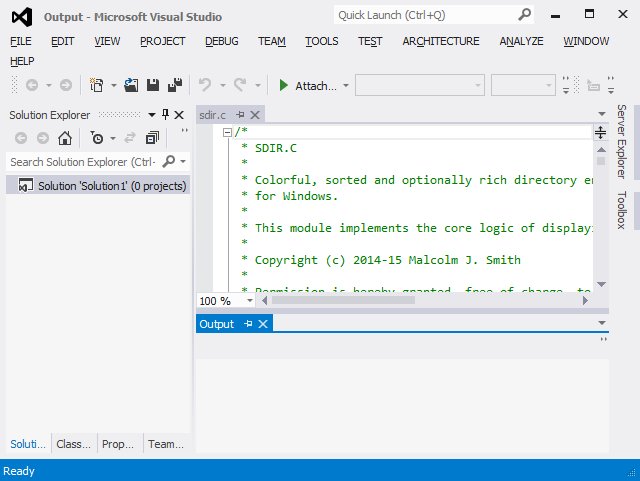
얘는 일단 IDE의 외형이.. 그 시절 유행하던 Windows 8 metro 디자인 물을 먹었는지 아주 새끈한 은백색 풍으로 바뀌었다. 프로그램 창에서 caption이나 border 같은 non-client 영역까지 전부 운영체제의 표준 외형을 벗어난 첫 버전이 바로 2012이다.

개발툴로서는 같은 최적화 세팅에서 컴파일 속도가 2010보다 더 빨라졌고.. 정적 분석이 bundle로 제공되기 시작했다.
신택스 컬러링도 예전보다 더 컬러풀해져서 #define, typedef, num 등이 모두 구분되어 나오기 시작했다.
#if에 걸려서 컴파일되지 않는 부분이 흐려지기 시작한 건 2010부터인지 2012부터인지 모르겠다. 200x는 확실히 아니었음..

그리고 이 버전부터 서비스 팩이라는 게 없어지고 update N 이렇게 명칭이 바뀌었다. 마소 제품들은 2010년을 전후한 Windows 7, Office 2010, Visual Studio 2010이 서비스 팩이란 게 존재했던 마지막 버전이었다.
로컬 하드에 설치 저장되던 방대한 규모의 MSDN 레퍼런스도 이때부터 사실상 없어졌다.

※ 2013 (버전 12)

2012 이후로 겨우 1년 남짓 만에 메이저 버전이 또 올라갔다. 마치 Windows 8과 8.1의 관계인 것 같은데..

얘는 C++11 문법 지원이 더 강화된 것, 그리고 무엇보다 Express 에디션 대신, 개인/인디 개발자를 위한 Community 에디션이 도입된 것이 크게 기억에 남는다.
Community 에디션은 5인 이하, 매출 얼마 이하의 소규모 인디 개발자이기만 하면 무료로 사용 가능하다. Express에서는 봉인돼 있던 MFC고 x64고 다 사용 가능하다. 2010년대의 컴퓨팅 환경에서 MFC는 몰라도 이제 x64 타겟을 만들 수 없다는 건 어불성설이 됐으니까..

뭐, Visual Studio만 그런 건 아니겠지만 요즘 버전들은 시리얼 번호 입력이란 게 없이 바로 설치 가능하다. 그 대신 실행 후에 마소 계정 로그인이 필요해졌을 뿐이다. 선설치, 후접속 결제인 듯..

※ 2015 (버전 14)

얘는 CRT 체계가 Windows 10 스타일로 전면 개편된 것이 가장 중요하다. 이때부터 지금까지 툴체인의 메이저 버전이 14, _MSC_VER 값도 19xx대로 변함없이 유지되고 있기 때문이다. vcruntime140, mfc140, msvcp140 말이다. Visual Studio의 버전만 올라가지, 툴체인은 메이저 버전이 올라가지 않기 시작했다.

그리고 2010 시절에 전면 개편됐던 인텔리센스 겸 심벌 browse DB의 내부 구조도 2015의 어느 업데이트 때부터 야금야금 바뀌었다. 원래 *.sdf 파일을 쓰던 게 *.VC.db 라고 바뀌었으며, DB 엔진도 자기네 Microsoft SQL Server Compact edition을 쓰던 게 SQLite로 교체됐다. 이것도 오늘날까지 이어지는 꽤 중요한 변화이다.
2015 이전 버전은 Visual Studio를 설치하면서 MS SQL server 2008이니 어쩌구가 야금야금 같이 설치됐던 반면, 현재는 그런 관행이 없어졌다.

※ 2017 (버전 15)
사용자 삽입 이미지

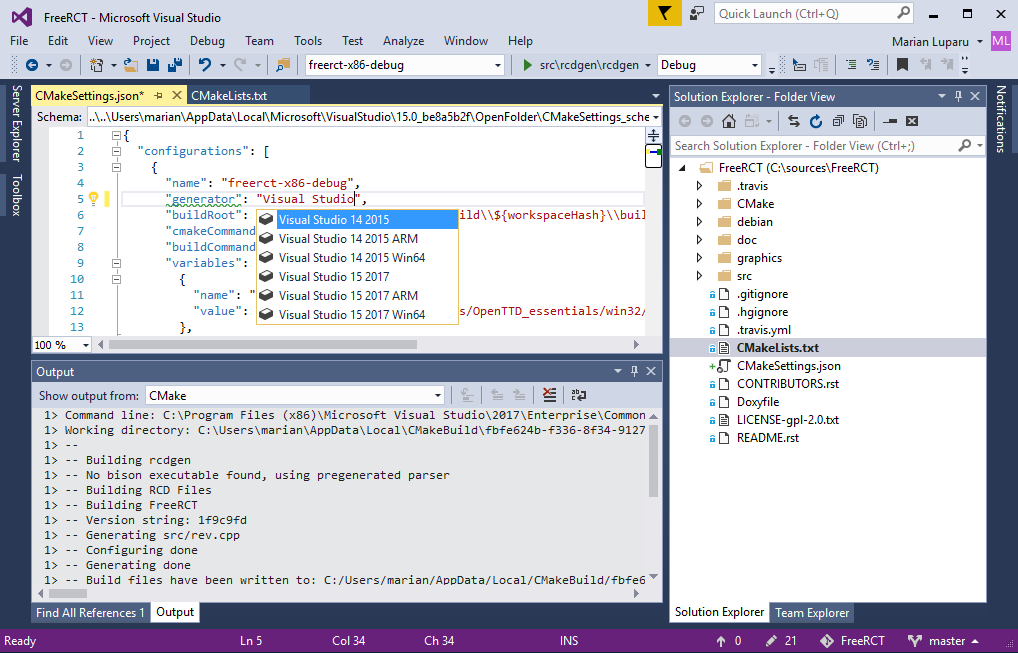
얘는 프로그램의 설치 및 업데이트 시스템이 현재 형태로 전면 개편된 최초의 버전이다. 소규모 업데이트도 워낙 잦아지니 지금처럼 버전 번호에 숫자를 하나 더 추가하는 형태로 바꿨다. (그러므로 Update N라는 표기는 2012부터 2015까지만 사용된 셈..)
IDE의 기본 색상도 흰색이 아니라 약간 연보라색 같은 파란색.. 지금과 비슷해졌다. 이렇게 2010년대 전반부 버전과 후반부 버전 사이의 차별화가 진행됐다.

세월이 세월이니 C++14 문법과 라이브러리도 야금야금 도입됐다. 가령, unique_ptr뿐만 아니라 make_unique도 사용할 수 있게 됐다. 일반적인 함수뿐만 아니라 매크로 함수나 람다에다가도 가변인자를 넣을 수 있게 됐다.

※ 2019 (버전 16)
사용자 삽입 이미지

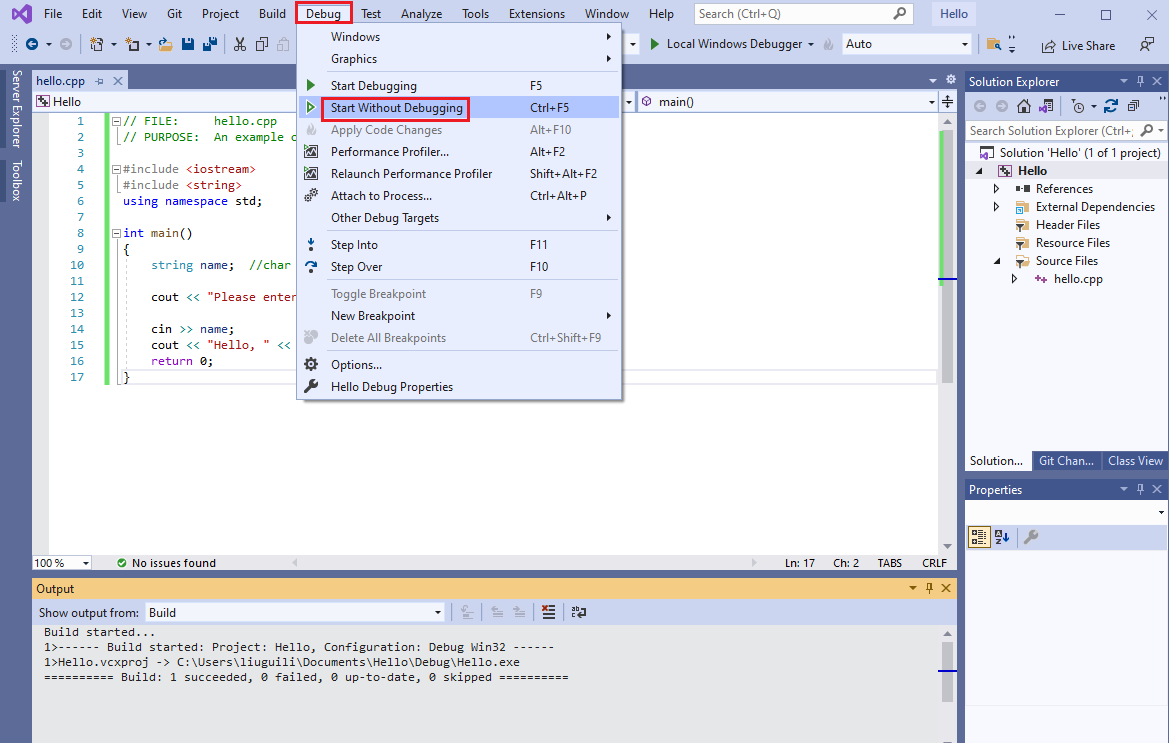
IDE의 색상에 연보라색이 2017보다 더 가미되어 채도가 올라갔다. 2017은 제목 표시줄에 Visual Studio라는 이름이 있었지만 2019부터는 그게 빠지고 최상단에 메뉴가 바로 표시되기 시작했다.
2019의 초창기 버전은 내 기억으로 win32 대화상자 리소스를 편집하던 중에 IDE가 잘 뻗기도 했었다. 여러 업데이트를 거치면서 그 버그는 다행히 고쳐졌다.

아 참, 이 2019 시기에.. 마소의 C++ 라이브러리에 꽤 흥미로운 변화가 생겼다.
Visual C++은 200x 시절부터 전통적으로 Dinkumware 사의 STL을 라이선스 받아 공급해 왔으며, 이 때문에 헤더 파일의 뒷부분에 언제나 P. J. Plauger라는 제작자와 제작사 이름이 들어가 있었다. 그랬는데 마소에서는 2019 하반기부로 이 라이브러리를 오픈소스화하고 자체 관리하기 시작했다. 그러면서 Dinkumware 관련 copyright 문구가 사라졌다.
사실, C++ 라이브러리는 갈수록 언어 구조에 종속적이고 내부 구현도 컴파일러 제조사의 재량에 종속적인 형태로 바뀌어 가는 게 요즘 추세라고 한다.

※ 2022 (버전 17)
IDE 자체가 드디어 64비트로 포팅됐다...!! 이걸로 끝..???

※ 2026
테마가 자매품인 Visual Studio Code 급으로 엄청 다양해지고 휘황찬란해졌다는 것밖에 아직 확인을 못 했다.;;

이상이다.
개인적으로 날개셋 한글 입력기의 개발이나 직장 현업 용도로 진지하게 오래 써 본 버전은 6.0, 2003, 2010, 2012, 2019, 2022 정도이다.

(1) Browse info에 대해

Visual C++은 아주 초창기 시절부터, 빌드 때 겸사겸사 browse info를 같이 생성하는(.sbr, .bsc) 기능이 있었다.
물론 이건 빌드 시간과 디스크 공간을 추가로 소모하는 작업이기 때문에 사용자가 원해서 옵션으로 지정했을 때만 수행한다. 지금도 프로젝트 설정 대화상자를 열어보면 C/C++의 아래에 Browse info라는 카테고리로 당당히 남아있다.

하지만 오늘날은 매번 빌드하지 않고도 IDE에서 소스 코드의 심벌을 실시간으로 조회하는 기술이 눈부시게 발달했다. 그렇기 때문에 이 browse info 기능은 완전히 과거 레거시가 돼서 거의 쓰이지 않는 기능이 됐다. 다만, 업계에서 이 sbr/bsc 파일을 이용해서 다른 분석을 하는 3rd-party 툴 제품이 있기는 하다고 한다.
오늘날은 소스코드를 컴파일하는 과정에서 '덤'으로 할 만한 작업은 정적 분석인 듯하다. 허나, 이젠 그마저도 on-the-fly로 수행돼서 의심 지점을 소스코드의 밑줄로 쫙 쳐서 표시하는 경지에 이르렀다.

(2) 버전 체계에 대해

Visual C++은 버전 관리 체계가 생각보다 복잡하다. 크게 세 가지 버전 시스템이 있다.

- Visual Studio IDE 자체의 버전: Help - About 대화상자에서 볼 수 있는 그 버전이다. 새로운 연도 브랜드가 출시될 때마다 메이저 버전 번호가 1씩 올라간다. 6.0 이후로 2010의 버전은 10이었고, 2015는 14, 2022의 버전은 17까지 올라갔다. 버전 13은 건너뛰었다.

- 툴체인의 버전: 오랫동안 Visual C++ IDE의 버전과 동일하다가(13을 skip한 것까지) 2015 및 Windows 10 때부터 14에서 멈췄다. CRT/MFC DLL의 ABI와도 버전이 연계되는지, 현재는 마이너 버전만 쭉 올라가고 있다. 프로젝트 세팅의 '플랫폼 도구 집합'에 해당한다.

- 컴파일러의 버전: cl.exe를 실행했을 때, 또는 소스 코드에서 _MSC_VER의 값을 넣어서 확인 가능한 버전이다. 얘는 Visual C++의 전신인 Microsoft C/C++의 버전값을 승계했기 때문에 Visual C++ 1.0 시절에 이미 800부터 시작됐다. MS C/C++의 마지막 버전이 7이었고, VC++ 1은 MS C/C++ 8과 같다고 간주됐기 때문이다.
다만, Visual C++ 2에서 4로 넘어갔을 때는 값이 200이 아니라 100만 늘었다. VC++ 6의 컴파일러 버전은 500이 아니라 400이 증가한 1200이었다. (12.0)

그 뒤 IDE의 버전이 14인 2015에서는 800이 아니라 700이 증가한 19.0에 도달했고(13 skip이 없으므로), 이때부터는 툴체인의 버전과 마찬가지로 메이저 버전의 번호가 오르지 않고 있다.

Posted by 사무엘
2026/10/11 08:35 2026/10/11 08:35
, , ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2471

* 무려 2010년쯤에, 2008 버전이 최신이었던 시절에 썼던 글을 내용을 보강하고 업데이트 하여 다시 올렸다. 심지어 분량이 엄청나게 늘어나서 글을 둘로 나눴다.

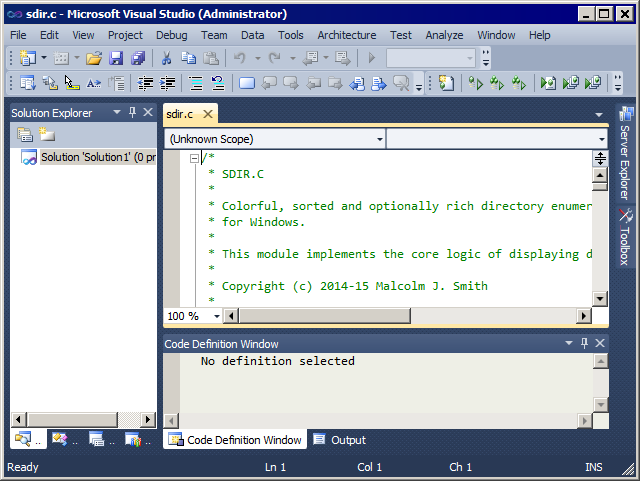
※ 1.0

사용자 삽입 이미지
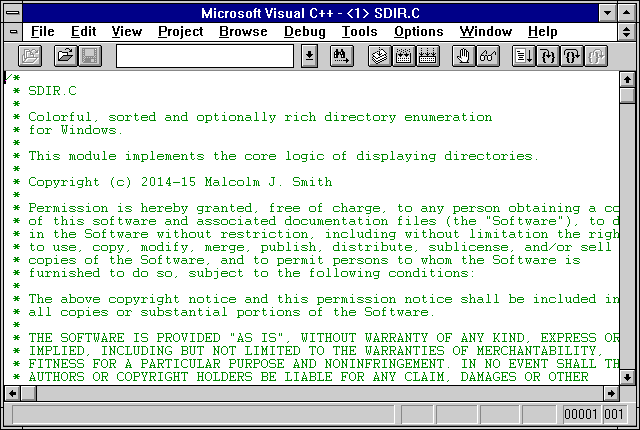
(스샷의 출처는 Malcolm Smith (malxau)이라는 분의 유명 홈페이지)

1993년에 출시된 Visual C++ 1.0은 Microsoft C/C++ 7.0의 차기 버전 겸 Windows NT 전속 개발툴 역할을 하기 시작했다. 이웃 BASIC 팀에서 MS Basic PDS 7의 다음 버전이 Visual Basic이라고 선례를 남겼으니, C/C++ 팀도 비슷한 작명을 도입했던 게 아닌가 싶다. BASIC은 RAD 툴로 바뀌었고 C/C++은 32비트로 갈아탔다.

물론 이때는 16비트에서 32비트로 한창 넘어가는 과도기였기 때문에 Win32s 타겟이 지원되기도 했다. 그리고 Win32s가 아닌 순수 16비트용 에디션도 나중에 출시되기는 했다. (VB 1도 Windows용 이후에 DOS용이 따로 출시됐듯이..) 하지만 VC++ 16비트용은 개발 계보가 32비트 에디션과는 상이했다.

32비트 환경에서는 메모리 모델 구분이 없는 대신, CRT에 링크 방식(static/DLL)과 멀티스레드 지원 여부라는 속성이 새로 도입되었다.
참고로 Visual Basic은 1996년엔가, 버전 4에서야 32비트가 도입됐다는 것도 기억할 점이다. 16/32비트 에디션이 따로 나왔으며, VB5부터는 32비트 전용으로 바뀌었다.

※ 1.52

얘는 16비트 Windows를 정식 지원하는 마지막 버전이어서 매우 중요하다.
프론트 엔드 IDE는 모두 16비트 Windows 프로그램인 반면, 커맨드 라인에서 동작하는 컴파일러, 링커 같은 주요 툴들은 도스 익스텐더 stub을 내장하고 있는 32비트 PE 포맷인 점이 무척 인상적이다.

※ 2.0

이제부터 완전히 32비트 전용으로 바뀌었다. 하지만 이때는 아직 Windows 95가 나오기도 전이고 NT는 인지도와 점유율이 아주 미미했었다. 그래서 VC++ 역시 아직까지는 별 존재감이 없고 주목을 못 받았다. 아직까지는 16비트 Windows에서 볼랜드의 OWL 라이브러리도 쌩쌩히 현역이었다.

Windows 95의 워드패드가 바로 듣보잡 MFC 3.0 기반이었는데, 이게 Visual C++ 2.0의 흔적이다.
그리고 이 시절 Visual C++ RISC edition 어쩌구 하던 건 Windows CE가 아니라 NT를 염두에 둔 타겟이었다. 이건 eMbedded Visual C++과는 다른 제품군이었다.

※ 4.0

사용자 삽입 이미지

DirectX에는 4라는 버전이 없듯, Visual C++에는 3.x대 버전이 없다. 내부적으로 꾸준히 버전업이 돼 온 MFC의 버전 번호에 맞춰 곧바로 4.0으로 건너뛰게 된다.
VC++ 4.0은 Windows NT뿐만 아니라 정통 95용 32비트 프로그램을 만들 수 있다는 이점으로 인해 인지도가 급격히 올라갔다. IE가 넷스케이프를 제쳤듯이 Visual C++이 Borland C++을 제치기 시작했다.

4.0에 와서야 비로소 IDE가 오늘날의 Visual C++과 비슷한 골격이 갖춰졌다. 즉 코딩, 리소스 편집, 클래스 마법사, 도움말 열람을 모두 한 프로그램에서 할 수 있는 진정한 통합 환경 Developer Studio가 이 버전부터 생겼다.
msdev.exe라는 프로그램 이름은 훗날 6.0까지 이어졌다. MFC ClassWizard라든가, ClassView도 이때 도입됐다.

※ 4.2

4.1을 거쳐 4.0이 마이너 업그레이드된 버전으로, 제법 인지도를 얻었다. ActiveX 컨트롤, STL 같은 기능이 추가되고 MFC DLL의 이름도 이때부터 MFC42로 이름이 바뀌어 큰 뼈대의 변경 없이 훗날의 6.0까지 이어졌다. MFC42는 윈도우 98 이래로 운영체제가 이제 known DLL로 인정하는 마지막 버전 숫자이기도 하니 더욱 의미가 있다.

4.2에서부터 Win32s의 지원이 중단되었다. 오죽했으면 설치할 때 “이 버전부터 Win32s를 더 지원하지 않으니, 그 환경 개발하고 싶으면 이거 설치하지 말고 옛날 버전 쓰셈!”이란 경고문까지 나온다.

※ 5.0

사용자 삽입 이미지

얘와 6은 도구모음줄과 메뉴가 MS Office 97 스타일로 바뀌었다. 다만, 5는 도움말은 여전히 RTF 기반이고 인텔리센스도 아직 없었다.
외형뿐만 아니라 내부 기능도.. 한번에 여러 프로젝트들을 담을 수 있는 workspace 개념이 이때 도입됐다. 단, dsw/dsp라는 파일 포맷 자체는 5와 6 두 버전에서만 쓰이고 이후 버전에서는 또 바뀌게 되었다.

몇몇 C++ 최신 표준이 반영되어 bool이 built-in type으로 지원되기 시작했다. 그리고 이때부터 빌드하는 EXE 파일에 PE 재배치 정보가 기본적으로 생략되었으며.. 그 유명한 Rich 시그니처가 슬쩍 들어가기 시작했다.
다만, 이 5.0은 이듬해에 나온 6.0에 밀려 존재감을 완전히 상실했다. 뭔가 아래아한글 97이 나오기 전의 96이 묻혀 버린 것과 비슷하달까?

※ 6.0

개발툴계의 Windows XP 같은 만수장세 결정판이었다. 이 버전 이후로 거의 4년 가까이 버전업이 없었고, 다음 버전인 닷넷이 변화폭이 너무 크기도 했기 때문이다.

6에서는 인텔리센스(초보적인 수준), edit and continue, delay-loaded DLL 같은 획기적인 기능이 처음으로 추가되고 도움말이 별도의 MSDN 라이브러리로 독립함과 동시에 HTML 기반으로 모두 바뀌었다.
이 버전은 윈도우 9x에서 설치 가능한 마지막 버전임과 동시에 MSVCRT, MFC42 같은 known DLL만 사용하는 바이너리를 생성할 수 있는 마지막 버전이기도 하다. 주요 라이브러리를 DLL 링크하고도 DLL 배포 걱정을 할 필요가 전혀 없다는 장점이 있다.

4.2 때는 ClassView에 있는 각종 클래스, 변수 정보가 소스 파일을 매번 저장할 때에만 업데이트됐다. 이것이 내용이 바뀔 때마다 실시간으로 바뀌기 시작한 것도 5.0은 아니고 6.0부터인 걸로 기억한다.
Visual C++이 C++ 표준을 준수하지 않는다고 비판이 많긴 했지만, 라이브러리의 헤더 파일에서 .h 확장자가 없어지고 namespace std가 도입된 건 6.0부터였지 싶다.

※ 7.1 (2003)

사용자 삽입 이미지

Visual C++의 다음 버전은 처음엔, 버전 번호나 연도가 아닌 닷넷이라는 브랜드로 출시되었다.
MFC를 써서 개발된 VC 특유의 전통적인 msdev.exe는 퇴출되고 devenv라는 MS Office 내지 VB 스타일의 IDE가 등장했됐다. 이는 완전히 새로운 것이라기보다는 예전에 Visual Studio에 있던 Visual InterDev와 비슷한 형태였다. 단지 거기에다 외형만 MS 오피스 XP 스타일 UI를 그대로 물려받았다.

덕분에 Visual C++과는 영 인연이 없고 VB만의 전유물인 것 같던 Property grid가 도입되어 Visual C++ IDE 특유의 납작한 등록정보 대화상자를 대체했다. 클래스 마법사도 이 형태로 대체됐다. 도움말은 5.0 시절처럼 IDE 내부에 띄울 수도 있고 6.0처럼 외부에 띄울 수도 있는 융통성 있는 형태로 바뀌었다.
dsw/dsp 대신, sln(솔루션)과 vcproj 요렇게 프로젝트 파일의 확장자와 포맷이 바뀌었다.

이제 주류로 내세운 게 C#, 공용 언어 런타임 같은 닷넷 환경이긴 했지만 네이티브 C/C++ 쪽도 크게 향상되었다. 네이티브 wchar_t 형식이 지원되기 시작했다.
6에서 첫 도입됐던 인텔리센스도 굉장히 강력해져 특히 #define 매크로 심볼에 대해서도 동작하기 시작했다. 별도의 browse info를 만들지 않아도 선언/정의로 가기 기능을 바로 사용할 수도 있게 됐다. 닷넷 정도만 써 보면 이제 6.0은 충분히 열악함을 느끼기에 충분할 것이다.

64비트 크로스컴파일은 불가능하지는 않으나 불편하고 디버깅도 되지 않고 IDE 차원의 적극적인 보조는 못 받는 어정쩡한 위상을 차지하고 있다. 이 불완전한 면모들은 후속 버전인 8에서 보완되었다.

참고로.. 2003 이전, 2002년에 Visual Studio .NET이라는 이름으로 먼저 출시된 버전 7.0은 정말 놀라울 정도로 존재감 없이 신속히 잊혀졌다.
글쎄, 6.0 이후로 오랫동안 버전업이 없다가 닷넷과 CLR이라는 걸 도입한 첫 버전이니 너무 불안정하고 버그가 많았던 걸까? 저 제품에 대해서는 내가 아는 게 없다. 금세 .NET 2003 (7.1)으로 대체됐다.

※ 8.0 (2005)

얘도 생각해 보니 변화가 굉장히 많았다.
for 문의 변수 scope처럼 그동안 Visual C++ 컴파일러가 표준을 어기고 있던 문법을 교정했으며.. 멀티코어를 표방했는지 빌드 로그에 코어 번호가 왼쪽에 표시되기 시작했다.
CRT의 보안이 이때 크게 강화됐다. strcpy_s와 gets_s(대상 버퍼 크기), qsort_s(콜백 함수에 데이터 전달 가능), strtok_s(토큰 중복 호출 가능) 같은 함수가 새롭게 등장하고 strchr 같은 경우, C++에서는 const 포인터를 되돌리는 버전과 비const 포인터를 되돌리는 함수가 오버로딩으로 분리해 나갔다. 무척 신선한 변화라 느껴진다. STL 디버깅도 훨씬 더 편해졌다.

이 버전부터 별도의 플랫폼 SDK를 설치할 필요 없이 IDE 차원에서 x64 타겟 빌드와 디버깅이 정식 지원되기 시작했다.
그리고 이때 MSVCR80, MFC80의 배포 방식이 side-by-side assembly 방식으로 완전히 바뀌었다. 이와 덩달아, 리소스 편집기로 수동으로 해야 하던 메니페스트 생성/편집 기능도 상당 부분 자동화됐다.
이 버전부터는 생성하는 프로젝트의 디폴트 기반 인코딩이 드디어 유니코드로 바뀌었다.

UI 상으로도 이제 MS 오피스 스타일에서 독립한 새로운 외형 비주얼을 갖기 시작했으며, 도구모음줄 아이콘도 256색으로 더 화려해졌다. 전통적으로 ClassView에 클래스와 멤버들이 한 트리에 쫙 나열되던 것이 멤버는 별도의 리스트에 뜨도록 바뀌기도 했다. 도킹 창을 드래그할 때 나타나는 도킹 다이아몬드도 2005에서 첫 도입된 물건이다.
Visual Studio의 무료 에디션인 Express 에디션이 이때 첫 도입됐다. (무료이지만 MFC 없고 64비트 타겟도 미지원)

※ 9.0 (2008)

8이 질적으로 많이 바뀌었다면 9는 Windows Vista의 등장처럼 8 출시 이후에 생긴 변화를 IDE나 MFC 라이브러리 같은 데에 적극 반영하여 양적인 향상을 꾀했다. 일단 MS Office 스타일의 GUI를 손쉽게 만들 수 있는 feature pack을 MFC에 드디어 도입했다.
그리고 2005는 설치하려면 sp1에, Vista 지원 패치.. 등 덕지덕지 땜빵을 해야 할 게 많았는데 2008은 그걸 당연히 모두 기본 접수했다.

Windows Vista에서 도입된 시작 주소 랜덤화 기능이 요 2008에서 정식 추가됐다. 2008에서는 이 보안 기능을 사용하는 EXE를 만들 수 있다는 뜻이다.
10여 년 전, 5.0에서 누락되기 시작한 EXE의 재배치 정보가 2008부터는 기본적으로 다시 들어가기 시작했다. 옛날에는 fixed address를 지원하지 않는 win32s와의 호환 때문에 그게 필요했었지만, 지금은 보안 기능 때문에 필요해진 것이다.

2008은 설치하기 위해 Windows XP 이상을 요구하며(2000 지원 중단), 지원하는 타겟 플랫폼에서도 Windows 9x는 공식적으로 완전히 제외됐다. 링커 옵션에서 바이너리의 최소 요구 운영체제 버전이 4에서 5로 껑충 뛰었고, 이보다 낮은 값은 지정 자체가 안 된다.
또한 single threaded CRT 라이브러리 옵션도 없어졌다. C 라이브러리는 이제부터 무조건 multi threaded이다.

Posted by 사무엘

2026/10/07 19:35 2026/10/07 19:35
, , ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2470

1. 클래식 16비트 DOS 기반 Windows: x86 하에서 여러 모드 존재

초창기 16비트 Windows는 DOS로 부팅된 컴퓨터에서 추가로 실행되던 운영환경 프로그램이었다. 자신만의 하드웨어 인식 모델, 자신만의 API, 자신만의 실행 파일 포맷이 있었지만 자체적으로 컴퓨터를 부팅시킬 능력은 없었다.
그 MS-DOS가 x86 전용이었으니 Windows도 자연스럽게 x86 전용으로 출발했다. 그 대신 그때는 x86 계열 CPU 자체가 시시각각 성장하고 변모하고 있었던지라, Windows도 그에 맞춰 다양한 실행 모드를 지원했다.

8086 real mode, 80286 standard 모드, 그리고 80386 enhanced 모드.
1.0이야 당연히 8086 real에서 시작했다. 주 메모리 최대 640KB밖에 지원을 못하는 초 열악 모드.
그러다가 Windows 2.x 시절에는 Windows/286, Windows/386 에디션이 추가로 도입됐는데.. 이거 마치 옛날에 아래아한글이 1.x 시절에 도트 프린터 에디션, 레이저 프린터 에디션을 세분화했던 것과 비슷한 느낌이 든다.;;; (폰트)

그러다가 Windows 3.0에서는 한 프로그램에서 세 에디션이 모두 같이 제공되기 시작했다.
286 표준 모드에서는 80286에서 추가된 보호 모드를 활용하여, 컴터의 메모리를 더 많이(최대 24비트, 16MB) 끌어다 쓸 수 있었다. 그리고 도스창을 연 상태에서도 백그라운드에서 딴 프로그램과의 멀티태스킹이 가능해졌다.
386 확장 모드에서는 그에 덧붙여 가상 메모리(스왑 파일 페이징)까지 더 끌어다 쓰고, 도스창을 여러 개 동시에 만들 수도 있게 됐다.

즉, Windows 3.x의 386 확장 모드는 여전히 16비트 코드 기반이지만 80386 CPU의 기능을 일부 활용했던 모드였다.
여기에다가 Win32s가 도입되고 커널이 통째로 Windows 9x로 바뀐 과정은 참 드라마틱하게 그지없다. DOS는 Windows를 띄워 주는 하부 인프라가 아니라, Windows 안에서 돌아가는 샌드박스로 위상이 바뀌었다.
수많은 DOS용 프로그램과의 호환성을 최대한 유지하면서, 또 저사양 똥컴에서의 성능도 최대한 살리면서 DOS를 도태시키는 길은 멀고도 험난했다;;

2. 1990년대 Windows NT: x86 + MIPS, Alpha, PowerPC

저런 클래식 Windows와 달리, Windows NT는 DOS와는 완전히 동떨어진 별세계 신세계 이상향을 추구했다.
x86은 지원하는 여러 CPU 중 하나일 뿐이며, 처음부터 100% 32비트 기반으로 동작했다. 지저분한 DOS나 16비트 호환성 따위는 우선적으로 고려하지 않았다.
실행 파일 포맷도 Portable Executable이라고 새로 제정하고.. 노는 물이 정말 완전히 달랐다.

Windows NT는 초창기에 x86뿐만 아니라 MIPS와 DEC Alpha를 추가로 지원해서 UNIX 일색이던 워크스테이션 시장에 도전장을 내밀었다. 원래 제일 처음 계획은 인텔 i860을 지원하는 것이었으나, 이건 모종의 사정으로 인해 이뤄지지 못했다.
NT 3.51부터 4.0 sp2까지 잠깐 동안은 PowerPC까지 추가로 지원했다. 그 당시 매킨토시가 돌아가던 그 CPU가 맞다. 물론 PC와 맥은 CPU 말고도 컴퓨터 하드웨어 규격이 매우 달랐기 때문에, 저런다고 맥에서 Windows NT PPC 에디션을 돌릴 수는 없었다.

Windows가 x86과는 특성이 상극인 RISC 구조에, 심지어 big endian인 CPU에서도 이식되어 돌아간 적이 있었다니.. 지금으로서는 참 믿어지지 않는다.
Windows NT의 개발 본진은 DEC Alpha에 가까웠다. 심지어 Alpha는 64비트 CPU이기도 했으나.. NT 3~4는 그냥 32비트 ABI를 그대로 사용했다. 이 Alpha의 후대 버전은 Windows가 진짜 64비트로 포팅되던 시절에 테스트 장비로도 쓰였다고 한다.

물론 이상향을 추구한 것에는 댓가가 따랐다. 1993~95년 사이, 어지간한 가정용 컴퓨터들이 램이 2MB~8MB 이러던 시절에 NT는 이미 12~16MB 이상을 요구했다. 그것도 한글 한자 지원 없이 오리지날 영문판이 말이다.
그 시절엔 CPU와 메모리 가격이 지금으로서는 상상하기 어려울 정도로 희귀하고 비쌌었다. 이러니 NT는 초창기엔 가정용 PC 생태계에서 도저히 발을 들일 수 없었다.

마소에서 개발하던 프로그래밍 언어/개발툴 중에 BASIC은 RAD로 지향점이 바뀌면서 Visual이라는 브랜드가 먼저 붙었다. (1991년) 그 반면, MS C는 7.0 버전에서 C++ 지원이 추가되면서 C/C++이 됐고, 그 다음 Windows NT용 32비트 타겟 빌드가 추가되면서 Visual C++ 1.0으로 다시 태어났다. 거기에다 IDE도 Programmer's workbench라고 언어 공용이던 게 Windows용 자체 에디터로 덤으로 바뀌었으니 겸사겸사 Visual이라는 단어를 붙인 듯하다.

이때는 크로스 컴파일이라는 개념이 약했는지 VC++이 x86용, MIPS용, Alpha용, PowerPC 용으로 제각기 따로 출시됐다.
아~ 그래서.. 개인적으로는 VC++ 4 시절에 PowerPC 타겟 흔적을 많이 봤던 것 같다. 그건 Windows NT를 염두에 둔 기능이지, CE용이 아니었다. 나중에 VC++ 6 IDE를 기반으로 출시됐던 eMbedded Visual C++와는 다른 제품군이었다.

3. Windows 2000: x86 단일 황금기

그 뒤.. 세기말이 되자 Windows 2000이라는 걸출한 제품이 Windows NT 5.0을 표방하며 출시됐다. 얘는 연도 숫자로나, 기술 계보로나 정말 너무 절묘한 교차점에 놓였다.
NT는 전통적으로 OpenGL이 있을지언정 DirectX 따위는 없던 운영체제였다. 그러나 2000은 일단 표면적으로는 NT 계열과 9x 계열의 통합을 추구했다. 그래서 DirectX라든가 plug & play, USB처럼 9x에 먼저 들어갔던 기능들을 대거 수용했다.

이제는 가정용 컴터들도 많이 빨라지고 램 용량도 크게 늘어서 NT 커널을 돌릴 수 있다고 여겨졌기 때문이다. 둘을 통합할 때가.. 아니, 구닥다리 DOS와 9x 커널을 퇴출시킬 때가 됐다.
이 참에, NT 구버전이 지원하던 타 CPU들은 미래가 없다고 여겨져서 때문에 지원을 끊었다. 그 대신 마소에서는 인텔의 새 밀레니엄 64비트 CPU로 여겨지던 Itanium을 지원하겠다고 벼르고 있었는데.. 이게 사실상 베이퍼웨어 나가리로 끝나 버렸다.

이런 이유로 인해 Windows 2000은 NT 계열임에도 불구하고 마치 9x처럼 사실상 x86 전용 운영체제로 출시됐다. 그리고 2000년대 초, 2000과 그 다음 XP 시기가 어찌 보면 32비트 x86의 황금기였다.
램은 128~256MB대.. 주소 공간이 부족하지 않고 32비트로 적당히 커버 가능해서 정수도 4바이트, 포인터도 4바이트.. 딱딱 절묘하게 떨어졌기 때문이다.
컴퓨터 클럭 속도는 기하급수적으로 증가하던 무어의 법칙의 끝물 상태였고, CPU도 x86 only에 가까운 상황.. 얼마나 깔끔하냐? 그 와중에 구닥다리 9x는 역사 속으로 사라져 가고.. 모든 게 파편화 없이 한데 집중됐었다. 새천년에 말이다.

4. 2000년대: Itanium과 x64의 명암

Windows의 역사상 어떤 형태로든 64비트 ABI라는 게 등장한 게 저 1990년대 중후반, Itanium 포팅을 할 때였다. PE 실행 파일의 포맷을 확장하고, 플랫폼 SDK에 INT_PTR이라든가 GetWindowLongPtr 이런 게 등장한 게 그 때라는 뜻이다.

하지만 IA64라고 불리는 Itanium은 처절한 실패로 끝났고, 21세기 초부터는 x64라는 x86 호환 CPU가 64비트 PC 시대를 주도하기 시작했다. 얼리어답터 컴덕이 아닌 일반인들은 컴퓨터 램의 용량이 실질적으로 4GB를 넘어선 2000년대 중후반, Windows Vista나 7쯤부터 64비트를 체감한 듯하다.

Windows는 일반인 클라이언트 제품군에서는 XP에서 딱 한 번 IA64를 지원하고는 학을 뗐다.
서버 제품군에서는 Vista에 대응하는 Server 2008까지 IA64를 조금 더 지원했고, 그 다음부터 지원을 끊었다.
그 대신 서버 제품군은 32비트 x86 전용 에디션을 클라보다 훨씬 일찍 끊었다.

클라에서는 Windows 10까지만 해도 x86 전용 에디션도 출시해 오다가 2020년대 11에 와서야 중단했다.
그러나 서버에서는 IA64를 약간 더 오래 지원한 대신, 그 Server 2008부터 x86을 끊고 x64로 완전히 갈아탔다. 클라와 서버의 컴퓨터 특성이 서로 다르기 때문일 것이다.
개발툴인 Visual C++은 2005부터 x64로 크로스 컴파일을 정식 지원하기 시작했다.

5. 2010년대 말: ARM64의 추가 도입

그 뒤, 마소는 2010년대 중반엔 경영진이 싹 바뀌었다. 새 경영진은 기존 CE나 폰/모바일 제품군을 포기하고 정리했다. Android/iOS와의 경쟁에서는 승산이 전혀 없다는 결론을 내렸으며, Windows 8 시절 같은 삽질은 더 하지 않기로 했다.
그 대신 Windows on ARM이라 해서 데스크톱용 기존 운영체제를 ARM64로 그대로 포팅해서 오늘에 이르고 있다.

너무 자명한 얘기지만, ARM64는 클라 제품군 한정이다. 서버 제품군을 그렇게 포팅하지는 않는다.
얘는 마소에서 ARM64EC니, ARM64X니 하는 온갖 하이브리드 규격도 만들어서 x64와 최대한 같이 포용하려 애쓰는 중이다.
예전의 Itanium처럼 호환성 없는 별개 취급을 하지 않고 있다.

2010년대 초, Windows RT 시절에 잠깐 나돌았던 ARM32는.. 2000년대 초 IA64와는 좀 다른 의미로 낙동강 오리알로 전락하고 역사 속으로 사라졌다. 한쪽이 64비트 삽질이었다면 다른 쪽은 모바일 삽질이라 하겠다.

이상이다.
한때는 온갖 CPU들이 난립하다가 x86으로 천하통일 되는 것 같았는데.. 지금은 그 뒤에 x64와 ARM64가 올라타서 상황이 좀 더 복잡해졌다. 날개셋 한글 입력기 작업을 하다가 이 이야기를 하고 싶어서 이렇게 글을 써 보았다.

한때, 1990년대부터 2000년대 초까지는 (1) 컴퓨터의 단일 코어 속도가 크게 증가했었다..
그 다음으로 1990년대 중후반부터는 (2) RAM이건 디스크건 메모리가 용량이 크게 증가하고 가격이 싸졌다. 이때쯤부터 C드라이브 디렉터리와 파일 구조를 DOS 시절처럼 몽땅 한데 조회하는 게 거의 무의미해지고 불가능해졌다.
끝으로, 2000년대부터는 (3) 인터넷 속도가 급격히 빨라지고 심지어 무선화까지 됐다.

이런 기술이 발달하고 저렴하게 널리 보급된 덕분에 일반 사용자들도 과거에 상상도 할 수 없었던 방대한 규모의 소프트웨어를 컴퓨터로 아무렇지 않게 돌릴 수 있게 됐다.

* 덧붙임: Windows CE

1990년대 중반, 가정용 PC에서는 Windows 95가 이제 막 정착했고 NT는 아직 별나라이던 시절에.. 마소에서는 PC보다 작은 기기에다가도 win32 API를 심어서 Windows 생태계를 가꿀 생각을 했다. 이름하여 Windows CE라는 게 이때 태동했다.

CE가 지원했던 CPU 중에는 NT에서 지원했던 MIPS, PowerPC 같은 것도 있었고 심지어 ARM32에다 x86도 있었다.
하지만 컴퓨터에 오로지 CPU만이 구성요소의 전부인 게 아니고, CE는 근본적으로 ‘임베디드’ 환경을 추구했다. CPU의 특성이나 메모리, 파일 시스템, 비디오, 소프트웨어 환경 등이 범용 컴퓨터와는 완전히 딴판이다. 그렇기 때문에 일반적인 Windows 프로그램을 돌리지는 못한다.

Windows CE용 프로그램을 개발하는 환경은 기존 Visual C++에다가 해당 플랫폼용 툴키트를 구매해서 추가로 설치하는 형태로 세팅했다. 2000년대 초에는 eMbedded Visual C++라고 IDE가 통째로 새로 나오기도 했었으나.. 그건 얼마 못 가 단종됐다.

Windows 9x가 21세기로 진입하지 못하고 세기말에 맥이 끊겼다면.. CE는 2010년 초쯤에 명맥이 끊겼다.
CE 커널은 9x와 달리 wide char로 대표되는 유니코드 버프는 당연히 받은 채로 시작했다. 하지만 2000년대 말의 트렌드이던 64비트 환경으로 포팅되지는 못했다. 동작 환경의 특성상, Itanium이나 DEC Alpha와도 접점이 당연히 없었다.

그 대신, 마소에서는 CE 커널을 스마트폰에다 얹을 생각을 했다. CE 커널이 한때는 PDA에도 쓰였으니 이는 자연스러운 귀결이었다. 그래서 통상적인 임베디드용 CE는 Windows Embedded Compact라는 이름으로 제품을 유지하고, CE를 기반으로 Windows Mobile을 만들고 나중엔 이름을 Windows Phone으로 대놓고 바꿨다.

나중에 마소는 Windows Phone을 CE가 아니라 NT 커널을 기반으로 다시 만드는 무리수까지 둬 봤지만.. 안드로이드나 iOS 같은 신흥 모바일 강자를 꺾을 수는 없었고 실패했다.
이런 사건을 거쳐 오늘날, 2020년대 기준으로 CE는 원래의 나와바리이던 임베디드 제품들의 유지보수 이상으로 신규 개발은 끝나고 성장이 멈춘 플랫폼이 됐다. 시장이 특수하기 때문에 무슨 Windows 9x가 사라진 것처럼 사라지지는 않겠지만.. 그야말로 고인물로 전락한 셈이다.

Posted by 사무엘

2026/10/03 08:35 2026/10/03 08:35
, ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2469

오늘날이야 x86이라는 컴퓨터 아키텍처가 세계를 완전히 평정해 버려서 PC부터 슈퍼컴까지.. 그야말로 모바일만 빼면 다 쓰이는 것 같다. 그리고 인텔은 그 x86이란 걸 최초로 개발한 본가로 너무나 유명하다.

x86은 아주 오랜 세월 동안 하위 호환성을 최대한 유지하면서 아주 점진적으로 진화해 온 아키텍처이다.
1970년대에 8086과 8088이라는 16비트 CPU에서 시작됐는데, 심지어 더 옛날에 8비트 시절의 8080도 x86의 전신 조상이라고 볼 수 있다. 8008이나 4004까지 가면 너무 멀어지는 것 같지만...;;;

이 x86은 1980년대 중반 80386 버전에서 32비트로 확장됐고, 그로부터 20여 년 뒤엔 64비트로도 확장되어 오늘에 이르고 있다. 다만, x86-64는 인텔이 아니라 AMD에서 처음으로 내놓았다는 것이 특이점이다.
이런 주류 라인인 x86 말고 인텔에서 만든 CPU라니, 뭔가 마이크로소프트의 제품 중에서 Windows, Office, Visual Studio가 아닌 계열을 탐방하는 것 같은 느낌인데.. 이런 것들이 있었다. 다들 32비트였다는 공통점이 있다.

1. iAPX 432 (1981)

인텔에서 개발한 최초의 32비트 CPU는 80386이 아니라 바로 이놈이었다.
16비트 x86이 최대한 저가 보급형에 현실 타협 컨셉으로 개발됐으니, 그 다음 32비트 CPU는 큰 포부를 갖고 실험적인 기능을 몽땅 때려박아 보자~~ 이런 목표를 갖고 개발됐던 것 같다.

x86만 해도 명령어가 아주 촘촘하고 내부 구조가 복잡한 CISC 방식이었는데, 얘는 그 이념이 더욱 극대화됐다. 운영체제나 특정 객체지향 언어 vm에서 소프트웨어적으로 담당할 일을 CPU가 회로 차원에서, 길다란 인스트럭션 하나 직통으로 최대한 지원하는 것을 추구했다.

구체적으로는 그 시절에 특수 분야에서 현역으로 쓰이고 있던 Ada 언어와 아주 찰떡궁합을 이루려 했다. 오오~ 그러면 이 CPU를 타겟으로 하는 Ada 컴파일러는 intrinsic 명령이나 구문이 많이 제공됐겠다.

글쎄, 객체지향 언어라면 RTTI 기능이나 가상 함수/메시지 테이블을 뒤지는 기능이 CPU빨로 직통 지원된다면 그건 바람직한 일이겠지만..
그 시절 기술로 CPU 안에 지나치게 많은 기능을 집어넣는 건 부작용을 야기했다.
CPU 내부가 너무 복잡해졌고 제품의 생산 비용도 치솟았다. 그런 주제에 얘는 동시대의 "16비트" 프로세서인 80286보다도 속도가 훨씬 느려졌다.

그나마 이 CPU의 장점을 살릴 수 있게 코드를 잘 생성하는 컴파일러를 개발하는 것도 영 지지부진했다. 단점은 한 트럭인데 장점도 애매하고.. 총체적인 난국이었으며 결국 이 아키텍처는 실패로 끝났다.

이런 홍역을 치렀으니, 인텔에서 1985년 말에 80386은 기존 8086의 구조를 최대한 유지하고 호환성도 살리면서, 정말 바꿔야 하는 부분만 16비트에서 32비트로 확장하는 컨셉으로 만들어졌다.
32에서 64비트로 넘어갈 때 Itanium은 망하고(너무 파격적) AMD64가 살아남았었다(좀 보수적). 그런데 이와 같은 유형의 삽질이.. 옛날에 32비트로 넘어갈 때도 인텔 내부에서 이미 벌어졌다고 볼 수 있다.

2. i960 (1988)

iAPX 432의 실패 이후에 인텔에서 오랜만에 새로 만든 비x86 CPU는 바로 얘였다. 정확히는.. 처음엔 지멘스와 공동 개발을 시작했지만 지멘스 쪽이 프로젝트를 포기하고 중도 이탈하면서 최종 결과물이 인텔 것이 되었다.

i960은 CISC가 아닌 RISC 방식으로 설계됐으며, 애초에 범용 컴퓨터가 아니라 산업용 임베디드 MCU 용도로 만들어졌다. 에, 그러니까 절대적인 성능이 뛰어나지 않더라도 특정 분야 연산만 겁나 잘한다거나, 열악한 환경에서도 퍼지지 않고 끈질기게 잘 돌아가는 것 말이다.
얘는 처음에 군용으로 납품되었으며 초창기 F-22 전투기의 내부에도 들어갔다고 한다. 미군 전투기..?? 거기야말로 오랫동안 Ada 언어를 사용했던 곳이 아닌가? 반면교사 선배격인 iAPX 432가 관심을 가졌던 그 언어 말이다.

i960은 인텔이 만들었던 비x86 CPU 중에서는 가장 성공했다. 범용 컴퓨터가 아닌 덕분에 특정 분야에서 고정된 고인물 수요가 보장되어서 수십 년 동안 생산되고 쓰였다.
얘는 일본 SEGA에서 개발한 버추어 파이터 2의 플랫폼인 MODEL2 기판에 채택되어 쓰이기도 했다.

"게임 크리에이터 열전"이라는 20년 전의 일본 만화에서 '스즈키 유 - 버추어 파이터' 편을 보면, 그 시절 기계로 현란한 3D 그래픽 애니메이션을 구현하기 위해 전투기에 들어가는 CPU까지 구해서 기판을 만들었다는 얘기가 있었는데..
1편 때는 조종사 훈련용 전투기 시뮬레이터에 들어가는 CPU와 GPU를 도입했었다. (MODEL1, NEC V60) 그러다가 MODEL2는 전투기 실물에 들어가는 인텔 i960 CPU가 쓰인 것이다. 그런 차이가 있다~!

3. i860 (1989)

얘는 960과 동시기에 같은 회사의 다른 팀에서 나란히 개발되고 있던 또 다른 32비트 CPU였다. 960보다 숫자가 작지만 960보다 나중에 출시됐다.
얘는 산술· 과학 계산을 빡세게 하는 워크스테이션이나 슈퍼컴을 겨냥하여 FPU를 64비트 스케일로 내장했다. 그리고 명령의 병렬 수행을 여러 모로 의식해서 명령 체계를 RISC를 넘어 VLIW 형태로 설계했다. 사실상 32비트판 Itanium이고 Itanium의 정신적 선배나 마찬가지였다.

하지만 i860은 컴파일러가 특정 분야의 프로그램 한정으로 이 CPU의 특성을 잘 살리는 방향으로 코드를 잘 번역하고 잘 생성해 줘야만 제 성능을 낼 수 있었으며.. 그러기가 쉽지 않았다. 다른 대부분의 상황에서 얘의 성능은 기존 CPU나 동급 경쟁사의 CPU보다 뛰어나지 못했다. 그래서 얘는 얼마 못 가고 실패했다.

인텔은 그래도 이 설계 이념을 버리지 못했다. x86이 당장 현실적으로 상업적으로는 잘나가고 있지만 얘는 레거시 때문에 구조적으로 너무 지저분하긴 했기 때문이다.
그러니 나중에 64비트로 갈아탈 때는 iAPX 432와 i860의 이념을 계승하면서 단점을 보완은 했다고 생각하면서 Itanium을 개발했다. 하지만 Itanium은 실패한 선배의 전철을 거의 그대로 밟으면서 역시 처절하게 실패했다.

그래도 인텔 i960과 i860의 개발진은 훗날 x86 동네에서 Pentium Pro CPU를 개발했다. 멀티미디어 지원에 필요한 병렬화 고속 연산 명령인 MMX를 만들어서 그 이념을 x86에다가 실현해 냈다.

사실은 마소의 Windows NT라는 것도 맨 처음, 최초로 타겟으로 설정한 아키텍처는 놀랍게도 이 i860이었다고 한다. 마소가 전통적으로 인텔 진영과 사이가 좋기도 했으니.. 하지만 본가이던 i860이 망조가 들고, NT는 처음부터 이식성도 있게 설계되었기 때문에 곧 x86, MIPS 등의 아키텍처로 포팅된 것이다.

나중에 Windows 2000은 NT 버전 5.0 급이었는데, 얘도 64비트용은 Itanium이 정식 출시되기를 기다리면서 대부분의 기간을 DEC Alpha 환경 내지 Itanium 껍데기 시뮬레이터에서 개발됐다고 한다.
하지만 이번에도 인텔 CPU가 통수를 치는 바람에 Win 2000은 사실상 x86 전용으로, WinNT의 역사상 지원 CPU가 가장 적은 버전으로 개발돼 버렸다.

글쎄, 인텔이 구닥다리 X86을 버리려고 1990년대부터 삽질했었다면, 마소는 NT 커널을 버리려고 2000년대 중후반부터 이것저것 실험하고 노력했던 것 같다. 하지만 현실에서는 이 시도 역시 전혀 성공하지 못했다.

Posted by 사무엘

2026/07/10 08:35 2026/07/10 08:35
, , , ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2449

1990년대 초중반 16비트 시절, 특히 Windows 3.x 시절엔 분야별로 이런 괴수들이 있었다.
30여 년 전의 아재 얘기이고 예전에 이 블로그에서도 다뤘던 얘기도 있지만 이렇게 한데 다시 정리해 본다.

1. 콜백 함수의 메모리 보정

80386 이전에는 CPU 차원에서 메모리 가상화 내지 보호라는 게 존재하지 않았다. 그런 환경에서 멀티태스킹이라든가 64KB 이상 메모리 접근을 구현하려다 보니 프로그래밍이 지금과는 비교할 수 없이 구리고 불편한 구석이 많았다.
운영체제에다 내가 만든 대화상자 콜백 함수를 하나 지정하려 해도 그 포인터를 바로 못 넘겨주고 이 콜백의 소유자가 누군지 레지스터에다 써 넣는 thunk를 감싸서 줘야 했다.

그래서 함수 전처리/후처리 thunk를 생성해 주는 MakeProcInstance와 FreeProcInstance라는 API가 제공됐는데..
마소의 직원도 아닌 Michael Geary라는 프로그래머가.. 빌드된 실행 파일을 살짝 후처리만 함으로써 저런 번거로운 절차 없이 콜백 호출이 되게 하는 기법을 발견해서 공개했다. (☞ 링크)

이건 이 바닥 업계를 크게 놀라게 했다. Windows를 개발한 마소에서도 자기들이 생각한 것보다 더 간편한 방법이 있었다는 것에 놀랐고, 이 기법을 차기 버전인 Windows 3.1에다 시스템 차원에서 정식 적용했다.

즉, 제3자 프로그래머는 Windows 3.0과의 호환성을 생각한다면 일일이 thunk를 만들어 주든가, 아니면 저 FixDS라는 툴로 후처리를 하면 되고..
3.1만 생각하면 된다면 저런 것 없이 프로그램을 편하게 만들면 된다.

2. 32비트 extender

Windows 3.x는 enhanced 모드에서 386 CPU에서 제공되는 멀티태스킹 관련 일부 기능만 사용할 뿐, 일단은 DOS와 마찬가지로 16비트 프로그램이었다.
그런데, 심지어 1993년에 Windows NT 3.1과 함께 PE 실행 파일과 Win32 API라는 게 정식으로 공개조차 되기 전에..!!!!
마소가 아닌 제3자 싸제 개발사에서 Windows 3.1을 위한 32비트 extender 런타임을 만든 경우도 있었다.

에 그러니까.. 옛날 도스용 게임에서 사용하던 DOS/4GW 같은 런타임의 Windows판이며, Win32s 같은 물건을 마소 말고 딴 데서 만들었다는 것이다. 미친;;
C/C++ 컴파일러로 유명했던 Watcom에서 Win386이라는 익스텐더를 만들었으며, 데이터베이스 앱인 Foxpro가 대표적으로 얘를 기반으로 동작했다. (☞ 관련 링크)

3. 32/16비트 flat thunk

Windows 95가 개발된 뒤, 마소에서는 32비트 코드와 16비트 코드 사이의 호환성 계층을 뚫어 주는 일에 진심이었다.
32비트 EXE에서 레거시 16비트 DLL의 함수를 호출하려면 뭐 thunk compiler를 돌려서 뭘 감싸 주고 메모리 주소를 무슨 세그먼트로 바꾸고 어쩌구저쩌구.. 했는데~

그 당시 Windows 95 Programming Secrets의 저자인 Matt Pietrek은 리버스 엔지니어링을 통해 마소에서 공개하지 않은 내부 API를 끄집어냈다.
이걸로 훨씬 더 간단하게 16비트 코드로 들어가는 방법을 공개하니 마소에서 그 당시에 크게 놀랐다고 한다. (☞ 관련 링크)
그 당시에 32비트 프로그램에서 시스템 리소스가 몇 % 남았다고 정보를 표시하는 건 이런 경로를 거쳐서 16비트 API를 호출해서 알아 온 것이었다.

4. 통째로 한글화

하긴, 꼭 외산 소프트웨어 말고 개인적으로 ‘한메한글 for Windows’도 굉장히 대단한 작품이었다고 생각한다.
Windows 3.x라는 준 운영체제를 통째로 마개조해서 없는 문자를 인식하게 만든 거니까.. 유니코드 시대가 도래하기 전에 말이다.

영문 원판에다가 한메한글만 씌운 게.. 마소 한국 지사에서 만든 정식 한글판보다 더 가볍고 성능이 뛰어났다. 그래서 그 시절 컴잘알들은 Windows를 그렇게 사용하기도 했다.
물론 16비트 시절에는 시스템이 불안정한 대신, 단독으로 시스템 전체에 영향을 주는 프로그램을 만들기도 훨씬 더 쉬웠었다.

그러고 보니 Windows 3.x 시절에는 껍데기 셸도 통째로 싸제 프로그램으로 갈아치우는 게 가능했다.
구닥다리 MDI 프로그램인 '프로그램 관리자' 말고 Norton Desktop을 띄운다거나, 한컴에서도 아래아한글 3.0x 시절에 '한컴 셸'이라고 꽤 괜찮은 유틸리티를 같이 선보인 적이 있었다.
이런 셸을 띄우면 Windows도 macOS라든가 NextSTEP 같은 타 운영체제와 더 비슷한 외형으로 바뀌었었다.

싸제 셸 프로그램 트렌드는 Windows 95에서 내 컴퓨터와 탐색기를 담당하는 전능하신 explorer 셸이 등장하면서 종결됐다. 이것도 참 재미있는 옛날 추억이다.;;

5. 비공식 그래픽 모드

끝으로, Windows 얘기는 아니지만..
Michael Abrash라는 프로그래머는 VGA 그래픽 카드의 스펙을 잘 뜯어보다가 제조사에서 정식 공개한 적 없는 기능을 찾아내서 발표했다.
그 당시 게임에서 많이 사용하던 320*200 mode 0x13 말고, 320*240 같은 해상도를 지원하는 일명 mode X 말이다. (☞ 관련 링크)

이 사람이 개발한 기술은 Doom 다음으로 Quake라는 FPS 게임에 도입됐다.
우리나라에서 옛날에 개발됐던 아마추어 슈팅 게임인 ‘85되었수다 / 삭제되었수다’도 내 기억이 맞다면 일반적인 mode 13h 말고 저 mode X 파생 그래픽 모드를 사용했었다.

Posted by 사무엘

2025/05/14 08:35 2025/05/14 08:35
,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2377

템플릿 얘기가 좀 길어졌는데.. 다음 주제는 가상 함수와 관련된 엉뚱한 생각이다.
C++이라는 언어는 앞서 잠깐 언급했던 바와 같이, '오버로딩과 오버라이딩' 사이에 뭔가 견제를 하는 게 있다.
그것과 비슷하달까, C++은 오버라이딩과 멤버 함수 포인터 사이에도 디자인 차원에서 선을 긋는 게 있어 보인다.

무슨 말이냐 하면.. 가상 함수가 존재하는 어떤 객체가 주어졌을 때, 이 객체가 참조하는 vtable 값을 직접 확인하는 것을 언어 차원에서 전혀 허용하거나 지원· 고려하지 않는다.
이 객체의 어떤 가상함수는 부모 클래스의 것과 같은지, 아니면 오버라이딩 됐는지.. 이런 것을 알 수 없다.

&obj->Foo == &TBase::Foo 이런 식으로 비교하는 거?? 가상과 비가상 불문하고 다 안 된다. 클래스의 non-static 멤버 함수의 주소를 얻는 건 컴파일 타임 바인딩이 가능한 &클래스::멤버 형태만 허용될 뿐, 런타임 바인딩인 &변수->멤버는 안 된다. 그냥 컴파일 에러로 처리된다.

멤버 함수 포인터를 이용해서 pFunc에다가 특정 클래스의 Foo를 집어넣었더라도.. (obj->*pFunc)()를 호출해 보면 obj->Foo()를 호출한 것과 동일하게 접수된다.
멤버 함수 포인터에는 자신의 vtable을 참조해서 그걸 호출해 주는 thunk 함수만 연결되기 때문이다. 그 아래의 vtable 상의 주소로 다이렉트 접근이나 제어는 안 된다! 신기하지 않은가?
(하긴, 다중 상속 체계에서는 this 오프셋 보정도 이런 thunk가 하는 일 중 하나이겠지만)

C++ 클래스에서 vtable이란 걸 바이너리 차원에서 꼭 이렇게 구현해야 한다고 C++ 표준에 규정돼 있지는 않다.
그러나 실제로 구현되는 방식은 컴파일러 불문하고 거의 뻔할 뻔자이다. 그렇기 때문에 다음과 같은 동작을 억지로 구현해 줄 수 있다.

class Base {
public:
  int x;
  virtual void VF1() {}
  virtual void VF2() {}

  void* GetFuncPtr(int n) { //0: VF1, 1: VF2
    void*** pppf = (void***)this;
    return (*pppf)[n];
  }
};

무려 삼중 포인터가 쓰인 GetFuncPtr이라는 저 함수를 주목하시라. void에 대한 포인터(1)의 배열(2)을 가리키는 포인터(3)이기 때문에 삼중이 된 것이다.
가상 함수가 들어있는 클래스는 맨 첫 멤버가 vtable 포인터이기 때문에 this에 대해 저런 형변환이 가능하다.

그 다음으로, Base에 대해 1번 함수를 오버라이드한 Derived1, 2번 함수를 오버라이드한 Derived2, 그리고 둘 다 오버라이드한 Derived3. 이 세 클래스를 다음과 같이 선언해 보자.

class Derived1 : public Base {
public:
  int y;
  virtual void VF1() {}
};

class Derived2 : public Base {
public:
  int z;
  virtual void VF2() {}
};

class Derived3 : public Base {
public:
  int w;
  virtual void VF1() {}
  virtual void VF2() {}
};

요렇게 한 뒤, Base, Derived1, Derived2, Derived3 아무 객체나 선언해서 GetFuncPtr(0)을 호출해 보면 Base와 Derived2는 같은 값을 되돌린다. Derived2는 VF1을 오버라이드 하지 않았기 때문이다.
GetFuncPtr(1)을 호출해 보면 Derived1이 Base의 것과 같은 값을 되돌린다. 이유는 동일.

그렇다고 이 주소값은 &Base::VF1, &Derived2::VF2 처럼 실존하는 멤버 함수의 주소를 C++ 연산자를 통해서 얻은 주소값과 일치하지 않는다. 이거는 멤버 함수 포인터에다가 대입해서 호출을 할 수 있지 않다.
애초에 멤버 함수 포인터는 일반 함수 포인터와 달리 임의의 정수형으로부터 대입하는 게 아예 불가능하지 싶다. reinterpret_cast나 C-style cast도 되지 않는다.
그러니 저 값은 그냥 클래스 간에 값이 같은지 다른지 비교 용도로만 써먹을 수 있을 뿐이다.

그리고 사실은 언제나 저렇게 가상 함수 2개짜리 vtable이 생긴다는 보장도 없다.
클래스를 만들어서 멤버 함수를 virtual로 선언했지만 실제 코드에서 이 클래스의 인스턴스를 한 번도 포인터로 접근하지 않아서 런타임(다이나믹) 바인딩이 필요하지가 않다면..
컴파일러가 최적화 스킬을 발휘해서 vtable을 곧이곧대로 만들지 않을 수도 있다. 그러면 우리가 저렇게 만든 GetFuncPtr 함수도 제대로 맞게 동작하지 않을 것이다.

일반적인 함수라면.. 형태가 너무 단순해서 컴파일러가 평소에는 인라이닝이나 인트린식으로 실컷 최적화한다고 하더라도 그 함수의 주소가 필요할 때는 일반적인 함수 포인터 값이 반드시 제공돼야 한다. 최적화는 부가 기능일 뿐이지만, 함수 포인터는 언어 스펙에서 제공되는 필수 기능이기 때문이다.
그러나 vtable에 명시된 함수 주소는 그렇게 공식적으로 제공되는 기능이 아니다. 프로그래머가 언제까지나 꼼수로.. at your own risk를 염두에 두고 써야 한다.

이상이다.
글을 맺으면서 문득 드는 생각인데.. C++의 RTTI (런타임 type info)가 내부적으로 구현되는 방식도 가상 함수가 구현되는 방식과 아주 밀접한 관계가 있으며, 서로 떼어서 생각할 수 없어 보인다.

vtable이라는 게 결국은 한 클래스와 무조건 일대일 대응하는 고유한 정보이니, 참조하는 vtable이 동일한 객체는 동일한 클래스의 인스턴스임이 보장되기 때문이다.
그러니 자기 클래스의 이름이라든가, 부모 클래스 목록 같은 RTTI도 vtable과 함께 두거나 최소한 RTTI를 가리키는 포인터를 vtable에다가 둘 법도 해 보인다. dynamic_cast 연산자는 그런 정보를 참조하면서 동작하면 될 테고.

아 그런데.. 이런 깔끔한 관계는 단일 상속 체계에서나 보장되겠다;;
다중 상속이라면 2개째 이후의 기반(부모) 클래스에 대해서 매번 vtable 포인터가 또 추가될 테니 일이 정말 복잡해지겠다.
단일 상속에서는 복잡도가 뭔가 1씩 더해지는 것만 생각하면 됐는데, 다중 상속에서는 2씩 곱해지는 수준으로 복잡도가 폭발적으로 증가한다.;;

그러니 C++ 표준화 이전부터 RTTI를 자체 구현했던 C++ 프레임워크들은(가령, MFC 같은 골동품) 그런 건 깔끔하게 포기하고 단일 상속만 염두에 두고 저런 기능들을 구현했지 싶다.

말이 길어져 버렸는데.. 암튼 이 글의 결론은
"이 ptr은 Base의 파생 클래스이긴 한데요, 특정 무슨 함수가 오버라이드 돼서 Base의 원래 것과는 달라졌는지 아닌지만 좀 알 수 있을까요?"
요건 언어 차원에서 알려주지 않는다는 것이다. 그런 건 query하는 함수를 사용자가 수동으로 구현해 줘야 한다.

Posted by 사무엘

2025/04/17 08:35 2025/04/17 08:35
,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2374

객체지향 언어라면 파생 클래스 코드에서 기반 클래스의 멤버에 접근하는 것이야 너무 당연히 가능하다. 상속을 protected나 public으로 받기만 했다면 말이다.
기반 클래스의 scope에서 선언된 내부 클래스라 하더라도 마음껏 인스턴스를 만들고 참조할 수 있다.

class Base {
protected:
  int x;
  class InnerClass {
  public:
    int z;
  };
};

class Derived: public Base {
public:
  void Foo() {
    x = 100; //base 꺼
    InnerClass o; o.z = 100; //base 꺼
  }
};

그런데 이게 평범한 클래스가 아니라 ‘템플릿 클래스’라면 상황이 어찌 될까?

template<typename T>
class TBase {
protected:
  int x;
  class InnerClass {
  public:
    int z;
  };
};

template<typename T>
class TDerived : public TBase<T> {
public:
  void Foo() {
    x = 100;
    InnerClass o; o.z = 100;
  }
};

한동안은 이 코드는 잘 통용됐다. 문법적으로 아무 하자가 없어 보이지 않는가? 내가 아는 한 Visual C++ 2010 컴파일러 정도까지는 이상이 없었다.
그런데 2010년대에 C++ 표준이 바뀌었는지.. 저건 후대의 버전부터는 컴파일되지 않고 오류를 일으키기 시작했다.
2019/2022에서 말이다. 그 사이에(2012, 13, 15, 17??) 정확히 언제부터 변화가 생겼는지는 잘 모르겠다.

TDerived에서 기반 클래스 멤버인 x에 접근하는 것 자체가 언어 차원에서 봉쇄되고 금지된 건 아니다. 단지, 템플릿 클래스에서 코드의 의미 명료화를 위해 좀 깐깐한 조치가 취해진 것 같다.

TDerived에서 x에다 접근하려면
this->x 라고 일일이 쓰든가, 아니면 TBase<T>::x라고 타입을 명시해 줘야 한다. 그 x를 지칭하기 위해서 어쨌든 x 단독으로 방치만 하지 않으면 된다.

CInternalClass도 주변에다 좀 decoration을 해 줘야 한다. 얘는 멤버 변수나 함수가 아니라 타입이다 보니.. typename 내지 using 처방을 해 주면 된다.
참조할 때 매번 typename TBase<T>::InnerClass 이러던가..
아니면 TDerived의 선언부에다가 using InnerClass = TBase<T>::InnerClass 이렇게 박아 주고 나서 다음부터 InnerClass만 쓰면 된다.

흐음~~
내가 기억하기로 C++에서 템플릿이라는 건 처음 도입됐던 시절엔 거의 C++판 매크로나 마찬가지였다.
템플릿 인자가 무엇이 들어오느냐에 따라 코드의 의미가 귀에 걸면 귀걸이, 코에 걸면 코걸이(특히 값이냐 타입이냐)처럼 완전히 달라질 수 있었기 때문이다.

T가 int냐, double이냐, 1000바이트 짜리 뚱뚱한 클래스냐~ 이거는 컴파일러 입장에서 단순히 코드 생성이나 최적화 전략만을 좌우할 것이다.
그러나 T::member 이런 거는..? T에 어떤 클래스가 오느냐에 따라서 member는 멤버 변수? 멤버 함수? 심지어 내부의 다른 클래스/enum 이름이 될 수도 있다. 멤버라 하더라도 static 멤버가 될 수 있고, non-static이 될 수도 있다!

이러니 템플릿 코드는 그거 단독으로 문법 체크를 하는 게 매우 난감했다.
템플릿에다가는 그 어떤 아무말을 씨부려 놔도 그 자체는 컴파일러가 전혀 개의치 않고 넘어갔다. #define MACRO(x) 그 다음에 그 어떤 아무말을 씨부리건 이것만으로는 컴파일 에러가 발생하지 않는 것과 같은 이치이다. 에러는 이 매크로를 사용하는 곳에서 발생할 뿐..

템플릿도 TBase<int>건 TBase<POINT> 처럼 그 템플릿에다가 인자를 줘서 실제로 사용할 때에야 파싱과 코드 생성이 시작됐다. 그때에야 에러가 발생했다.

그랬는데.. 요즘 C++ 언어의 디자인 추세는 템플릿이 너무 무질서하고 자유도가 너무 높은 것을 통제하려는 것 같다.
특히 템플릿만을 단독으로도 최대한 분석한다. 템플릿 인자로 그 무엇을 넣더라도 그와 무관하게 무조건 구문 실패와 에러가 발생할 만한 것은 굳이 템플릿을 실제로 사용하지 않더라도 지적해 준다.

일례로, 위의 코드에서 TDerived::Foo() 안에다가 x=100이 아니라 y=100을 넣으면 바로 에러가 난다.
이렇게 하려다 보니 T::member라는 토큰은 템플릿 인자 T에 무엇이 들어오건 최소한 멤버인지 타입명인지 정도는 고정적으로 의미 보장이 돼야겠다. 그래서 typename T::member 같은 조치가 취해졌다.

그리고 T에 무엇이 들어오건 주변 문맥을 고정시켜야겠으니 implicit하게 부모 클래스 멤버에 접근 가능하던 혜택(?)도 없어진 것이다.
그 혜택을 다시 입고 싶으면 using을 활용해서 직접 요청을 해야 된다. using은 typedef의 상위 호환 대체제이기도 하니..

왜, 같은 이름의 함수로 오버로딩과 오버라이딩을 동시에 시도했을 때도(예: virtual void foo()와  void foo(int)를 동시 시도) 파생 클래스에서는 오버라이딩 되지 않은 부모 클래스 멤버로 자동 접근하는 건 "막힌다". 그런 것과 비슷한 느낌이 든다.
막힌 멤버로 접근하려면 역시 부모 클래스 이름을 일일이 써 주거나, using Base::foo 라고 자동 접근 요청을 해야 된다. 이 조치도.. 나중에 일부러 취해진 것이다.

C++ 템플릿은 임의의 타입들을 다 boxing해서 단일 바이너리(컴파일된 코드)만으로 모든 템플릿 인자를 담당하는 '제네릭' 같은 물건이 아니다. 하지만 그렇다고 정말 귀걸이 코걸이가 다 되는 C++판 매크로도 아니니.. 그 중간의 다른 무언가를 지향하는 것 같다.

자, 본인이 이 글을 쓰게 된 계기는..
이 홈페이지의 옛날 자료실에 있는 "정렬 알고리즘 모음집" C++ 코드가 최신 컴파일러에서는 컴파일되지 않는다는 걸 뒤늦게 발견했기 때문이다.
템플릿 클래스 사이에 상속을 구현했는데.. 이제는 코드를 한참 뜯어고쳐야 컴파일 될 것 같다. ㄲㄲㄲㄲㄲ
이 참에 옛날 자료실을 다 github로 옮기는 것도 생각해 봐야겠다.

Posted by 사무엘

2025/04/14 13:00 2025/04/14 13:00
, , ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2373

C와 C++ 언어의 역사

※ C 언어는..

- 1972년에 '데니스 리치'라는 사람이 유닉스 운영체제를 개발하던 과정에서 고안했다. 지난 2011년에 스티브 잡스와 거의 1주일 간격으로 나란히 부고 소식이 전해졌던 그 사람 말이다.
- B라는 프로토타입을 거친 뒤, B 다음으로 C라는 이름이 붙었다. 참고로 B의 이전에는 알골(Algol)이라는 조상뻘 언어가 있었다.
- let it be 노래를 패러디한 write in C라는 개드립이 유행했었다.

- 초창기에는 const 지정자라는 게 없었다나 어쨌다나.. func(a) int a; 이런 기괴한 문법도 통용됐다.
- 그러다가 1989년에 처음으로 문법과 라이브러리에 표준화가 논의됐다. K&R C와 ANSI C의 구분이란 게 이때 처음으로 생겼다.
- 그 뒤 한참 나중에 C99가 나왔다. // 주석이라든가 inline 키워드는 그 전부터 C++에서 야금야금 가져온 아이템들이지만, 가변 길이 배열, 가변인자 매크로, restrict 같은 것은 C++과 무관하게 독자적으로 발생한 변화이다.

- C는 타 언어들과 달리 모든 정수형에 unsigned 구분이 철저히 존재하고, 초기화되지 않은 변수라는 게 존재하고, 런타임 에러 체킹이 별로 없고 생포인터를 직접 취급할 수 있고.. 독특했다.
이런 건 프로그래밍 언어 이념을 구현하기 위한 오버헤드를 최소화하고, 언어의 구현과 빌드된 바이너리를 최대한 가볍게 만들기 위한 노력의 산물이었다.

- C는 디자인 차원에서 type-safety가 낮은 축에 드는 언어인데, 첫 초창기에는 그게 더 낮았다. 변수나 매개변수, 함수의 리턴값 같은 데에 타입 지정을 생략하는 것에 엄청 관대했다. 포인터고 enum이고 논리값이고 문자고.. 개나 소나 int 정수 취급을 너무 좋아하는 언어였다.

- C의 장점으로 제기되는 "이식성이 뛰어나다"라는 말은.. 쌍팔년도 시절 어셈블리어에 비해서 C가 정말 참신하고 편했다는 걸 의미한다. 에 그러니까 "IBM PC 호환 기종"이라는 용어가 유의미한 변별력이 있던 시절, 게임기 전용 아키텍처라든가 슈퍼컴 전용 아키텍처도 있던 시절 말이다. ㄲㄲㄲ
오늘날 같은 언어 중립 바이트코드 가상머신(JVM, .NET..)까지 염두에 두고 나온 말은 아니다.

하긴, 컴퓨터는 16비트 정도 성능은 돼야 고급 언어 컴파일러를 돌릴 수 있지 않겠나 싶다. 8비트 컴에서 돌아가는 임베디드 급 프로그램을 C로 짜려면 아무래도 크로스 컴파일을 해야지, 8비트에서 바로 구동 가능한 건 어셈블러가 전부이지 않겠나.
Java/C# 같은 가상머신 바이트코드 언어는 당연히 32비트 이상의 CPU와 주소 공간이 필요할 테고 말이다.

뭐, 이식성이라는 게 중요하긴 하다. C를 주력 언어로 써서 개발된 Windows NT, Doom 게임 등등은 오만 가지 플랫폼으로 포팅되어 현재까지 살아남아 있는 반면,
어셈블리어만 썼던 OS/2, dBASE, Lotus 123 같은 고전 프로그램들은 오래 못 가고 역사 속으로 사라졌기 때문이다.
당대의 열악한 하드웨어에서는 온갖 성능 짜내면서 잘 돌아갔지만, 도무지 포팅이나 유지보수가 안 됐으니.. 하드웨어가 바뀌자 오늘만 살고 내일이 없는 프로그램으로 전락했다.

- Quake 3 arena는 1999년 말에 출시된 FPS 게임이지만, 이때까지만 해도 존 카맥 옹은 C++이 아닌 C만 써서 얘를 코딩하고 개발했던 걸로 잘 알려져 있다. 물론 그 뒤부터는 C++이 사용되기 시작했다;;
- C11에서는 해도 너무한 보안 빵점 함수이던 gets를 deprecated도 아니고 하위 호환성 따위 무시한 채, 그냥 처음부터 있지도 않았던 함수인양 존재를 없애 버렸다. 그리고 qsort의 콜백에다가 void* context 인자를 추가한 qsort_s도 정식으로 도입했다.

※ C++ 언어는..

- 비야네 스트로스트럽인지 어쩌구.. 이름이 난해한 분이 1979년에 C with classes라는 이름으로 맨 처음 발표했다.
- 그러다가 1983년에 이름이 C++로 바뀌어 확장됐다. C에다가 변수 증가 연산자 ++를 집어넣은 셈.
(참고로 C++ 이후에 나온 언어는 D도 있고 +의 개수를 더 늘려서 형상화한 C#도 있다. ㄲㄲㄲ)

- 다중· 가상 상속, placement new, const 함수, protected (public/private뿐만 아니라), 모든 연산자들의 오버로딩 같은 건 처음부터 있지는 않았고 1980년대 말에 추가로 도입됐다. 처음엔 대입 연산의 오버로딩 정도만 생각했대나 어쨌대나..
이때는 C++ 언어 자체에 대해 1.0, 2.0 하는 버전 넘버링이 있었다고 한다.

- 이 언어는 초창기에는 C++ 코드를 C 코드로 변환해 주는 컴파일러의 형태로 구현됐었다. 이름하여 CFront. 이건 기계어가 아니라 똑같은 고급 언어로의 번역이지만 전처리기 수준이 아니라 엄연히 컴파일러였다.
CFront는 1990년대 초까지 유지보수 되다가 중단됐다. 나중에 추가된 exception 기능을 넣는 게 C의 사고방식만으로는 도저히 무리였던 듯..

- PC 환경에서 최초의 기계어 직통 C++ 컴파일러는 1987~88년쯤.. VGA 그래픽 카드와 비슷한 타임라인 때 등장했다. C가 Lattice C가 거의 원조라면, C++은 Zortech C++가 원조다. (훗날 Symantec C++)
유명 제조사인 마소와 볼랜드는 1990년쯤 돼서야 C++ 컴파일러를 내놨다. 얘들이 1989년 전후해서 C 컴파일러의 버전업이 없었던 이유가 아마 C++을 첫 구현하느라 바빠서였지 싶다.;;

- 그러다가 1990년대 초에 기초적인 템플릿이 도입됐고 예외 기능도 추가됐고.. 언어와 라이브러리의 표준화가 논의되기 시작했다. 내가 도스 16비트 환경에서는 템플릿이나 예외는 못 써 봤다.;;
- 첫 표준 규격은 C++98이다. 이때 *_cast 형변환 연산자, namespace, explicit, typeid, true/false 등등이 들어갔다. C++이 C언어 물을 벗고 type safety를 뒤늦게나마 더 강화하기 시작했다.

- 이때쯤 기존 C++ 라이브러리들이 다 std namespace 안으로 들어가고, 헤더 파일 명칭에서 확장자 .h가 없어졌다.
- 그 뒤 2000년대 중반까지 C++은 10년 가까이 별 변화가 없었다. 중간에 템플릿 export 기능을 넣으려고 하다가 컴파일러 제조사들로부터 반발에 부딪혀 영구봉인해 버리는 흑역사가 있었다만.;;

- 그러다가 2010년대.. C++0x를 거쳐서 C++11에서 C++이 auto, nullptr, 람다(!!), R-value 참조자 등등을 도입하면서 modern C++이라는 새로운 언어로 환골탈태를 시작했다.
- C++11인지 14인지부터는 스마트 포인터도 auto_ptr 대신 unique_ptr, shared_ptr 등으로 세분화됐다.
- 지금 C++은 템플릿과 auto 람다에다가도 가변인자가 들어가고 <=> 우주선 연산자도 들어갔고 진짜 10년~20년 전과도 다른 난해하고 복잡한 언어가 됐다.

C++은.. 처음부터 치밀하게 설계된 언어가 아니라 오랫동안 점진적으로 자라고 진화하고 표준화도 꽤 늦게 된 언어이다. 이게 문제다.
이렇게 타이밍을 놓친 것 때문에 1990년대 초부터 개발됐던 C++ 라이브러리 프레임워크들은 자체적으로 제각기 중구난방 중복 구현해 놓은 범용 오브젝트, 문자열, 리스트/배열 컨테이너들이 넘쳐난다.;;; C#/Java의 세계에서는 상상도 할 수 없는 혼란일 것이다.;;

난 도스 시절에 글자를 찍을 때 C의 puts를 쓰면 exe 파일이 1만 바이트대밖에 안 나왔던 반면, C++ cout을 쓰면 파일이 4만 바이트를 넘는 거 보고는 cout을 안 쓰기 시작했던 기억이 있다.. ^^

Posted by 사무엘

2025/02/03 08:35 2025/02/03 08:35
,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2361

컴퓨터 업계에서 인텔의 경쟁사라고 하면 가장 먼저 (1) 동급의 x64 CPU를 만들어서 경쟁하는 AMD,
(2) 아키텍처 차원에서 x64에 도전하는 ARM 내지 애플, 혹은 심지어 (3) 울나라 삼성 전자까지 떠올릴 수 있다. 인텔이 메모리 반도체에도 손을 뻗치고 있기 때문이다.
그런데 인텔은 저것들보다는 대외 인지도가 낮은 분야에서 AT&T와도 경합한 게 좀 있었다.

1. 바이너리: 오브젝트 파일 포맷

C/C++ 언어로 코딩을 한 뒤에 컴파일을 돌리면 생기는 자잘한 obj 파일들 말이다. 기계어 코드를 담는 이 컨테이너 껍데기의 포맷은 누가 언제 제정했을까?
x86 진영에서는 CPU 본가인 인텔에서 제정한 OMF 방식이 16비트 시절부터 널리 쓰였다. 볼랜드니 마소니 컴파일러가 다르더라도 obj 파일은 호환됐기 때문에 툴을 달리하여 링크가 가능했다.

그러나 마소에서는 32비트 Windows NT를 개발하면서 실행 파일 포맷을 바꾸고(NE에서 PE), 빌드 툴체인도 싹 갈아치웠다. 단순히 OMF의 32비트 확장을 쓰는 게 아니라 obj/lib의 포맷도 AT&T에서 제정한 COFF 방식으로 바꿨다. 그 반면, 볼랜드 컴파일러들은 32비트에서도 여전히 OMF 방식을 쓰면서 서로 파편화가 발생하게 됐다.

그 시절에 마소에서는 빌드를 더 편하게 하기 위해서, 로딩을 더 빠르게 하기 위해서(메모리 매핑), 거기에다 이식성까지 고려해서 같은 여러 명분으로 COFF를 도입했었다. 다만, 지금은 그런 명분이 기술적으로 많이 옅어지고 사라지기도 했다.

그러고 보니 GNU 툴킷의 도스용 버전에 속하는 djgpp 컴파일러도 라이브러리· 오브젝트 파일 포맷은 COFF 방식이었던 걸로 기억한다. 바이너리 에디터로 들여다보면 arch! 앞에 이런 문자열이 있고.. "이건 마소 진영과 오픈소스 진영이 공통이네?" 이런 생각을 예전에 했었다.

2. 텍스트: 어셈블리어 문법

자기네 x86 기계어를 간단한 숫자와 영단어 나열만으로 풀어서 표기하는 어셈블리어 말이다. 이것도 인텔 식 문법과 AT&T 식 문법이 공존한다. 이건 단순히 '어셈블러' 제조사 간의 문법 차이가 아니라 '어셈블리어' 차원에서의 더 저수준 차이점이다.

인텔 문법 AT&T 문법
mov eax, 5
add esp, 24h
movsxd rax, ecx
paddd xmm2, xmm1
movl $5, %eax
addl $0x24, %esp
movslq %ecx, %rax
paddd %xmm1, %xmm2

간단하게는 숫자 앞에 $, 레지스터 이름 앞에 %가 막 붙어 있는 게 AT&T 문법인데, 본인 역시 Visual C++이 표시해 주는 인텔 문법에만 익숙하다. 하지만 역시 리눅스 진영 gdb 같은 데에서는 AT&T 문법이 주류이다.
현업에서 어셈블리어를 직접 짤 일은 없지만, 그래도 프로그램을 디버깅 하다 보면 디버거가 디스어셈블리해 준 어셈블리어 코드를 보게는 된다.

마소는 이거 문법은 딱히 AT&T 식으로 갈아타지 않았고 인텔 문법을 고수하는 듯하다. Macro Assembler 같은 기존 제품과의 호환 문제가 있기 때문인 듯하다.
뭐, 어차피 같은 CPU 아키텍처이고, 짜는 게 아니라 읽기만 한다면야 자잘한 표기 차이는 그렇게 심각한 차이점은 아닐 것이다.

프로그래밍 언어라는 건 적당히 고급 언어를 표방하면서 실용성을 갖춘 게 인기를 얻고 대중화되는 편이다.
그럼 실용성 대신에 한쪽으로 특화된 언어는 (1) 함수형처럼 수학 내지 순수주의 쪽으로 특화되거나, 아니면 (2) 어셈블리어처럼 기계 지향적인 쪽으로 특화되는 것 같다.

한 소프트웨어의 모든 코드를 저런 특화 언어만으로 작성하는 건 아무래도 무리이다.
그래서 기존의 실용적인(?) 다중 패러다임 언어들은 저 (1), (2)의 특성을 제한적으로 부분적으로 제공하곤 한다. 그게 (1) 람다 아니면 (2) 인라인 어셈블리인 셈이다.;;

요즘 세상에 대학교 컴공과에서 어셈블리어 코딩 실습을 하는 건 군대에서 총검술, 사관학교에서 승마 실습을 잠깐 하는 것과 아주 비슷한 모양새인 것 같다.
비록 현대의 전장이나 현대의 소프트웨어 개발 방법론과는 완전히 동떨어져 버렸지만, 코딩이라는 전투에서 백병전이 어셈블리어 실습이 아니겠나..;; =_=;; 실무에서는 쓸 일이 없지만 컴공 엔지니어를 양성한다는 학교에서는 컴퓨터의 밑바닥 모습을 이런 식으로라도 경험시켜 줄 필요가 있을 것이다.

Posted by 사무엘

2024/06/30 08:35 2024/06/30 08:35
, , , , ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2314

1990년대 초에 바다 건너 미국에서는 바둑, 오목, 체스, 스크래블 같은 보드 게임의 AI 위주로 ‘컴퓨터 올림피아드’라는 대회가 잠깐 개최된 적이 있었다. 기억을 정말 오랜만에 다시 떠올린다. ㅠㅠㅠㅠ
IOI라고 불리는 '국제 정보 올림피아드'와 헷갈리지 마시길. 요즘은 저걸 검색하면 구글도 자꾸 IOI 쪽으로 안내하는 것 같은데 그거랑은 다르다. 컴올은 공식 명칭에 '국제 I'라는 말이 없다. ㄲㄲㄲㄲ

IOI는 대학에 진학하지 않은 중등 수준의 10대 청소년들이 문제 푸는 프로그램을 '즉석에서 작성'해서 그 코드의 성능과 정확도를 평가 받는 대회이다. 그 반면, 저건 현업에 종사하는 소프트웨어 개발자/개발사들이 오랫동안 미리 연구 개발해 놓은 자기 자기 제품의 AI 성능을 현장에서 겨루는 대회이다. 즉, 로봇 쥐 미로 찾기와 비슷하며, 저런 보드 게임을 사람이 아니라 컴퓨터끼리 대국한다는 차이가 있다.

근데 컴터 올림피아드도 첫 대회가 1989년부터 시작됐다니.. 그건 IOI와 동일하다. 그리고 가끔은 IOI에서도 간단한 게임을 진행하는 프로그램을 작성해서 주최측 AI와 대국하고 채점되는 형태의 문제가 나오기는 한다. 그러니 둘이 완전히 다른 별개 분야의 대회까지는 아니긴 하다.

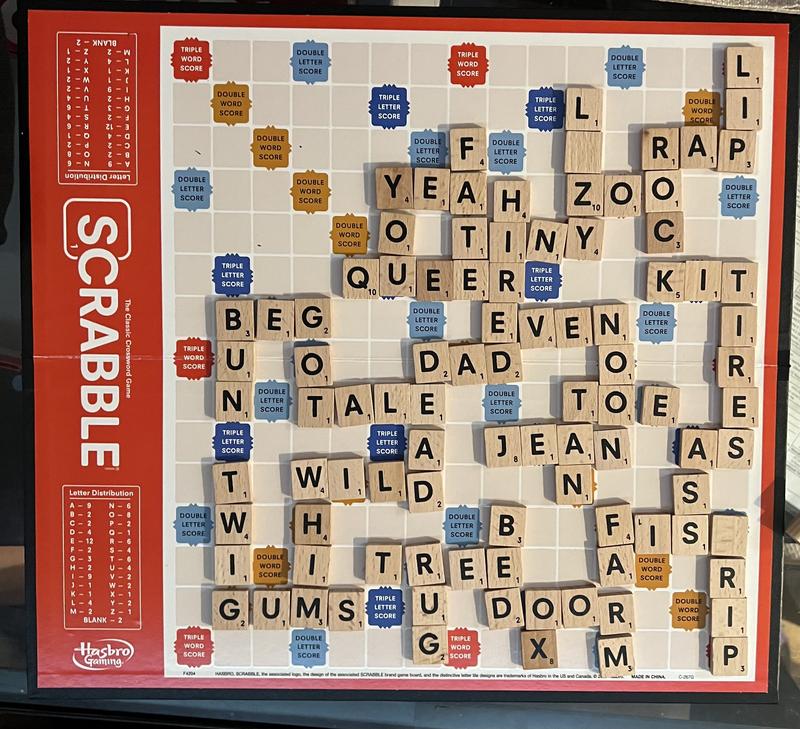
본인이 저 대회에 대해 들어 본 건.. 한때 왕년에 영단어 보드 게임인 스크래블의 AI를 연구하느라 관련 자료를 많이 찾아봤었기 때문이다.
무려 1988년에는 World's fastest Scrabble program (by 앤드루 아펠, 가이 제이콥슨)이라는 논문이 CACM에 게재돼서 후대의 스크래블 AI 개발자에게 아주 큰 영향을 줬다. 모든 가능한 수를 찾는 기본 작업은 이 논문에서 소개된 알고리즘으로 해치우고, 그 뒤에 단순히 당장 점수가 가장 높은 수를 넘어 장기적인 이익을 따지는 건 전략과 휴리스틱의 영역으로..

사용자 삽입 이미지

오래된 생각이긴 하다만, 스크래블 게임의 컴퓨터 구현은 대학교 수준의 자료구조와 알고리즘 코딩 주제로 아주 적합하다. 만약 내가 학원이나 학교에서 저런 전공 과목을 가르칠 기회가 있다면 실습이나 과제로 저걸 꼭 넣었지 싶다. =_=;;
하긴, 석사 논문으로 두벌식 한글 연속입력 오토마타를 연구했던 모 교수님은 자기가 강의하는 형식언어와 오토마타 수업 시간에 한글 입력 오토마타를 구현하는 과제를 고정 편성으로 넣었더구만.. 그런 것처럼 말이다.

아무튼 그건 그렇고..
저 논문을 투고했던 연구진은 딱 이듬해인 1989년, 제1회 컴퓨터 올림피아드의 스크래블 부문에 참가해서 우승했다고 한다. 타이밍 절묘하군..

그 뒤 2회와 3회에서는 Jim Homan이라고 MIT 출신의 다른 엄친아 공돌이가 개발한 스크래블 AI가 2년 연속 우승을 차지했다. 정황상, 아마 저 논문 내용을 바탕으로 AI를 더 발전시킨 것 같다.
그리고 그 사람은 저 AI 엔진을 토대로 CrossWise라는 굉장히 깔끔한 크로스워드 게임(설정을 맞춰서 스크래블 게임도 가능한!!) 프로그램을 개발해서 판매했다.

그것 말고 브라이언 셰퍼드라는 사람이 개발한 Maven이라는 스크래블 AI도 유명했다. 얘도 개발 역사가 1980년대로 거슬러 올라갈 정도로 오래됐고, 스크래블 보드 게임의 총판사에서는 Maven을 공식적으로 밀었다고 하는데.. 얘에 대해서는 나도 더 아는 바가 없다. 이쪽은 딱히 컴올에 참가한 이력도 없는 것 같다.

뭐, 이것도 다 지난 얘기이다. 지금은 스크래블 게임쯤이야 폰이나 웹에서도 돌릴 수 있을 텐데.. 유행이 지난 것 같다.
하다못해 바둑조차도 세계를 석권해 버린 알파고 개발진이 "이젠 바둑은 더 연구할 게 없다~~" 명목으로 발을 뺐을 정도이니 말이다. -_-;;

저 컴퓨터 올림피아드는 스폰서 내지 운영진을 섭외할 수 없어서 1991년 이후부터 1990년대 내내 맥이 끊겼다. 그러다가 2000년대 이후부터 다시 개최는 되고 있지만.. 다들 아시다시피 인지도가 별로 없고 마이너하다는 냄새가 풍긴다. 고전적인 최적화나 휴리스틱 위주의 AI는 유행이 끝나고 닥치고 인공신경망이 대세가 돼서 그런지..??

우리나라에서 보드 게임 AI 외길을 가고 있는 제품은 '장기도사'가 유일하지 싶다. 의미 있는 연구이긴 하다만, 보드 게임이라는 장르 자체도 마이너해지고, AI 패러다임도 마이너해져서 수요가 무척 적을 것 같다. 뭐, 그런 식으로 염세적으로만 따지자면 본인의 주특기인 세벌식 자판도 마이너 중의 초 마이너이긴 하다만 말이다. -_-;;

고전적인 AI 대신 2010년대를 풍미했던 건 인공신경망들이었다. 2012년, 사물 인식을 기가 막히게 잘한다는 AlexNet부터 시작해서 VGG, ResNet, YOLO가 뒤를 잇고 chatGPT, transformer 등등이 쏟아져 나왔으니까.
컴퓨팅 패러다임이 싹 달라졌다. 이 과정에서 파이썬은 머신러닝 학계와 업계의 공용 언어가 되었고, 교육과 실무를 다 장악해 버렸다. ㄷㄷㄷㄷ 파이썬과 루아(Lua)가 처지가 극과 극으로 달라지게 될 줄은 20년 전엔 정말 예상할 수 없었다. 이것도 생각할 점이라 하겠다.

글을 맺기 전에 잠깐.. 그러고 보니 World Cyber games도 생각난다. 얘는 컴퓨터 AI가 아니라 사람이 겨루는 대회이지만, 그래도 E-스포츠 전문이니 뭔가 컴퓨터스럽고 사이버틱한 느낌이 나기 때문이다.
얘도 2001년에 처음으로 시작됐다가 2010년대엔 스폰서를 못 구해서 한동안 중단됐던 적이 있다. 그 뒤 지금은 재개되기는 했지만 권위나 인지도가 예전만 하지는 않다는 게 컴퓨터 올림피아드와 비슷해 보인다.

Posted by 사무엘

2024/06/25 08:35 2024/06/25 08:35
, , , , ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2312

« Previous : 1 : 2 : 3 : 4 : 5 : ... 32 : Next »

블로그 이미지

그런즉 이제 애호박, 단호박, 늙은호박 이 셋은 항상 있으나, 그 중에 제일은 늙은호박이니라.

- 사무엘

Archives

Authors

  1. 사무엘

Calendar

«   2026/10   »
일 월 화 수 목 금 토
        1 2 3
4 5 6 7 8 9 10
11 12 13 14 15 16 17
18 19 20 21 22 23 24
25 26 27 28 29 30 31

Site Stats

Total hits:
4192270
Today:
506
Yesterday:
1684