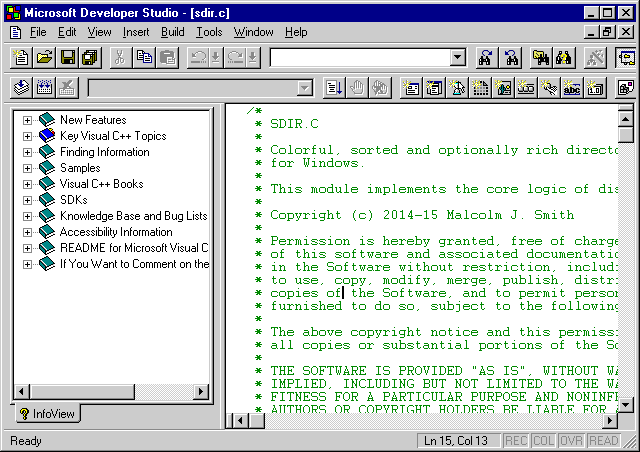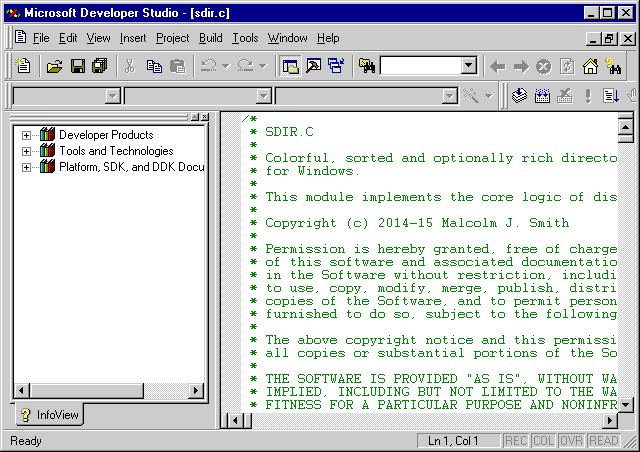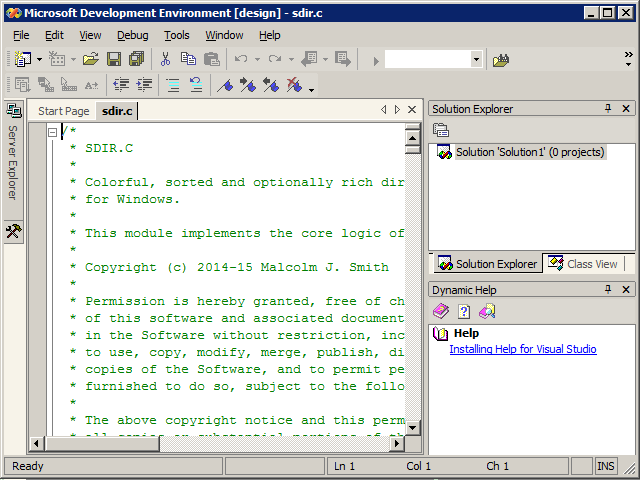
※ 10.0 (2010)

사용자 삽입 이미지

2008 이후 2010도 참 걸출한 작품이었다.
IDE가 MS Office 엔진이 아닌 WPF 기반으로 다시 만들어졌으며, 프로젝트 파일은 현재처럼 확장자에 x자가 붙고 내부 형식이 미묘하게 달라졌다. IDE와 툴체인 및 SDK 간의 분리가 가능해지고 융통성이 생겼다.
인텔리센스 엔진이 구닥다리 ncb 파일을 버리고, 전문적인 백그라운드 컴파일러와 DB 엔진을 기반으로 전면 개편됐다. 덕분에 정확도가 6.0이나 200x 시절보다 훨씬 더 향상됐다. 그리고 이제 #include 헤더 파일에 대해서도 우클릭해서 '요 파일 열기'가 가능해졌다.

CRT와 MFC DLL에 대해 side-by-side assembly 강제 정책은 철회됐으며... C++11 문법이 초보적인 수준으로나마 도입됐다. R-value 참조자 &&라든가 auto 람다 함수를 쓸 수 있게 됐다.
다만, 내 개인적으로는 시퍼런 IDE 외형이 좀 구리고 이질적으로;; 느껴진다. 그리고 UI 요소를 customize할 때 toolbar의 폭을 마우스 드래그가 아니라 픽셀수 숫자로 입력한다던가(뜨악~);; 몇몇 UI 기능은 200x시절보다 불편해졌다.
그게 오늘날 202x까지 개선 없이 그대로 이어지고 있다. 개발 우선순위가 낮아서 그런지 이런 것까지 살펴볼 여유가 없는가 보다.

※ 2012 (버전 11)
사용자 삽입 이미지

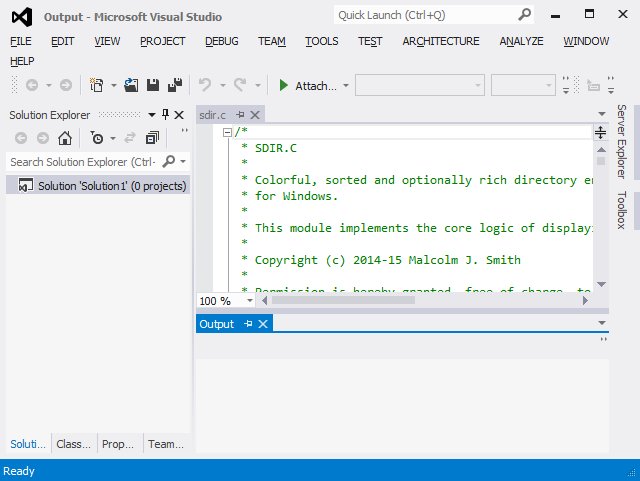
얘는 일단 IDE의 외형이.. 그 시절 유행하던 Windows 8 metro 디자인 물을 먹었는지 아주 새끈한 은백색 풍으로 바뀌었다. 프로그램 창에서 caption이나 border 같은 non-client 영역까지 전부 운영체제의 표준 외형을 벗어난 첫 버전이 바로 2012이다.

개발툴로서는 같은 최적화 세팅에서 컴파일 속도가 2010보다 더 빨라졌고.. 정적 분석이 bundle로 제공되기 시작했다.
신택스 컬러링도 예전보다 더 컬러풀해져서 #define, typedef, num 등이 모두 구분되어 나오기 시작했다.
#if에 걸려서 컴파일되지 않는 부분이 흐려지기 시작한 건 2010부터인지 2012부터인지 모르겠다. 200x는 확실히 아니었음..

그리고 이 버전부터 서비스 팩이라는 게 없어지고 update N 이렇게 명칭이 바뀌었다. 마소 제품들은 2010년을 전후한 Windows 7, Office 2010, Visual Studio 2010이 서비스 팩이란 게 존재했던 마지막 버전이었다.
로컬 하드에 설치 저장되던 방대한 규모의 MSDN 레퍼런스도 이때부터 사실상 없어졌다.

※ 2013 (버전 12)

2012 이후로 겨우 1년 남짓 만에 메이저 버전이 또 올라갔다. 마치 Windows 8과 8.1의 관계인 것 같은데..

얘는 C++11 문법 지원이 더 강화된 것, 그리고 무엇보다 Express 에디션 대신, 개인/인디 개발자를 위한 Community 에디션이 도입된 것이 크게 기억에 남는다.
Community 에디션은 5인 이하, 매출 얼마 이하의 소규모 인디 개발자이기만 하면 무료로 사용 가능하다. Express에서는 봉인돼 있던 MFC고 x64고 다 사용 가능하다. 2010년대의 컴퓨팅 환경에서 MFC는 몰라도 이제 x64 타겟을 만들 수 없다는 건 어불성설이 됐으니까..

뭐, Visual Studio만 그런 건 아니겠지만 요즘 버전들은 시리얼 번호 입력이란 게 없이 바로 설치 가능하다. 그 대신 실행 후에 마소 계정 로그인이 필요해졌을 뿐이다. 선설치, 후접속 결제인 듯..

※ 2015 (버전 14)

얘는 CRT 체계가 Windows 10 스타일로 전면 개편된 것이 가장 중요하다. 이때부터 지금까지 툴체인의 메이저 버전이 14, _MSC_VER 값도 19xx대로 변함없이 유지되고 있기 때문이다. vcruntime140, mfc140, msvcp140 말이다. Visual Studio의 버전만 올라가지, 툴체인은 메이저 버전이 올라가지 않기 시작했다.

그리고 2010 시절에 전면 개편됐던 인텔리센스 겸 심벌 browse DB의 내부 구조도 2015의 어느 업데이트 때부터 야금야금 바뀌었다. 원래 *.sdf 파일을 쓰던 게 *.VC.db 라고 바뀌었으며, DB 엔진도 자기네 Microsoft SQL Server Compact edition을 쓰던 게 SQLite로 교체됐다. 이것도 오늘날까지 이어지는 꽤 중요한 변화이다.
2015 이전 버전은 Visual Studio를 설치하면서 MS SQL server 2008이니 어쩌구가 야금야금 같이 설치됐던 반면, 현재는 그런 관행이 없어졌다.

※ 2017 (버전 15)
사용자 삽입 이미지

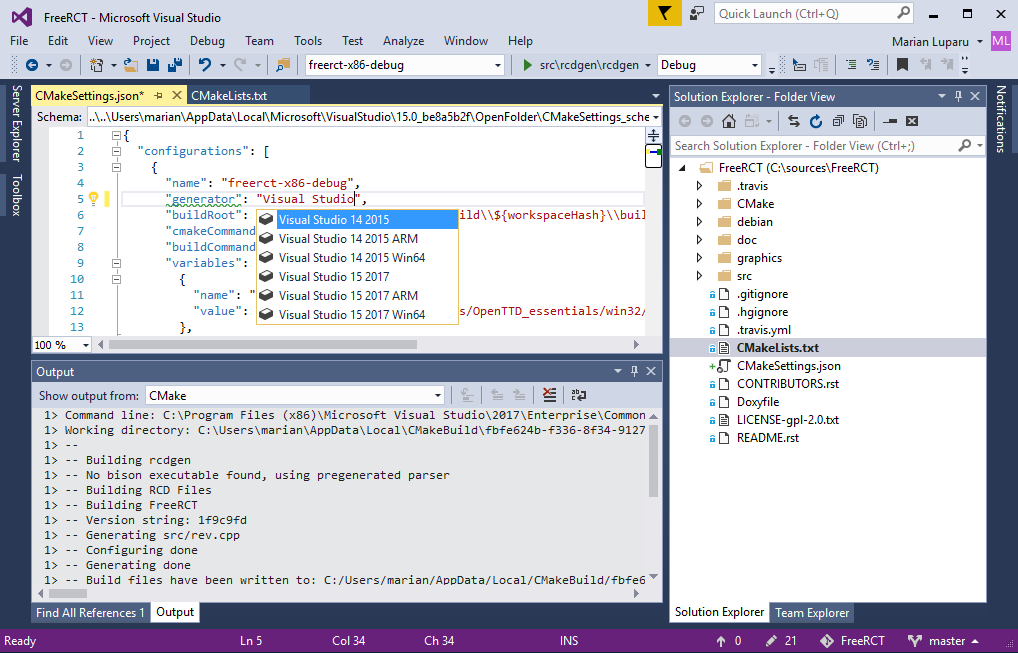
얘는 프로그램의 설치 및 업데이트 시스템이 현재 형태로 전면 개편된 최초의 버전이다. 소규모 업데이트도 워낙 잦아지니 지금처럼 버전 번호에 숫자를 하나 더 추가하는 형태로 바꿨다. (그러므로 Update N라는 표기는 2012부터 2015까지만 사용된 셈..)
IDE의 기본 색상도 흰색이 아니라 약간 연보라색 같은 파란색.. 지금과 비슷해졌다. 이렇게 2010년대 전반부 버전과 후반부 버전 사이의 차별화가 진행됐다.

세월이 세월이니 C++14 문법과 라이브러리도 야금야금 도입됐다. 가령, unique_ptr뿐만 아니라 make_unique도 사용할 수 있게 됐다. 일반적인 함수뿐만 아니라 매크로 함수나 람다에다가도 가변인자를 넣을 수 있게 됐다.

※ 2019 (버전 16)
사용자 삽입 이미지

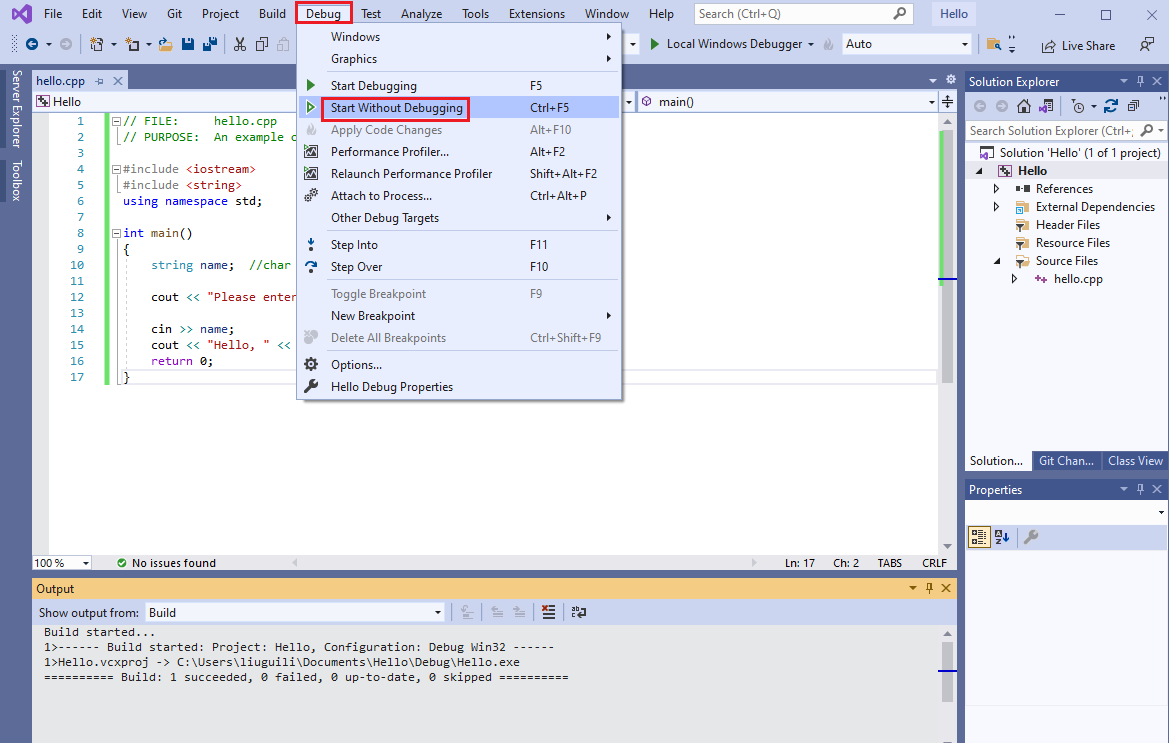
IDE의 색상에 연보라색이 2017보다 더 가미되어 채도가 올라갔다. 2017은 제목 표시줄에 Visual Studio라는 이름이 있었지만 2019부터는 그게 빠지고 최상단에 메뉴가 바로 표시되기 시작했다.
2019의 초창기 버전은 내 기억으로 win32 대화상자 리소스를 편집하던 중에 IDE가 잘 뻗기도 했었다. 여러 업데이트를 거치면서 그 버그는 다행히 고쳐졌다.

아 참, 이 2019 시기에.. 마소의 C++ 라이브러리에 꽤 흥미로운 변화가 생겼다.
Visual C++은 200x 시절부터 전통적으로 Dinkumware 사의 STL을 라이선스 받아 공급해 왔으며, 이 때문에 헤더 파일의 뒷부분에 언제나 P. J. Plauger라는 제작자와 제작사 이름이 들어가 있었다. 그랬는데 마소에서는 2019 하반기부로 이 라이브러리를 오픈소스화하고 자체 관리하기 시작했다. 그러면서 Dinkumware 관련 copyright 문구가 사라졌다.
사실, C++ 라이브러리는 갈수록 언어 구조에 종속적이고 내부 구현도 컴파일러 제조사의 재량에 종속적인 형태로 바뀌어 가는 게 요즘 추세라고 한다.

※ 2022 (버전 17)
IDE 자체가 드디어 64비트로 포팅됐다...!! 이걸로 끝..???

※ 2026
테마가 자매품인 Visual Studio Code 급으로 엄청 다양해지고 휘황찬란해졌다는 것밖에 아직 확인을 못 했다.;;

이상이다.
개인적으로 날개셋 한글 입력기의 개발이나 직장 현업 용도로 진지하게 오래 써 본 버전은 6.0, 2003, 2010, 2012, 2019, 2022 정도이다.

(1) Browse info에 대해

Visual C++은 아주 초창기 시절부터, 빌드 때 겸사겸사 browse info를 같이 생성하는(.sbr, .bsc) 기능이 있었다.
물론 이건 빌드 시간과 디스크 공간을 추가로 소모하는 작업이기 때문에 사용자가 원해서 옵션으로 지정했을 때만 수행한다. 지금도 프로젝트 설정 대화상자를 열어보면 C/C++의 아래에 Browse info라는 카테고리로 당당히 남아있다.

하지만 오늘날은 매번 빌드하지 않고도 IDE에서 소스 코드의 심벌을 실시간으로 조회하는 기술이 눈부시게 발달했다. 그렇기 때문에 이 browse info 기능은 완전히 과거 레거시가 돼서 거의 쓰이지 않는 기능이 됐다. 다만, 업계에서 이 sbr/bsc 파일을 이용해서 다른 분석을 하는 3rd-party 툴 제품이 있기는 하다고 한다.
오늘날은 소스코드를 컴파일하는 과정에서 '덤'으로 할 만한 작업은 정적 분석인 듯하다. 허나, 이젠 그마저도 on-the-fly로 수행돼서 의심 지점을 소스코드의 밑줄로 쫙 쳐서 표시하는 경지에 이르렀다.

(2) 버전 체계에 대해

Visual C++은 버전 관리 체계가 생각보다 복잡하다. 크게 세 가지 버전 시스템이 있다.

- Visual Studio IDE 자체의 버전: Help - About 대화상자에서 볼 수 있는 그 버전이다. 새로운 연도 브랜드가 출시될 때마다 메이저 버전 번호가 1씩 올라간다. 6.0 이후로 2010의 버전은 10이었고, 2015는 14, 2022의 버전은 17까지 올라갔다. 버전 13은 건너뛰었다.

- 툴체인의 버전: 오랫동안 Visual C++ IDE의 버전과 동일하다가(13을 skip한 것까지) 2015 및 Windows 10 때부터 14에서 멈췄다. CRT/MFC DLL의 ABI와도 버전이 연계되는지, 현재는 마이너 버전만 쭉 올라가고 있다. 프로젝트 세팅의 '플랫폼 도구 집합'에 해당한다.

- 컴파일러의 버전: cl.exe를 실행했을 때, 또는 소스 코드에서 _MSC_VER의 값을 넣어서 확인 가능한 버전이다. 얘는 Visual C++의 전신인 Microsoft C/C++의 버전값을 승계했기 때문에 Visual C++ 1.0 시절에 이미 800부터 시작됐다. MS C/C++의 마지막 버전이 7이었고, VC++ 1은 MS C/C++ 8과 같다고 간주됐기 때문이다.
다만, Visual C++ 2에서 4로 넘어갔을 때는 값이 200이 아니라 100만 늘었다. VC++ 6의 컴파일러 버전은 500이 아니라 400이 증가한 1200이었다. (12.0)

그 뒤 IDE의 버전이 14인 2015에서는 800이 아니라 700이 증가한 19.0에 도달했고(13 skip이 없으므로), 이때부터는 툴체인의 버전과 마찬가지로 메이저 버전의 번호가 오르지 않고 있다.

Posted by 사무엘
2026/10/11 08:35 2026/10/11 08:35
, , ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2471

* 무려 2010년쯤에, 2008 버전이 최신이었던 시절에 썼던 글을 내용을 보강하고 업데이트 하여 다시 올렸다. 심지어 분량이 엄청나게 늘어나서 글을 둘로 나눴다.

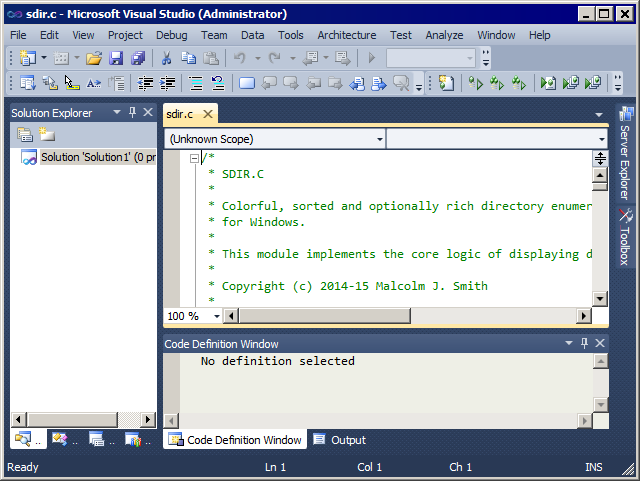
※ 1.0

사용자 삽입 이미지
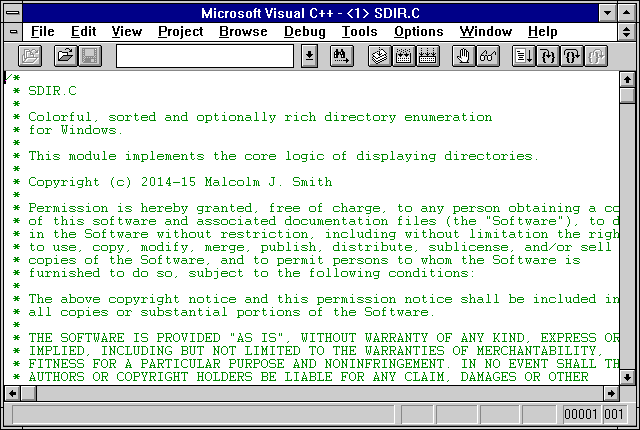
(스샷의 출처는 Malcolm Smith (malxau)이라는 분의 유명 홈페이지)

1993년에 출시된 Visual C++ 1.0은 Microsoft C/C++ 7.0의 차기 버전 겸 Windows NT 전속 개발툴 역할을 하기 시작했다. 이웃 BASIC 팀에서 MS Basic PDS 7의 다음 버전이 Visual Basic이라고 선례를 남겼으니, C/C++ 팀도 비슷한 작명을 도입했던 게 아닌가 싶다. BASIC은 RAD 툴로 바뀌었고 C/C++은 32비트로 갈아탔다.

물론 이때는 16비트에서 32비트로 한창 넘어가는 과도기였기 때문에 Win32s 타겟이 지원되기도 했다. 그리고 Win32s가 아닌 순수 16비트용 에디션도 나중에 출시되기는 했다. (VB 1도 Windows용 이후에 DOS용이 따로 출시됐듯이..) 하지만 VC++ 16비트용은 개발 계보가 32비트 에디션과는 상이했다.

32비트 환경에서는 메모리 모델 구분이 없는 대신, CRT에 링크 방식(static/DLL)과 멀티스레드 지원 여부라는 속성이 새로 도입되었다.
참고로 Visual Basic은 1996년엔가, 버전 4에서야 32비트가 도입됐다는 것도 기억할 점이다. 16/32비트 에디션이 따로 나왔으며, VB5부터는 32비트 전용으로 바뀌었다.

※ 1.52

얘는 16비트 Windows를 정식 지원하는 마지막 버전이어서 매우 중요하다.
프론트 엔드 IDE는 모두 16비트 Windows 프로그램인 반면, 커맨드 라인에서 동작하는 컴파일러, 링커 같은 주요 툴들은 도스 익스텐더 stub을 내장하고 있는 32비트 PE 포맷인 점이 무척 인상적이다.

※ 2.0

이제부터 완전히 32비트 전용으로 바뀌었다. 하지만 이때는 아직 Windows 95가 나오기도 전이고 NT는 인지도와 점유율이 아주 미미했었다. 그래서 VC++ 역시 아직까지는 별 존재감이 없고 주목을 못 받았다. 아직까지는 16비트 Windows에서 볼랜드의 OWL 라이브러리도 쌩쌩히 현역이었다.

Windows 95의 워드패드가 바로 듣보잡 MFC 3.0 기반이었는데, 이게 Visual C++ 2.0의 흔적이다.
그리고 이 시절 Visual C++ RISC edition 어쩌구 하던 건 Windows CE가 아니라 NT를 염두에 둔 타겟이었다. 이건 eMbedded Visual C++과는 다른 제품군이었다.

※ 4.0

사용자 삽입 이미지

DirectX에는 4라는 버전이 없듯, Visual C++에는 3.x대 버전이 없다. 내부적으로 꾸준히 버전업이 돼 온 MFC의 버전 번호에 맞춰 곧바로 4.0으로 건너뛰게 된다.
VC++ 4.0은 Windows NT뿐만 아니라 정통 95용 32비트 프로그램을 만들 수 있다는 이점으로 인해 인지도가 급격히 올라갔다. IE가 넷스케이프를 제쳤듯이 Visual C++이 Borland C++을 제치기 시작했다.

4.0에 와서야 비로소 IDE가 오늘날의 Visual C++과 비슷한 골격이 갖춰졌다. 즉 코딩, 리소스 편집, 클래스 마법사, 도움말 열람을 모두 한 프로그램에서 할 수 있는 진정한 통합 환경 Developer Studio가 이 버전부터 생겼다.
msdev.exe라는 프로그램 이름은 훗날 6.0까지 이어졌다. MFC ClassWizard라든가, ClassView도 이때 도입됐다.

※ 4.2

4.1을 거쳐 4.0이 마이너 업그레이드된 버전으로, 제법 인지도를 얻었다. ActiveX 컨트롤, STL 같은 기능이 추가되고 MFC DLL의 이름도 이때부터 MFC42로 이름이 바뀌어 큰 뼈대의 변경 없이 훗날의 6.0까지 이어졌다. MFC42는 윈도우 98 이래로 운영체제가 이제 known DLL로 인정하는 마지막 버전 숫자이기도 하니 더욱 의미가 있다.

4.2에서부터 Win32s의 지원이 중단되었다. 오죽했으면 설치할 때 “이 버전부터 Win32s를 더 지원하지 않으니, 그 환경 개발하고 싶으면 이거 설치하지 말고 옛날 버전 쓰셈!”이란 경고문까지 나온다.

※ 5.0

사용자 삽입 이미지

얘와 6은 도구모음줄과 메뉴가 MS Office 97 스타일로 바뀌었다. 다만, 5는 도움말은 여전히 RTF 기반이고 인텔리센스도 아직 없었다.
외형뿐만 아니라 내부 기능도.. 한번에 여러 프로젝트들을 담을 수 있는 workspace 개념이 이때 도입됐다. 단, dsw/dsp라는 파일 포맷 자체는 5와 6 두 버전에서만 쓰이고 이후 버전에서는 또 바뀌게 되었다.

몇몇 C++ 최신 표준이 반영되어 bool이 built-in type으로 지원되기 시작했다. 그리고 이때부터 빌드하는 EXE 파일에 PE 재배치 정보가 기본적으로 생략되었으며.. 그 유명한 Rich 시그니처가 슬쩍 들어가기 시작했다.
다만, 이 5.0은 이듬해에 나온 6.0에 밀려 존재감을 완전히 상실했다. 뭔가 아래아한글 97이 나오기 전의 96이 묻혀 버린 것과 비슷하달까?

※ 6.0

개발툴계의 Windows XP 같은 만수장세 결정판이었다. 이 버전 이후로 거의 4년 가까이 버전업이 없었고, 다음 버전인 닷넷이 변화폭이 너무 크기도 했기 때문이다.

6에서는 인텔리센스(초보적인 수준), edit and continue, delay-loaded DLL 같은 획기적인 기능이 처음으로 추가되고 도움말이 별도의 MSDN 라이브러리로 독립함과 동시에 HTML 기반으로 모두 바뀌었다.
이 버전은 윈도우 9x에서 설치 가능한 마지막 버전임과 동시에 MSVCRT, MFC42 같은 known DLL만 사용하는 바이너리를 생성할 수 있는 마지막 버전이기도 하다. 주요 라이브러리를 DLL 링크하고도 DLL 배포 걱정을 할 필요가 전혀 없다는 장점이 있다.

4.2 때는 ClassView에 있는 각종 클래스, 변수 정보가 소스 파일을 매번 저장할 때에만 업데이트됐다. 이것이 내용이 바뀔 때마다 실시간으로 바뀌기 시작한 것도 5.0은 아니고 6.0부터인 걸로 기억한다.
Visual C++이 C++ 표준을 준수하지 않는다고 비판이 많긴 했지만, 라이브러리의 헤더 파일에서 .h 확장자가 없어지고 namespace std가 도입된 건 6.0부터였지 싶다.

※ 7.1 (2003)

사용자 삽입 이미지

Visual C++의 다음 버전은 처음엔, 버전 번호나 연도가 아닌 닷넷이라는 브랜드로 출시되었다.
MFC를 써서 개발된 VC 특유의 전통적인 msdev.exe는 퇴출되고 devenv라는 MS Office 내지 VB 스타일의 IDE가 등장했됐다. 이는 완전히 새로운 것이라기보다는 예전에 Visual Studio에 있던 Visual InterDev와 비슷한 형태였다. 단지 거기에다 외형만 MS 오피스 XP 스타일 UI를 그대로 물려받았다.

덕분에 Visual C++과는 영 인연이 없고 VB만의 전유물인 것 같던 Property grid가 도입되어 Visual C++ IDE 특유의 납작한 등록정보 대화상자를 대체했다. 클래스 마법사도 이 형태로 대체됐다. 도움말은 5.0 시절처럼 IDE 내부에 띄울 수도 있고 6.0처럼 외부에 띄울 수도 있는 융통성 있는 형태로 바뀌었다.
dsw/dsp 대신, sln(솔루션)과 vcproj 요렇게 프로젝트 파일의 확장자와 포맷이 바뀌었다.

이제 주류로 내세운 게 C#, 공용 언어 런타임 같은 닷넷 환경이긴 했지만 네이티브 C/C++ 쪽도 크게 향상되었다. 네이티브 wchar_t 형식이 지원되기 시작했다.
6에서 첫 도입됐던 인텔리센스도 굉장히 강력해져 특히 #define 매크로 심볼에 대해서도 동작하기 시작했다. 별도의 browse info를 만들지 않아도 선언/정의로 가기 기능을 바로 사용할 수도 있게 됐다. 닷넷 정도만 써 보면 이제 6.0은 충분히 열악함을 느끼기에 충분할 것이다.

64비트 크로스컴파일은 불가능하지는 않으나 불편하고 디버깅도 되지 않고 IDE 차원의 적극적인 보조는 못 받는 어정쩡한 위상을 차지하고 있다. 이 불완전한 면모들은 후속 버전인 8에서 보완되었다.

참고로.. 2003 이전, 2002년에 Visual Studio .NET이라는 이름으로 먼저 출시된 버전 7.0은 정말 놀라울 정도로 존재감 없이 신속히 잊혀졌다.
글쎄, 6.0 이후로 오랫동안 버전업이 없다가 닷넷과 CLR이라는 걸 도입한 첫 버전이니 너무 불안정하고 버그가 많았던 걸까? 저 제품에 대해서는 내가 아는 게 없다. 금세 .NET 2003 (7.1)으로 대체됐다.

※ 8.0 (2005)

얘도 생각해 보니 변화가 굉장히 많았다.
for 문의 변수 scope처럼 그동안 Visual C++ 컴파일러가 표준을 어기고 있던 문법을 교정했으며.. 멀티코어를 표방했는지 빌드 로그에 코어 번호가 왼쪽에 표시되기 시작했다.
CRT의 보안이 이때 크게 강화됐다. strcpy_s와 gets_s(대상 버퍼 크기), qsort_s(콜백 함수에 데이터 전달 가능), strtok_s(토큰 중복 호출 가능) 같은 함수가 새롭게 등장하고 strchr 같은 경우, C++에서는 const 포인터를 되돌리는 버전과 비const 포인터를 되돌리는 함수가 오버로딩으로 분리해 나갔다. 무척 신선한 변화라 느껴진다. STL 디버깅도 훨씬 더 편해졌다.

이 버전부터 별도의 플랫폼 SDK를 설치할 필요 없이 IDE 차원에서 x64 타겟 빌드와 디버깅이 정식 지원되기 시작했다.
그리고 이때 MSVCR80, MFC80의 배포 방식이 side-by-side assembly 방식으로 완전히 바뀌었다. 이와 덩달아, 리소스 편집기로 수동으로 해야 하던 메니페스트 생성/편집 기능도 상당 부분 자동화됐다.
이 버전부터는 생성하는 프로젝트의 디폴트 기반 인코딩이 드디어 유니코드로 바뀌었다.

UI 상으로도 이제 MS 오피스 스타일에서 독립한 새로운 외형 비주얼을 갖기 시작했으며, 도구모음줄 아이콘도 256색으로 더 화려해졌다. 전통적으로 ClassView에 클래스와 멤버들이 한 트리에 쫙 나열되던 것이 멤버는 별도의 리스트에 뜨도록 바뀌기도 했다. 도킹 창을 드래그할 때 나타나는 도킹 다이아몬드도 2005에서 첫 도입된 물건이다.
Visual Studio의 무료 에디션인 Express 에디션이 이때 첫 도입됐다. (무료이지만 MFC 없고 64비트 타겟도 미지원)

※ 9.0 (2008)

8이 질적으로 많이 바뀌었다면 9는 Windows Vista의 등장처럼 8 출시 이후에 생긴 변화를 IDE나 MFC 라이브러리 같은 데에 적극 반영하여 양적인 향상을 꾀했다. 일단 MS Office 스타일의 GUI를 손쉽게 만들 수 있는 feature pack을 MFC에 드디어 도입했다.
그리고 2005는 설치하려면 sp1에, Vista 지원 패치.. 등 덕지덕지 땜빵을 해야 할 게 많았는데 2008은 그걸 당연히 모두 기본 접수했다.

Windows Vista에서 도입된 시작 주소 랜덤화 기능이 요 2008에서 정식 추가됐다. 2008에서는 이 보안 기능을 사용하는 EXE를 만들 수 있다는 뜻이다.
10여 년 전, 5.0에서 누락되기 시작한 EXE의 재배치 정보가 2008부터는 기본적으로 다시 들어가기 시작했다. 옛날에는 fixed address를 지원하지 않는 win32s와의 호환 때문에 그게 필요했었지만, 지금은 보안 기능 때문에 필요해진 것이다.

2008은 설치하기 위해 Windows XP 이상을 요구하며(2000 지원 중단), 지원하는 타겟 플랫폼에서도 Windows 9x는 공식적으로 완전히 제외됐다. 링커 옵션에서 바이너리의 최소 요구 운영체제 버전이 4에서 5로 껑충 뛰었고, 이보다 낮은 값은 지정 자체가 안 된다.
또한 single threaded CRT 라이브러리 옵션도 없어졌다. C 라이브러리는 이제부터 무조건 multi threaded이다.

Posted by 사무엘

2026/10/07 19:35 2026/10/07 19:35
, , ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2470

지금 올리는 이 글은 원래는 이전의 새 버전 소개 글과 같이 올라갔어야 했다.
하지만 이 내용까지 같이 저 때에 맞춰 넣어서 글을 완성할 여유가 도저히 없어서 부득이하게 글을 둘로 나누게 됐다. ㄲㄲㄲㄲ
뭐, 글을 쓰고 보니 분량이 워낙 길어진지라, 별도의 글로 분리한 게 다행히 더 좋은 모양새가 되긴 했다.

1. 타자연습: 히스토리 기능의 부재가 아쉬워

연습글별로 예전에 마지막으로 연습하던 위치를 기억하기, 그리고 제일 최근에 열어서 연습했던 연습글을 기억하기.

이건 지금까지 여러 사용자들께서 건의했으며 본인도 지원의 필요를 느끼고 있었고, 이번에 어지간해서는 같이 구현하려 했다. 어떤 형태로 구현할지에 대해서도 얼추 구상을 마쳤다.
하지만 이건 아쉽게도, 죄송하게도 이번 4.0에서 실현되지 못했다. 또 다음 버전을 기약해야 하게 됐다.

일단 지금 형태 있는 그대로라도 '64비트화'라는 거대한 0순위 과업이 생겼다 보니.. 신규 기능은 우선순위에서 밀렸다.
게다가 이건 아무래도 사용자의 계정에 새로운 데이터가 영구적으로 추가되는 '큰 기능'이다. 이걸 구현해 넣기에는 지금 프로그램의 로직, 계정 파일 포맷 등등이 마음에 안 들고 많이 구려서-_-;;;
이것부터 최적화하고 작업을 더 장기적인 안목을 보면서 하는 게 낫겠다는 결론을 내렸다.
지금 이 구조에서 저 기능만 간신히 넣는 건 너무 삽질스러워 보였다.;;

그래도 이번 4.0을 계기로 날개셋 타자연습도 오랜 겨울잠에서 깨어나고 먼지를 털어냈다.
이제 최신 개발 환경에서 신형 API나 최신 C++ 문법도 아무 제약 없이 쓰면서, 여건이 허락하는 한 프로그램을 계속해서 발전시켜 나갈 것이다.

2. 타자연습: 게임 음악 관련 불만

타자연습을 x64 환경으로 포팅하면서 알게 된 사실인데.. 마소는 64비트 Windows에서는 DirectMusic의 지원을 사실상 끊었다.
관련 인터페이스들을 다 싹 없앤 건 아니고 directmusic performance 계층만 없앴지만.. 이거 없앤 게 사실상 DMusic을 몽땅 없앤 거나 마찬가지이다.

도대체 왜??
아무리 waveform 음원이 대세이고 MIDI는 현업 게임들에서 도태됐다지만, 내 프로그램처럼 소규모 초저예산 게임에서는 미디 음악을 여전히 쓰기도 한다.

그럼 더 구닥다리인 MCI API로 돌아가리?
음악 음색도 안 좋고, 로딩 때 랙도 너무 심하고, 게다가 메모리에 로딩된 미디 데이터를 바로 재생하지 못하고 임시 파일을 써서 불러들였다가 도로 지우는 삽질.. 이건 도저히 쓸 게 못 되었다.

마소에서 미친 짓을 했으니, 나도 미친 짓을 하기로 했다.
음악만 별도의 32비트 호스트 exe로 따로 떼어내서 재생한 것.. 기능의 퀄리티 상으로 DirectMusic을 대체할 물건이 도저히 정말 전혀 없더라.
내가 프로그램을 이 따위로 비효율적으로 만들게 된 건 전적으로 마소 때문인 줄이나 알아라.

아울러, 내가 타자연습은 이 참에 ARM64용 빌드도 시험삼아 만들어 볼까 생각했으나.. 일단 보류했다.
사실상 x86 32비트에서밖에 못 쓰는 저 음악 문제도 있고, 그리고 Visual Studio의 설치 배포 프로젝트가 플랫폼을 여전히 x86, IA64, x64 셋 중 하나로밖에 지정을 못 하기 때문이다.

Windows on ARM 나온 지도 이미 수 년이 지나지 않았냐? 거기서는 msi를 도대체 어떻게 만드는지?
Visual Studio의 컴파일러 툴킷은 ARM64용이 있는데, 배포 프로젝트에는 저 플랫폼이 왜 없는 걸까?
이런 것도 마음에 안 든다. =_=;;

3. 입력기: 외부 모듈의 버그 신고

지금까지 마소 IME는 괜찮은데 내 프로그램만 한글 입력이 제대로 동작하지 않는다는 신고가 들어온 건 다음과 같다.

(1) LoL 게임=_=.. 신고 메일에 따르면 게임 중의 대화(?) 창에서는 한글 모드로 안 들어가고 영문만 입력되며.. 게임을 마치고 나온 대기 로비의 대화창에서는 한글 입력이 된다고 한다.
난 LoL을 전혀 하지 않고 프로그램 구조를 모르기 때문에 이에 대한 지원은 전혀 할 수 없다. 혹시 비슷한 현상을 겪는 분이 또 있으신지 제보를 기다린다. 스샷과 정확한 재연 방법도..

(2) 텔레그램 메신저, 그리고 AppFlowy라는 프로그램에서. 한글 입력이 덧난다거나, 한글 모드에서 입력하는 비한글 문자(세벌식 자판의 숫자, ※ 등)가 씹히고 제대로 입력되지 않는 현상이 있더라.
AppFlowy의 경우, 일반적인 입력란은 OK인데, 페이지를 하나 생성해서 제목 다음으로 본문을 입력하는 곳까지 갔을 때 오동작이 발생한다.

개인적으로는 응용 프로그램을 어떻게 만들어야 저런 오동작을 재연할 수 있는지 참 궁금하다만;;
아마 금방 쉽게 해결 가능한 문제는 아니어 보인다. 아마 해결된다면 저런 프로그램만을 위한 보정 동작이 추가될 가능성이 높다. 특히 (2) 같은 유형의 오동작 말이다.
(1)은 현재로서는 보안 프로그램으로 인한 통째로 차단이 의심된다.

아무쪼록 버그 신고를 한다면 날개셋 개발자는 그 프로그램에 대해 전~혀 모른다고 생각하고,
오동작이 일어나는 지점까지 모든 과정을 차근차근 알려주셔야 한다. 아무 입력란에서나 문제를 쉽게 재연할 수 있는 게 아니라면 말이다.
그 프로그램을 사용하기 위해서 무슨 가입, 계정 생성, 로그인 같은 게 필요한지도 안내가 필요하다.

4. Windows 최신 동향: IME 쪽

(1) 지난 몇 년 동안 Windows 동네에서는 한글 IME와 관련된 동작이 생각보다 많이 바뀌었다.
우와~~ composition의 모양이 검은 사각형이 아니라 밑줄로 바뀌었으며, capslock 같은 걸 눌러도 조합이 풀리지 않고 유지된다. 게다가 한글 조합 중에 ctrl+bksp를 눌러도 드디어 단어를 모두 지울 수 있다. (날개셋은 이전부터 이미 가능했음)

이런 건 긍정적인 변화인 것 같다. 여러 정황상 한글 IME의 동작을 중국· 일본어 IME의 동작에 맞춰 일치시킨 듯하다.

(2) Windows Terminal과 Google chrome 브라우저는 오랫동안, 지난 수 년 동안 내 프로그램 기준으로는 '보정'이 필요한 특이한 프로그램이었다.
그랬는데 지금 보니까 언제 고쳐졌는지 그 보정을 안 해도 별다른 오동작 없이 동작하도록 버그가 수정된 듯하다.
이제 그 보정 옵션은 특정 앱에 종속적인 다른 편의 기능을 제공하는 용도로 활용해도 될 것 같다.

(3) 전통적으로 한글 조합이 끝났을 때는 WM_IME_END_COMPOSITION이 오고 그 다음에 WM_IME_COMPOSITION이 뜬금없이 왔었다.
이거 30년 전 Windows 95 시절부터 변함없는 동작이었는데 이제는 후자 다음에 진짜 마지막으로 전자 END_COMPOSITION으로.. 논리적으로 맞게 바뀌었다.

이것도 긍정적인 변화이긴 하지만.. 일부 저 잘못된 동작에 딱 맞춰 동작하는 소수의 프로그램에서 오동작을 일으키는 건 어쩔 수 없다.
조합 모양과 저런 자잘한 동작들을.. 날개셋도 옵션 형태로 조만간 수용하고 업데이트 해야 할 것으로 보인다.

5. Windows 최신 동향: 나머지

(1) 언제부턴가 날개셋 한글 입력기에서 제공되는 필기 인식 기능이 동작하지 않고 있다.
Windows 10/11의 어느 빌드에서부터 내 프로그램이 지원하는 방식인 필기 인식 라이브러리를 빼 버렸다. 그건 구버전 레거시로 치부하고 자기들은 또 다른 새로운 인터페이스로 갈아탄 것 같다. 나름 이것도 Windows Vista 때부터 있던 인터페이스인데..
어휴~ 이건 또 어찌 대응 가능할지 모르겠다. 금방 되기는 어려울 듯..

(2) 그리고 win 10/11 초창기에 비해 현재는 이모지의 렌더링 속도가 엄청나게 느려졌다. 내 프로그램에서 이모지 문자표를 꺼내 보면 창이 뜨고 목록이 스크롤되는 게 무진장 굼뜨는 걸 알 수 있다.
운영체제에서 제공하는 컬러 이모지 폰트가 더 정교해지고 복잡해져서 그런 것 같은데.. 내 프로그램에서 이모지를 실시간으로 점진적으로 표기하고, 한번 표시한 이모지의 비트맵을 캐싱하는 식으로 UI와 성능을 개선해야 할 듯하다.

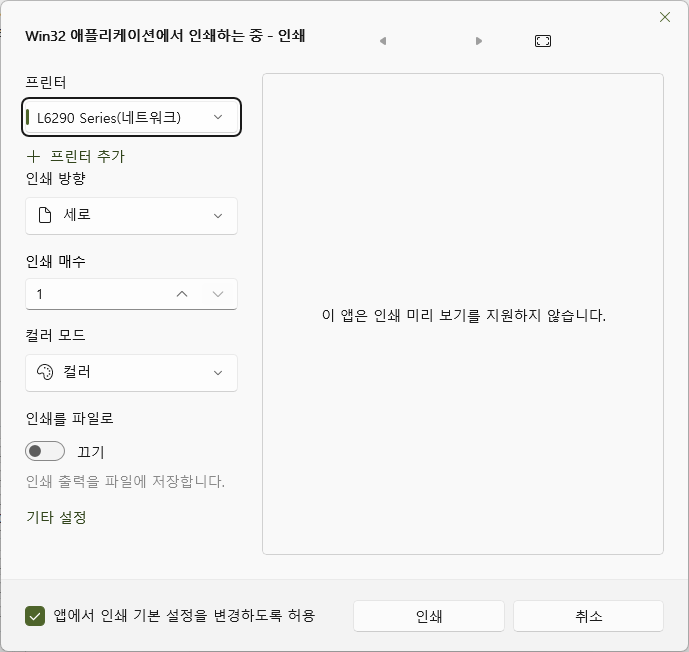
(3) 지난 Windows 11 2022년쯤 버전부터 운영체제의 인쇄 대화상자가 새끈하게, 혹은 이상하게 바뀌었다. 이게 싫다면서 다시 익숙한 옛날 클래식 대화상자로 되돌려 달라는 청원도 많으나, 마소에서는 들을 생각이 없는 듯하다.
새 대화상자는 아시다시피 인쇄 미리보기가 한데 통합도 돼 있다. 이걸 지원하려면 응용 프로그램이 Windows 11의 새로운 인터페이스를 구현해 줘야 하는데..

사용자 삽입 이미지

문제는 본인은 저걸 지원하는 프로그램, 인쇄 미리보기가 나오는 프로그램을 지금까지 단 하나도 못 봤다. 심지어 메모장이나 그림판처럼 마소 자기들이 만든 프로그램조차도 저걸 지원하지 않으니 도대체 뭐 어쩌라는 건지 궁금해진다.;;;
아마 날개셋 편집기도 이 대화상자를 미리보기까지 정식 지원하는 건 하루아침에 금방 될 것 같지 않다. 개발 우선순위가 아주 낮다. ㄲㄲㄲㄲㄲ

(4) 영문 Qwerty 글쇠배열의 대안으로 드보락이 오랫동안 유명했다. 그러나 2010년대쯤부터는 콜맥이 드보락의 지위를 위협하는 지경에 도달한 것 같다. 본인은 날개셋에서 세벌식과 콜맥을 같이 사용 중이라는 사용자 피드백을 지금까지 굉장히 많이 받았다.
콜맥이 얼마나 유명해졌으면 Windows 11 언제부턴가 콜맥 키보드 드라이버도 내장되어서 정식으로 지원되기 시작했다.

콜맥은 숫자· 기호가 기존 쿼티와 일치하고 이질감도 덜하다는 게 장점인 것 같다. 쿼티와는 완전히 다른 드보락과 다른 점이다.

(5) 이 와중에 요즘 Windows에서는 워드패드가 퇴출돼 버렸다.
mac의 TextEdit나 리눅스의 gedit는 서식 있는 텍스트(간편 워드 프로세서)와 plain text를 동시에 취급할 수 있다. Windows 메모장은 그렇지 않은데 왜 워드패드를 없앴는지.. 이것도 참 이해할 수 없는 일이다. 마소 Word의 축소판 같은 대안이 있는 것도 아닌데 말이다.

RTF는 원래 규격이 그렇게 정의돼 있는지 모르겠다만, 그닥 유니코드 친화적이지 않다. 한중일 2바이트 문자는 몽땅 다 \' 라는 탈출문자와 함께 16진수 바이트 시퀀스 형태로 바꿔서 표시하게 돼 있다.;; 이 때문에 한글· 한자가 들어간 rtf는 실제 용량보다 덩치가 굉장히 커진다.

'코드 번호로 변환' 텍스트 필터에는 C언어 정수 및 문자 리터럴, URL 등 여러 known prefix를 제공하고 있는데, 다음 버전에서는 RTF의 저 prefix도 추가할 예정이다. Windows에서 워드패드가 사라진 와중에 RTF 파일을 읽는 데 도움이 되라고 말이다.

Posted by 사무엘

2025/09/23 19:35 2025/09/23 19:35
, ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2410

1990년대 초중반 16비트 시절, 특히 Windows 3.x 시절엔 분야별로 이런 괴수들이 있었다.
30여 년 전의 아재 얘기이고 예전에 이 블로그에서도 다뤘던 얘기도 있지만 이렇게 한데 다시 정리해 본다.

1. 콜백 함수의 메모리 보정

80386 이전에는 CPU 차원에서 메모리 가상화 내지 보호라는 게 존재하지 않았다. 그런 환경에서 멀티태스킹이라든가 64KB 이상 메모리 접근을 구현하려다 보니 프로그래밍이 지금과는 비교할 수 없이 구리고 불편한 구석이 많았다.
운영체제에다 내가 만든 대화상자 콜백 함수를 하나 지정하려 해도 그 포인터를 바로 못 넘겨주고 이 콜백의 소유자가 누군지 레지스터에다 써 넣는 thunk를 감싸서 줘야 했다.

그래서 함수 전처리/후처리 thunk를 생성해 주는 MakeProcInstance와 FreeProcInstance라는 API가 제공됐는데..
마소의 직원도 아닌 Michael Geary라는 프로그래머가.. 빌드된 실행 파일을 살짝 후처리만 함으로써 저런 번거로운 절차 없이 콜백 호출이 되게 하는 기법을 발견해서 공개했다. (☞ 링크)

이건 이 바닥 업계를 크게 놀라게 했다. Windows를 개발한 마소에서도 자기들이 생각한 것보다 더 간편한 방법이 있었다는 것에 놀랐고, 이 기법을 차기 버전인 Windows 3.1에다 시스템 차원에서 정식 적용했다.

즉, 제3자 프로그래머는 Windows 3.0과의 호환성을 생각한다면 일일이 thunk를 만들어 주든가, 아니면 저 FixDS라는 툴로 후처리를 하면 되고..
3.1만 생각하면 된다면 저런 것 없이 프로그램을 편하게 만들면 된다.

2. 32비트 extender

Windows 3.x는 enhanced 모드에서 386 CPU에서 제공되는 멀티태스킹 관련 일부 기능만 사용할 뿐, 일단은 DOS와 마찬가지로 16비트 프로그램이었다.
그런데, 심지어 1993년에 Windows NT 3.1과 함께 PE 실행 파일과 Win32 API라는 게 정식으로 공개조차 되기 전에..!!!!
마소가 아닌 제3자 싸제 개발사에서 Windows 3.1을 위한 32비트 extender 런타임을 만든 경우도 있었다.

에 그러니까.. 옛날 도스용 게임에서 사용하던 DOS/4GW 같은 런타임의 Windows판이며, Win32s 같은 물건을 마소 말고 딴 데서 만들었다는 것이다. 미친;;
C/C++ 컴파일러로 유명했던 Watcom에서 Win386이라는 익스텐더를 만들었으며, 데이터베이스 앱인 Foxpro가 대표적으로 얘를 기반으로 동작했다. (☞ 관련 링크)

3. 32/16비트 flat thunk

Windows 95가 개발된 뒤, 마소에서는 32비트 코드와 16비트 코드 사이의 호환성 계층을 뚫어 주는 일에 진심이었다.
32비트 EXE에서 레거시 16비트 DLL의 함수를 호출하려면 뭐 thunk compiler를 돌려서 뭘 감싸 주고 메모리 주소를 무슨 세그먼트로 바꾸고 어쩌구저쩌구.. 했는데~

그 당시 Windows 95 Programming Secrets의 저자인 Matt Pietrek은 리버스 엔지니어링을 통해 마소에서 공개하지 않은 내부 API를 끄집어냈다.
이걸로 훨씬 더 간단하게 16비트 코드로 들어가는 방법을 공개하니 마소에서 그 당시에 크게 놀랐다고 한다. (☞ 관련 링크)
그 당시에 32비트 프로그램에서 시스템 리소스가 몇 % 남았다고 정보를 표시하는 건 이런 경로를 거쳐서 16비트 API를 호출해서 알아 온 것이었다.

4. 통째로 한글화

하긴, 꼭 외산 소프트웨어 말고 개인적으로 ‘한메한글 for Windows’도 굉장히 대단한 작품이었다고 생각한다.
Windows 3.x라는 준 운영체제를 통째로 마개조해서 없는 문자를 인식하게 만든 거니까.. 유니코드 시대가 도래하기 전에 말이다.

영문 원판에다가 한메한글만 씌운 게.. 마소 한국 지사에서 만든 정식 한글판보다 더 가볍고 성능이 뛰어났다. 그래서 그 시절 컴잘알들은 Windows를 그렇게 사용하기도 했다.
물론 16비트 시절에는 시스템이 불안정한 대신, 단독으로 시스템 전체에 영향을 주는 프로그램을 만들기도 훨씬 더 쉬웠었다.

그러고 보니 Windows 3.x 시절에는 껍데기 셸도 통째로 싸제 프로그램으로 갈아치우는 게 가능했다.
구닥다리 MDI 프로그램인 '프로그램 관리자' 말고 Norton Desktop을 띄운다거나, 한컴에서도 아래아한글 3.0x 시절에 '한컴 셸'이라고 꽤 괜찮은 유틸리티를 같이 선보인 적이 있었다.
이런 셸을 띄우면 Windows도 macOS라든가 NextSTEP 같은 타 운영체제와 더 비슷한 외형으로 바뀌었었다.

싸제 셸 프로그램 트렌드는 Windows 95에서 내 컴퓨터와 탐색기를 담당하는 전능하신 explorer 셸이 등장하면서 종결됐다. 이것도 참 재미있는 옛날 추억이다.;;

5. 비공식 그래픽 모드

끝으로, Windows 얘기는 아니지만..
Michael Abrash라는 프로그래머는 VGA 그래픽 카드의 스펙을 잘 뜯어보다가 제조사에서 정식 공개한 적 없는 기능을 찾아내서 발표했다.
그 당시 게임에서 많이 사용하던 320*200 mode 0x13 말고, 320*240 같은 해상도를 지원하는 일명 mode X 말이다. (☞ 관련 링크)

이 사람이 개발한 기술은 Doom 다음으로 Quake라는 FPS 게임에 도입됐다.
우리나라에서 옛날에 개발됐던 아마추어 슈팅 게임인 ‘85되었수다 / 삭제되었수다’도 내 기억이 맞다면 일반적인 mode 13h 말고 저 mode X 파생 그래픽 모드를 사용했었다.

Posted by 사무엘

2025/05/14 08:35 2025/05/14 08:35
,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2377

템플릿 얘기가 좀 길어졌는데.. 다음 주제는 가상 함수와 관련된 엉뚱한 생각이다.
C++이라는 언어는 앞서 잠깐 언급했던 바와 같이, '오버로딩과 오버라이딩' 사이에 뭔가 견제를 하는 게 있다.
그것과 비슷하달까, C++은 오버라이딩과 멤버 함수 포인터 사이에도 디자인 차원에서 선을 긋는 게 있어 보인다.

무슨 말이냐 하면.. 가상 함수가 존재하는 어떤 객체가 주어졌을 때, 이 객체가 참조하는 vtable 값을 직접 확인하는 것을 언어 차원에서 전혀 허용하거나 지원· 고려하지 않는다.
이 객체의 어떤 가상함수는 부모 클래스의 것과 같은지, 아니면 오버라이딩 됐는지.. 이런 것을 알 수 없다.

&obj->Foo == &TBase::Foo 이런 식으로 비교하는 거?? 가상과 비가상 불문하고 다 안 된다. 클래스의 non-static 멤버 함수의 주소를 얻는 건 컴파일 타임 바인딩이 가능한 &클래스::멤버 형태만 허용될 뿐, 런타임 바인딩인 &변수->멤버는 안 된다. 그냥 컴파일 에러로 처리된다.

멤버 함수 포인터를 이용해서 pFunc에다가 특정 클래스의 Foo를 집어넣었더라도.. (obj->*pFunc)()를 호출해 보면 obj->Foo()를 호출한 것과 동일하게 접수된다.
멤버 함수 포인터에는 자신의 vtable을 참조해서 그걸 호출해 주는 thunk 함수만 연결되기 때문이다. 그 아래의 vtable 상의 주소로 다이렉트 접근이나 제어는 안 된다! 신기하지 않은가?
(하긴, 다중 상속 체계에서는 this 오프셋 보정도 이런 thunk가 하는 일 중 하나이겠지만)

C++ 클래스에서 vtable이란 걸 바이너리 차원에서 꼭 이렇게 구현해야 한다고 C++ 표준에 규정돼 있지는 않다.
그러나 실제로 구현되는 방식은 컴파일러 불문하고 거의 뻔할 뻔자이다. 그렇기 때문에 다음과 같은 동작을 억지로 구현해 줄 수 있다.

class Base {
public:
  int x;
  virtual void VF1() {}
  virtual void VF2() {}

  void* GetFuncPtr(int n) { //0: VF1, 1: VF2
    void*** pppf = (void***)this;
    return (*pppf)[n];
  }
};

무려 삼중 포인터가 쓰인 GetFuncPtr이라는 저 함수를 주목하시라. void에 대한 포인터(1)의 배열(2)을 가리키는 포인터(3)이기 때문에 삼중이 된 것이다.
가상 함수가 들어있는 클래스는 맨 첫 멤버가 vtable 포인터이기 때문에 this에 대해 저런 형변환이 가능하다.

그 다음으로, Base에 대해 1번 함수를 오버라이드한 Derived1, 2번 함수를 오버라이드한 Derived2, 그리고 둘 다 오버라이드한 Derived3. 이 세 클래스를 다음과 같이 선언해 보자.

class Derived1 : public Base {
public:
  int y;
  virtual void VF1() {}
};

class Derived2 : public Base {
public:
  int z;
  virtual void VF2() {}
};

class Derived3 : public Base {
public:
  int w;
  virtual void VF1() {}
  virtual void VF2() {}
};

요렇게 한 뒤, Base, Derived1, Derived2, Derived3 아무 객체나 선언해서 GetFuncPtr(0)을 호출해 보면 Base와 Derived2는 같은 값을 되돌린다. Derived2는 VF1을 오버라이드 하지 않았기 때문이다.
GetFuncPtr(1)을 호출해 보면 Derived1이 Base의 것과 같은 값을 되돌린다. 이유는 동일.

그렇다고 이 주소값은 &Base::VF1, &Derived2::VF2 처럼 실존하는 멤버 함수의 주소를 C++ 연산자를 통해서 얻은 주소값과 일치하지 않는다. 이거는 멤버 함수 포인터에다가 대입해서 호출을 할 수 있지 않다.
애초에 멤버 함수 포인터는 일반 함수 포인터와 달리 임의의 정수형으로부터 대입하는 게 아예 불가능하지 싶다. reinterpret_cast나 C-style cast도 되지 않는다.
그러니 저 값은 그냥 클래스 간에 값이 같은지 다른지 비교 용도로만 써먹을 수 있을 뿐이다.

그리고 사실은 언제나 저렇게 가상 함수 2개짜리 vtable이 생긴다는 보장도 없다.
클래스를 만들어서 멤버 함수를 virtual로 선언했지만 실제 코드에서 이 클래스의 인스턴스를 한 번도 포인터로 접근하지 않아서 런타임(다이나믹) 바인딩이 필요하지가 않다면..
컴파일러가 최적화 스킬을 발휘해서 vtable을 곧이곧대로 만들지 않을 수도 있다. 그러면 우리가 저렇게 만든 GetFuncPtr 함수도 제대로 맞게 동작하지 않을 것이다.

일반적인 함수라면.. 형태가 너무 단순해서 컴파일러가 평소에는 인라이닝이나 인트린식으로 실컷 최적화한다고 하더라도 그 함수의 주소가 필요할 때는 일반적인 함수 포인터 값이 반드시 제공돼야 한다. 최적화는 부가 기능일 뿐이지만, 함수 포인터는 언어 스펙에서 제공되는 필수 기능이기 때문이다.
그러나 vtable에 명시된 함수 주소는 그렇게 공식적으로 제공되는 기능이 아니다. 프로그래머가 언제까지나 꼼수로.. at your own risk를 염두에 두고 써야 한다.

이상이다.
글을 맺으면서 문득 드는 생각인데.. C++의 RTTI (런타임 type info)가 내부적으로 구현되는 방식도 가상 함수가 구현되는 방식과 아주 밀접한 관계가 있으며, 서로 떼어서 생각할 수 없어 보인다.

vtable이라는 게 결국은 한 클래스와 무조건 일대일 대응하는 고유한 정보이니, 참조하는 vtable이 동일한 객체는 동일한 클래스의 인스턴스임이 보장되기 때문이다.
그러니 자기 클래스의 이름이라든가, 부모 클래스 목록 같은 RTTI도 vtable과 함께 두거나 최소한 RTTI를 가리키는 포인터를 vtable에다가 둘 법도 해 보인다. dynamic_cast 연산자는 그런 정보를 참조하면서 동작하면 될 테고.

아 그런데.. 이런 깔끔한 관계는 단일 상속 체계에서나 보장되겠다;;
다중 상속이라면 2개째 이후의 기반(부모) 클래스에 대해서 매번 vtable 포인터가 또 추가될 테니 일이 정말 복잡해지겠다.
단일 상속에서는 복잡도가 뭔가 1씩 더해지는 것만 생각하면 됐는데, 다중 상속에서는 2씩 곱해지는 수준으로 복잡도가 폭발적으로 증가한다.;;

그러니 C++ 표준화 이전부터 RTTI를 자체 구현했던 C++ 프레임워크들은(가령, MFC 같은 골동품) 그런 건 깔끔하게 포기하고 단일 상속만 염두에 두고 저런 기능들을 구현했지 싶다.

말이 길어져 버렸는데.. 암튼 이 글의 결론은
"이 ptr은 Base의 파생 클래스이긴 한데요, 특정 무슨 함수가 오버라이드 돼서 Base의 원래 것과는 달라졌는지 아닌지만 좀 알 수 있을까요?"
요건 언어 차원에서 알려주지 않는다는 것이다. 그런 건 query하는 함수를 사용자가 수동으로 구현해 줘야 한다.

Posted by 사무엘

2025/04/17 08:35 2025/04/17 08:35
,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2374

객체지향 언어라면 파생 클래스 코드에서 기반 클래스의 멤버에 접근하는 것이야 너무 당연히 가능하다. 상속을 protected나 public으로 받기만 했다면 말이다.
기반 클래스의 scope에서 선언된 내부 클래스라 하더라도 마음껏 인스턴스를 만들고 참조할 수 있다.

class Base {
protected:
  int x;
  class InnerClass {
  public:
    int z;
  };
};

class Derived: public Base {
public:
  void Foo() {
    x = 100; //base 꺼
    InnerClass o; o.z = 100; //base 꺼
  }
};

그런데 이게 평범한 클래스가 아니라 ‘템플릿 클래스’라면 상황이 어찌 될까?

template<typename T>
class TBase {
protected:
  int x;
  class InnerClass {
  public:
    int z;
  };
};

template<typename T>
class TDerived : public TBase<T> {
public:
  void Foo() {
    x = 100;
    InnerClass o; o.z = 100;
  }
};

한동안은 이 코드는 잘 통용됐다. 문법적으로 아무 하자가 없어 보이지 않는가? 내가 아는 한 Visual C++ 2010 컴파일러 정도까지는 이상이 없었다.
그런데 2010년대에 C++ 표준이 바뀌었는지.. 저건 후대의 버전부터는 컴파일되지 않고 오류를 일으키기 시작했다.
2019/2022에서 말이다. 그 사이에(2012, 13, 15, 17??) 정확히 언제부터 변화가 생겼는지는 잘 모르겠다.

TDerived에서 기반 클래스 멤버인 x에 접근하는 것 자체가 언어 차원에서 봉쇄되고 금지된 건 아니다. 단지, 템플릿 클래스에서 코드의 의미 명료화를 위해 좀 깐깐한 조치가 취해진 것 같다.

TDerived에서 x에다 접근하려면
this->x 라고 일일이 쓰든가, 아니면 TBase<T>::x라고 타입을 명시해 줘야 한다. 그 x를 지칭하기 위해서 어쨌든 x 단독으로 방치만 하지 않으면 된다.

CInternalClass도 주변에다 좀 decoration을 해 줘야 한다. 얘는 멤버 변수나 함수가 아니라 타입이다 보니.. typename 내지 using 처방을 해 주면 된다.
참조할 때 매번 typename TBase<T>::InnerClass 이러던가..
아니면 TDerived의 선언부에다가 using InnerClass = TBase<T>::InnerClass 이렇게 박아 주고 나서 다음부터 InnerClass만 쓰면 된다.

흐음~~
내가 기억하기로 C++에서 템플릿이라는 건 처음 도입됐던 시절엔 거의 C++판 매크로나 마찬가지였다.
템플릿 인자가 무엇이 들어오느냐에 따라 코드의 의미가 귀에 걸면 귀걸이, 코에 걸면 코걸이(특히 값이냐 타입이냐)처럼 완전히 달라질 수 있었기 때문이다.

T가 int냐, double이냐, 1000바이트 짜리 뚱뚱한 클래스냐~ 이거는 컴파일러 입장에서 단순히 코드 생성이나 최적화 전략만을 좌우할 것이다.
그러나 T::member 이런 거는..? T에 어떤 클래스가 오느냐에 따라서 member는 멤버 변수? 멤버 함수? 심지어 내부의 다른 클래스/enum 이름이 될 수도 있다. 멤버라 하더라도 static 멤버가 될 수 있고, non-static이 될 수도 있다!

이러니 템플릿 코드는 그거 단독으로 문법 체크를 하는 게 매우 난감했다.
템플릿에다가는 그 어떤 아무말을 씨부려 놔도 그 자체는 컴파일러가 전혀 개의치 않고 넘어갔다. #define MACRO(x) 그 다음에 그 어떤 아무말을 씨부리건 이것만으로는 컴파일 에러가 발생하지 않는 것과 같은 이치이다. 에러는 이 매크로를 사용하는 곳에서 발생할 뿐..

템플릿도 TBase<int>건 TBase<POINT> 처럼 그 템플릿에다가 인자를 줘서 실제로 사용할 때에야 파싱과 코드 생성이 시작됐다. 그때에야 에러가 발생했다.

그랬는데.. 요즘 C++ 언어의 디자인 추세는 템플릿이 너무 무질서하고 자유도가 너무 높은 것을 통제하려는 것 같다.
특히 템플릿만을 단독으로도 최대한 분석한다. 템플릿 인자로 그 무엇을 넣더라도 그와 무관하게 무조건 구문 실패와 에러가 발생할 만한 것은 굳이 템플릿을 실제로 사용하지 않더라도 지적해 준다.

일례로, 위의 코드에서 TDerived::Foo() 안에다가 x=100이 아니라 y=100을 넣으면 바로 에러가 난다.
이렇게 하려다 보니 T::member라는 토큰은 템플릿 인자 T에 무엇이 들어오건 최소한 멤버인지 타입명인지 정도는 고정적으로 의미 보장이 돼야겠다. 그래서 typename T::member 같은 조치가 취해졌다.

그리고 T에 무엇이 들어오건 주변 문맥을 고정시켜야겠으니 implicit하게 부모 클래스 멤버에 접근 가능하던 혜택(?)도 없어진 것이다.
그 혜택을 다시 입고 싶으면 using을 활용해서 직접 요청을 해야 된다. using은 typedef의 상위 호환 대체제이기도 하니..

왜, 같은 이름의 함수로 오버로딩과 오버라이딩을 동시에 시도했을 때도(예: virtual void foo()와  void foo(int)를 동시 시도) 파생 클래스에서는 오버라이딩 되지 않은 부모 클래스 멤버로 자동 접근하는 건 "막힌다". 그런 것과 비슷한 느낌이 든다.
막힌 멤버로 접근하려면 역시 부모 클래스 이름을 일일이 써 주거나, using Base::foo 라고 자동 접근 요청을 해야 된다. 이 조치도.. 나중에 일부러 취해진 것이다.

C++ 템플릿은 임의의 타입들을 다 boxing해서 단일 바이너리(컴파일된 코드)만으로 모든 템플릿 인자를 담당하는 '제네릭' 같은 물건이 아니다. 하지만 그렇다고 정말 귀걸이 코걸이가 다 되는 C++판 매크로도 아니니.. 그 중간의 다른 무언가를 지향하는 것 같다.

자, 본인이 이 글을 쓰게 된 계기는..
이 홈페이지의 옛날 자료실에 있는 "정렬 알고리즘 모음집" C++ 코드가 최신 컴파일러에서는 컴파일되지 않는다는 걸 뒤늦게 발견했기 때문이다.
템플릿 클래스 사이에 상속을 구현했는데.. 이제는 코드를 한참 뜯어고쳐야 컴파일 될 것 같다. ㄲㄲㄲㄲㄲ
이 참에 옛날 자료실을 다 github로 옮기는 것도 생각해 봐야겠다.

Posted by 사무엘

2025/04/14 13:00 2025/04/14 13:00
, , ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2373

C와 C++ 언어의 역사

※ C 언어는..

- 1972년에 '데니스 리치'라는 사람이 유닉스 운영체제를 개발하던 과정에서 고안했다. 지난 2011년에 스티브 잡스와 거의 1주일 간격으로 나란히 부고 소식이 전해졌던 그 사람 말이다.
- B라는 프로토타입을 거친 뒤, B 다음으로 C라는 이름이 붙었다. 참고로 B의 이전에는 알골(Algol)이라는 조상뻘 언어가 있었다.
- let it be 노래를 패러디한 write in C라는 개드립이 유행했었다.

- 초창기에는 const 지정자라는 게 없었다나 어쨌다나.. func(a) int a; 이런 기괴한 문법도 통용됐다.
- 그러다가 1989년에 처음으로 문법과 라이브러리에 표준화가 논의됐다. K&R C와 ANSI C의 구분이란 게 이때 처음으로 생겼다.
- 그 뒤 한참 나중에 C99가 나왔다. // 주석이라든가 inline 키워드는 그 전부터 C++에서 야금야금 가져온 아이템들이지만, 가변 길이 배열, 가변인자 매크로, restrict 같은 것은 C++과 무관하게 독자적으로 발생한 변화이다.

- C는 타 언어들과 달리 모든 정수형에 unsigned 구분이 철저히 존재하고, 초기화되지 않은 변수라는 게 존재하고, 런타임 에러 체킹이 별로 없고 생포인터를 직접 취급할 수 있고.. 독특했다.
이런 건 프로그래밍 언어 이념을 구현하기 위한 오버헤드를 최소화하고, 언어의 구현과 빌드된 바이너리를 최대한 가볍게 만들기 위한 노력의 산물이었다.

- C는 디자인 차원에서 type-safety가 낮은 축에 드는 언어인데, 첫 초창기에는 그게 더 낮았다. 변수나 매개변수, 함수의 리턴값 같은 데에 타입 지정을 생략하는 것에 엄청 관대했다. 포인터고 enum이고 논리값이고 문자고.. 개나 소나 int 정수 취급을 너무 좋아하는 언어였다.

- C의 장점으로 제기되는 "이식성이 뛰어나다"라는 말은.. 쌍팔년도 시절 어셈블리어에 비해서 C가 정말 참신하고 편했다는 걸 의미한다. 에 그러니까 "IBM PC 호환 기종"이라는 용어가 유의미한 변별력이 있던 시절, 게임기 전용 아키텍처라든가 슈퍼컴 전용 아키텍처도 있던 시절 말이다. ㄲㄲㄲ
오늘날 같은 언어 중립 바이트코드 가상머신(JVM, .NET..)까지 염두에 두고 나온 말은 아니다.

하긴, 컴퓨터는 16비트 정도 성능은 돼야 고급 언어 컴파일러를 돌릴 수 있지 않겠나 싶다. 8비트 컴에서 돌아가는 임베디드 급 프로그램을 C로 짜려면 아무래도 크로스 컴파일을 해야지, 8비트에서 바로 구동 가능한 건 어셈블러가 전부이지 않겠나.
Java/C# 같은 가상머신 바이트코드 언어는 당연히 32비트 이상의 CPU와 주소 공간이 필요할 테고 말이다.

뭐, 이식성이라는 게 중요하긴 하다. C를 주력 언어로 써서 개발된 Windows NT, Doom 게임 등등은 오만 가지 플랫폼으로 포팅되어 현재까지 살아남아 있는 반면,
어셈블리어만 썼던 OS/2, dBASE, Lotus 123 같은 고전 프로그램들은 오래 못 가고 역사 속으로 사라졌기 때문이다.
당대의 열악한 하드웨어에서는 온갖 성능 짜내면서 잘 돌아갔지만, 도무지 포팅이나 유지보수가 안 됐으니.. 하드웨어가 바뀌자 오늘만 살고 내일이 없는 프로그램으로 전락했다.

- Quake 3 arena는 1999년 말에 출시된 FPS 게임이지만, 이때까지만 해도 존 카맥 옹은 C++이 아닌 C만 써서 얘를 코딩하고 개발했던 걸로 잘 알려져 있다. 물론 그 뒤부터는 C++이 사용되기 시작했다;;
- C11에서는 해도 너무한 보안 빵점 함수이던 gets를 deprecated도 아니고 하위 호환성 따위 무시한 채, 그냥 처음부터 있지도 않았던 함수인양 존재를 없애 버렸다. 그리고 qsort의 콜백에다가 void* context 인자를 추가한 qsort_s도 정식으로 도입했다.

※ C++ 언어는..

- 비야네 스트로스트럽인지 어쩌구.. 이름이 난해한 분이 1979년에 C with classes라는 이름으로 맨 처음 발표했다.
- 그러다가 1983년에 이름이 C++로 바뀌어 확장됐다. C에다가 변수 증가 연산자 ++를 집어넣은 셈.
(참고로 C++ 이후에 나온 언어는 D도 있고 +의 개수를 더 늘려서 형상화한 C#도 있다. ㄲㄲㄲ)

- 다중· 가상 상속, placement new, const 함수, protected (public/private뿐만 아니라), 모든 연산자들의 오버로딩 같은 건 처음부터 있지는 않았고 1980년대 말에 추가로 도입됐다. 처음엔 대입 연산의 오버로딩 정도만 생각했대나 어쨌대나..
이때는 C++ 언어 자체에 대해 1.0, 2.0 하는 버전 넘버링이 있었다고 한다.

- 이 언어는 초창기에는 C++ 코드를 C 코드로 변환해 주는 컴파일러의 형태로 구현됐었다. 이름하여 CFront. 이건 기계어가 아니라 똑같은 고급 언어로의 번역이지만 전처리기 수준이 아니라 엄연히 컴파일러였다.
CFront는 1990년대 초까지 유지보수 되다가 중단됐다. 나중에 추가된 exception 기능을 넣는 게 C의 사고방식만으로는 도저히 무리였던 듯..

- PC 환경에서 최초의 기계어 직통 C++ 컴파일러는 1987~88년쯤.. VGA 그래픽 카드와 비슷한 타임라인 때 등장했다. C가 Lattice C가 거의 원조라면, C++은 Zortech C++가 원조다. (훗날 Symantec C++)
유명 제조사인 마소와 볼랜드는 1990년쯤 돼서야 C++ 컴파일러를 내놨다. 얘들이 1989년 전후해서 C 컴파일러의 버전업이 없었던 이유가 아마 C++을 첫 구현하느라 바빠서였지 싶다.;;

- 그러다가 1990년대 초에 기초적인 템플릿이 도입됐고 예외 기능도 추가됐고.. 언어와 라이브러리의 표준화가 논의되기 시작했다. 내가 도스 16비트 환경에서는 템플릿이나 예외는 못 써 봤다.;;
- 첫 표준 규격은 C++98이다. 이때 *_cast 형변환 연산자, namespace, explicit, typeid, true/false 등등이 들어갔다. C++이 C언어 물을 벗고 type safety를 뒤늦게나마 더 강화하기 시작했다.

- 이때쯤 기존 C++ 라이브러리들이 다 std namespace 안으로 들어가고, 헤더 파일 명칭에서 확장자 .h가 없어졌다.
- 그 뒤 2000년대 중반까지 C++은 10년 가까이 별 변화가 없었다. 중간에 템플릿 export 기능을 넣으려고 하다가 컴파일러 제조사들로부터 반발에 부딪혀 영구봉인해 버리는 흑역사가 있었다만.;;

- 그러다가 2010년대.. C++0x를 거쳐서 C++11에서 C++이 auto, nullptr, 람다(!!), R-value 참조자 등등을 도입하면서 modern C++이라는 새로운 언어로 환골탈태를 시작했다.
- C++11인지 14인지부터는 스마트 포인터도 auto_ptr 대신 unique_ptr, shared_ptr 등으로 세분화됐다.
- 지금 C++은 템플릿과 auto 람다에다가도 가변인자가 들어가고 <=> 우주선 연산자도 들어갔고 진짜 10년~20년 전과도 다른 난해하고 복잡한 언어가 됐다.

C++은.. 처음부터 치밀하게 설계된 언어가 아니라 오랫동안 점진적으로 자라고 진화하고 표준화도 꽤 늦게 된 언어이다. 이게 문제다.
이렇게 타이밍을 놓친 것 때문에 1990년대 초부터 개발됐던 C++ 라이브러리 프레임워크들은 자체적으로 제각기 중구난방 중복 구현해 놓은 범용 오브젝트, 문자열, 리스트/배열 컨테이너들이 넘쳐난다.;;; C#/Java의 세계에서는 상상도 할 수 없는 혼란일 것이다.;;

난 도스 시절에 글자를 찍을 때 C의 puts를 쓰면 exe 파일이 1만 바이트대밖에 안 나왔던 반면, C++ cout을 쓰면 파일이 4만 바이트를 넘는 거 보고는 cout을 안 쓰기 시작했던 기억이 있다.. ^^

Posted by 사무엘

2025/02/03 08:35 2025/02/03 08:35
,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2361

컴퓨터 업계에서 인텔의 경쟁사라고 하면 가장 먼저 (1) 동급의 x64 CPU를 만들어서 경쟁하는 AMD,
(2) 아키텍처 차원에서 x64에 도전하는 ARM 내지 애플, 혹은 심지어 (3) 울나라 삼성 전자까지 떠올릴 수 있다. 인텔이 메모리 반도체에도 손을 뻗치고 있기 때문이다.
그런데 인텔은 저것들보다는 대외 인지도가 낮은 분야에서 AT&T와도 경합한 게 좀 있었다.

1. 바이너리: 오브젝트 파일 포맷

C/C++ 언어로 코딩을 한 뒤에 컴파일을 돌리면 생기는 자잘한 obj 파일들 말이다. 기계어 코드를 담는 이 컨테이너 껍데기의 포맷은 누가 언제 제정했을까?
x86 진영에서는 CPU 본가인 인텔에서 제정한 OMF 방식이 16비트 시절부터 널리 쓰였다. 볼랜드니 마소니 컴파일러가 다르더라도 obj 파일은 호환됐기 때문에 툴을 달리하여 링크가 가능했다.

그러나 마소에서는 32비트 Windows NT를 개발하면서 실행 파일 포맷을 바꾸고(NE에서 PE), 빌드 툴체인도 싹 갈아치웠다. 단순히 OMF의 32비트 확장을 쓰는 게 아니라 obj/lib의 포맷도 AT&T에서 제정한 COFF 방식으로 바꿨다. 그 반면, 볼랜드 컴파일러들은 32비트에서도 여전히 OMF 방식을 쓰면서 서로 파편화가 발생하게 됐다.

그 시절에 마소에서는 빌드를 더 편하게 하기 위해서, 로딩을 더 빠르게 하기 위해서(메모리 매핑), 거기에다 이식성까지 고려해서 같은 여러 명분으로 COFF를 도입했었다. 다만, 지금은 그런 명분이 기술적으로 많이 옅어지고 사라지기도 했다.

그러고 보니 GNU 툴킷의 도스용 버전에 속하는 djgpp 컴파일러도 라이브러리· 오브젝트 파일 포맷은 COFF 방식이었던 걸로 기억한다. 바이너리 에디터로 들여다보면 arch! 앞에 이런 문자열이 있고.. "이건 마소 진영과 오픈소스 진영이 공통이네?" 이런 생각을 예전에 했었다.

2. 텍스트: 어셈블리어 문법

자기네 x86 기계어를 간단한 숫자와 영단어 나열만으로 풀어서 표기하는 어셈블리어 말이다. 이것도 인텔 식 문법과 AT&T 식 문법이 공존한다. 이건 단순히 '어셈블러' 제조사 간의 문법 차이가 아니라 '어셈블리어' 차원에서의 더 저수준 차이점이다.

인텔 문법 AT&T 문법
mov eax, 5
add esp, 24h
movsxd rax, ecx
paddd xmm2, xmm1
movl $5, %eax
addl $0x24, %esp
movslq %ecx, %rax
paddd %xmm1, %xmm2

간단하게는 숫자 앞에 $, 레지스터 이름 앞에 %가 막 붙어 있는 게 AT&T 문법인데, 본인 역시 Visual C++이 표시해 주는 인텔 문법에만 익숙하다. 하지만 역시 리눅스 진영 gdb 같은 데에서는 AT&T 문법이 주류이다.
현업에서 어셈블리어를 직접 짤 일은 없지만, 그래도 프로그램을 디버깅 하다 보면 디버거가 디스어셈블리해 준 어셈블리어 코드를 보게는 된다.

마소는 이거 문법은 딱히 AT&T 식으로 갈아타지 않았고 인텔 문법을 고수하는 듯하다. Macro Assembler 같은 기존 제품과의 호환 문제가 있기 때문인 듯하다.
뭐, 어차피 같은 CPU 아키텍처이고, 짜는 게 아니라 읽기만 한다면야 자잘한 표기 차이는 그렇게 심각한 차이점은 아닐 것이다.

프로그래밍 언어라는 건 적당히 고급 언어를 표방하면서 실용성을 갖춘 게 인기를 얻고 대중화되는 편이다.
그럼 실용성 대신에 한쪽으로 특화된 언어는 (1) 함수형처럼 수학 내지 순수주의 쪽으로 특화되거나, 아니면 (2) 어셈블리어처럼 기계 지향적인 쪽으로 특화되는 것 같다.

한 소프트웨어의 모든 코드를 저런 특화 언어만으로 작성하는 건 아무래도 무리이다.
그래서 기존의 실용적인(?) 다중 패러다임 언어들은 저 (1), (2)의 특성을 제한적으로 부분적으로 제공하곤 한다. 그게 (1) 람다 아니면 (2) 인라인 어셈블리인 셈이다.;;

요즘 세상에 대학교 컴공과에서 어셈블리어 코딩 실습을 하는 건 군대에서 총검술, 사관학교에서 승마 실습을 잠깐 하는 것과 아주 비슷한 모양새인 것 같다.
비록 현대의 전장이나 현대의 소프트웨어 개발 방법론과는 완전히 동떨어져 버렸지만, 코딩이라는 전투에서 백병전이 어셈블리어 실습이 아니겠나..;; =_=;; 실무에서는 쓸 일이 없지만 컴공 엔지니어를 양성한다는 학교에서는 컴퓨터의 밑바닥 모습을 이런 식으로라도 경험시켜 줄 필요가 있을 것이다.

Posted by 사무엘

2024/06/30 08:35 2024/06/30 08:35
, , , , ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2314

온라인 게임을 개발하는 프로그래머는 클라이언트 내지 서버 개발자로 역할이 크게 나뉜다.

사용자가 자기 머신에(PC 내지 폰) 직접 설치해서 구동하는 그 exe / apk야 클라 개발자의 작품이다.
현란한 그래픽을 구현하고, 같은 하드웨어에서 화면 프레임 수를 늘리려고 고생하는 애들 역시 클라 개발자이다.
그러나 수많은 사용자들을 동시에 수용하고 계정 정보를 관리하고, 이것들이 해킹당하지 않게 보호하고, 클라가 뿌릴 게임 내부 상태를 전해 주는 건.. 서버 및 서버 개발자의 몫이다.

클라 프로그램이 뻗는 건 그 사용자만의 문제이지만, 서버가 뻗는다면....;;;; 뭐 그렇다.
조금 어설프게 비유하자면 클라는 또박또박 보도를 하는 뉴스 앵커이지만, 서버는 뉴스 대본을 생성하고 보도 순서와 분량을 정하는 보도국뻘 된다.

그런데 데스크톱이나 모바일 '앱' 말고 웹 개발로 가면.. 프런트 엔드와 백 엔드라는 계층 구분이 있다.
웹 프로그램은 머신에 설치되는 게 아니라 웹브라우저 화면에서 바로 구동된다. 그렇기 때문에 개념적으로는 클라라는 게 없고 서버 프로그램만 있는 것 같다.

하지만 거기서도 계층 구분이 있다. 사용자한테 보이는 부분, 더 기술적으로는 js html css처럼 서버로부터 받기는 했지만 사용자의 웹브라우저에서 구동되고 사용자가 소스를 직접 볼 수 있는 부분은 프런트 엔드이다.
그 반면, 저런 html을 생성하는 프로그램이라든가 DB처럼.. 진짜로 서버에서만 돌아가고 사용자가 코드를 볼 수 없는 부분은 백 엔드라고 불린다.

프런트 엔드 웹 개발자는 웹 '디자이너'와 영역이 겹치며 같이 작업하게 될 수 있다.
그러나 백 엔드는 디자이너와의 접점이 없으며, 그 대신 Java, C#, 심지어 C++처럼 머신 종속적인 데스크톱용 프로그래밍 언어와 접점이 있을 수 있다. (사용하는 프레임워크가 무엇이냐에 따라)

글쎄, php는 딱히 기계 종속적이지 않으면서 백 엔드 개발에 최적화된 언어인 듯하다.
JavaScript야 웹 개발계의 유니코드요 세계공용어로 등극했으며, 프런트와 백에서 모두 쓰이고 있다.

원래 컴퓨터 업계에서 '프런트/백 엔드' 이런 말은 컴파일러에서 주로 쓰이던 용어였다. 구문 해석해서 parse tree 내지 IR(중간 표현)을 생성하는 게 프런트이고, 이걸로부터 실제 머신 코드를 생성하고 최적화도 하는 게 백이었는데.. 2000년대 이후부터는 웹 개발에서의 계층을 구분할 때도 저런 용어가 쓰이게 된 것이다.

1990년대.. 웹의 초창기에는 웹만을 위한 프로그래밍이라는 개념이 아주 희박했다. 프런트/백의 엄밀한 구분도 없었고 온갖 비표준 파편화 기술들이 난립했었다.
프런트 엔드에 속하는 건 사용자가 폼에 입력한 값이 올바른지 로컬에서 체크해서 에러 메시지 띄우는 수준의 아주 간단한 코드?? 이런 코드는 html 코드의 주석 안에 자그맣게 짱박혀 있곤 했다.;; html이라는 문서가 main이지, 이런 코드는 약간의 동적 요소만 가미해 줄 뿐, 조연에 지나지 않았다.

하긴, html 자체를 동적으로 생성하는 기술을 공부해서 DB 만지고 게시판 같은 거 자작하는 게 지금으로 치면 백 엔드 개발이었겠다. CGI 역시 백 엔드의 범주에 드는 초창기 기술일 테고. =_=;; 옛날 제로보드 스킨은 일종의 프런트 엔드 개발이었겠다. ㄲㄲㄲ
플래시니 Java 애플릿 같은 건 물론 프런트이고, 지금의 관점에서는 특정 기업 솔루션에 종속적인 비표준 기술이 됐다.

프런트 엔드에서 돌아가는 웹 프로그램 코드는 특정 기계어로 컴파일되지는 않는다. 무슨 C/C++ 프로그램처럼 저수준 메모리 문제나 보안 문제 같은 것도 존재하지 않는다.
만약 특정 JavaScript 코드를 실행함으로써 메모리· 보안 문제가 발생한다면 그건 그 브라우저에 내장된 js 엔진의 버그이지, js 코드의 버그라고 여겨지지는 않는다. 문제 있는 js 코드는 다른 부작용 없이 깔끔하게 실행이 거부되고 에러 메시지와 함께 튕기기만 돼야 할 테니 말이다.

그 대신 그 코드는 보통 난독화 처리가 돼 있을 것이다. 그렇기 때문에 코드가 노출돼 있다고 해서 사용자가 그 코드를 읽어서 뭔가 로직을 파악하기는 매우 난감할 것이다.;;

그렇기 때문에 웹 프로그래밍에서 보안의 최대 관심사는 buffer overrun 같은 부류가 아니라.. 신뢰할 수 없는 임의의 외부 문자열이 코드나 태그, SQL 따위로 인식되어 실행되지 않게 하기 위주인 것 같다. C로 치면 % format 문자열에다가 동적 생성된 외부 문자열을 공급하지 말라는 것과 비슷하다.

문득 드는 생각은.. 웹 개발을 위한 전용 IDE가 있을까?
옛날에 나모나 드림위버, FrontPage 같은 위지윅 html 에디터가 있었고.. Visual Studio 6 시절엔 Visual InterDev라고 비베 냄새가 나는 웹 개발 IDE가 있긴 했다. 하지만 그런 건 2000년대 중반 이후로 유행이 지나고 한물 갔다. 심지어 마소에서 Expression Studio라고 새로 만들던 웹 개발 저작도구도 2010년대 초반에 개발이 중단됐다.

웹은 과연 IDE의 무덤인지.. 개발에 이클립스 내지 Visual Studio Code 같은 범용적인 에디터/IDE만 쓰이는 것 같다.

※ 비유 개드립

  • "웹 디자인 - 웹 프런트 엔드 개발 - 웹 백 엔드 개발"은 뭔가 "장갑차 - 전차 - 자주포" 순으로 성향이 바뀐다고 생각하면 될 것 같다. ㄲㄲㄲㄲㄲㄲ
  • 프런트 엔드에서 css / js / html라는 역할 구분 세분화는 입법 사법 행정 삼권분립과 비슷한 느낌이 든다.
  • PC용 앱은 일반 봉지 라면, 모바일 앱은 컵라면 사발면.. 그리고 웹사이트를 구동하는 프로그램은 식당 납품용으로 대량 판매하는 라면 사리 내지 스프와 비슷하게 느껴진다.
  • 웹 개발이나 컴파일러뿐이겠는가. 인공위성은 프런트 엔드, 발사체는 백 엔드 기술인 것 같고.. 자동차에서도 주행과 관련은 없지만 탑승자가 대면하고 사용하는 부품들은 프런트요, 엔진룸 안에서 차량을 굴리는 데 기여하는 부품은 백에 대응하는 듯.. 이런 식의 구분은 다른 여러 분야에도 존재한다.

※ 모바일 관련

mobile이라는 말이 원래는 물리적인 이동, 교통과 관련된 단어였다. 미술 조형물 모빌이라든가, automobile 자동차처럼 말이다. 하지만 지금은 스마트폰 관련 '통신' 뉘앙스가 더 짙어졌다.
그리고 우리말은 참 희한하게도 '모빌'은 통상적인 의미, '모바일'은 통신 의미로 분화됐다. 마치 '도트/닷', '네트/넷'의 뉘앙스 변화와 비슷한 재미있는 현상이다.
'통신사'가 지금이야 SK 텔레콤 같은 게 먼저 떠오르지만 원래 연합뉴스 같은 언론사 용어였다는 것도 생각해 보자.

Posted by 사무엘

2024/06/11 19:35 2024/06/11 19:35
, ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2307

1. 언어 고안자의 부고

일본에서 지진이 났던 올해 1월 1일 말이다.
파스칼 언어를 고안한 스위스의 컴퓨터 과학자 '니클라우스 비르트' (취리히 연방 공대 교수, 튜링 상 수상자)가 세상을 떠났다. ㄷㄷㄷㄷ
이거 뭐 뒷북 부고 소식을 연달아 전하는구나..;; 이번에는 분야가 신앙 쪽이 아니라 컴공이라는 점만 다르고 말이다.

지난 2011년 가을엔 C 언어를 고안한 '데니스 리치'가 세상을 떠났었다.
C야 워낙 대중적인 언어이고, 또 저 시기는 무려 스티브 잡스의 부고와도 시기가 비슷했다. (딱 1주일 차이) 그래서 데니스 리치의 부고는 이때 작게 잠깐이나마 주목을 받기도 했다.
그러나 지금은? 시기가 별 개연성 없고, 파스칼 언어도 C에 비해 아주 마이너하다 보니, 저 사람의 부고는 아무 존재감 없이 묻혀 지나간 것 같다. =_=;;;

파스칼과 C는 1970년을 전후한 비슷한 시기에, 비슷한 패러다임을 반영하여 만들어진 언어이다. 물론 C가 근소하게 더 나중이긴 하다만.
파스칼은 진짜 순수 학자가 만든 반면, C는 AT&T니 벨이니 유닉스니 하면서 학계보다는 더 실무 엔지니어 지향적인 사람이 만들었다. 물론 이것도 상대적인 차이일 뿐, 데니스 리치도 튜링 상 수상자이고 일반인 입장에서 넘사벽 천재인 건 마찬가지이다.

2. 파스칼 언어 구조에 대한 생각

(1) 파스칼은 블록을 begin end로 표현하는 반면, C는 간단히 중괄호 { }로 때운다. 그리고 C는 세미콜론이 문장을 종결하는 부호인 반면, 파스칼에서는 문장을 '구분'하는 부호이다.

그렇기 때문에 C에서 { 1,2,5 } 이렇게 5 다음엔 ,를 붙이지 않듯,
파스칼에서는 begin a(); b(); c() end. end 직전의 마지막 문장에는 세미콜론을 붙이지 않아도 된다.
아주 흥미로운 차이점이다. 세미콜론 ; 은 .와 ,로 이루어진 부호인데 C는 거기서 .의 특성을 더 중시한 반면, 파스칼은 ,의 특성을 더 중시했다고 볼 수 있다.

글쎄, 파스칼은 개념적으로 알골이라는 초창기 언어에서 영향을 받았고, Ada라는 엄청난 언어와도 유사점이 많다고 하는데.. 특히 이 begin end 말이다. 허나, 이 2000년대 관점에서는 저것들도 다 한물 간 언어가 돼 버리긴 했다.

(2) 파스칼은 program, unit, label, const, type, var 등 파트가 언어 문법 차원에서 나뉘어 있는 게 좀 구시대적이고 고지식하게 느껴지지만.. 한편으로 아주 깔끔하고 명료하게 느껴지기도 한다.
const도 말이다. C/C++에서는 그냥 type modifier의 일종일 뿐인 반면, 파스칼에서는 읽기 전용 상수값들만 선언하는 구간을 나타낸다. 의미는 같지만 용법은 요즘 언어들과는 완전히 다르다는 게 흥미롭다.

C++은 블록 아무 데서나 중구난방으로 타입 선언, 변수 선언, 실행문이 막 섞일 수 있다. 같은 문장이 명칭의 의미가 무엇인지에 따라서 변수(객체) 선언일 수도 있고 함수 선언일 수도 있다. 당장 타이핑 하기에는 간결하지만, 지저분하고 정신 없게 느껴질 수도 있다.

그에 비해 파스칼은 실행문이 있는 곳과 비실행 선언문이 있는 곳이 더 엄격하게 구분돼 있다. 여느 타입이나 변수뿐만 아니라 goto문 라벨조차도 선언을 미리 쭉 한 뒤에야 실제 문장에서 써먹을 수 있다.
이런 구조 덕분에 파스칼은 컴파일러를 만들기가 더 편하다. 언어 문법 차원에서 소스 코드를 두 번이 아니라 처음부터 끝까지 한 번만 쭉 읽으면서도 최적화 계획을 미리 세우면서 컴파일이 가능하다고 한다.

이런 특성이 있고, 또 파스칼은 C/C++ 같은 텍스트 인클루드가 난무하는 언어도 아니다 보니, 비슷한 분량의 코드를 컴파일하는 속도가 C/C++보다 훨씬 더 빠르다. 이런 점에서는 파스칼이 같은 네이티브 코드 생성 언어이면서 생산성이 더 뛰어나다.

(3) 파스칼은 C/C++ 계열 언어처럼 main 함수라는 게 따로 있는 게 아니며, 그냥 코드의 맨 마지막에 등장하는 begin end. 가 제일 먼저 실행된다. 요 begin end가 HTML로 치면 <body> </body> 태그나 마찬가지인 것 같다. 앞의 여러 uses, const, type 등의 선언들은 <head></head> 에 대응하고 말이다.

그리고 파스칼은 이 코드가 단독 실행형 프로그램인지, 아니면 라이브러리(= 파스칼 언어 용어로는 유닛)인지를 소스 코드 차원에서 명시하고 있다.
main 함수가 없는 대신, 맨 첫줄에 program 어쩌구; 아니면 unit 어쩌구; 이런다.
이건 Windows 프로그래밍의 관점에서 보면 모듈 def 파일의 내용을 일부 포함하는 거나 마찬가지이다. 신기하지 않은가?

그 뒤, 마지막 end 다음에 이어지는 마침표는 프로그램 코드의 완전한 끝을 의미한다. end.
이거 다음에 등장하는 텍스트들은 컴파일러가 몽땅 무시하고 짤라 버린다.
그렇기 때문에 주석이라고 감싸지 않아도, 파스칼 문법에 맞지 않은 텍스트가 등장해도 에러 처리되지 않는다!! 컴파일러에 따라서는 end. 이후에 또 whitespace가 아닌 문자가 있다고 경고 정도나 찍어 줄 뿐이다.

(4) 파스칼의 소스 코드는 C/C++처럼 헤더와 몸체의 구분이 없다. 그래도 단독 실행 프로그램이 아닌 유닛의 소스 코드는 내부적으로 선언부와 구현부의 구분이 존재한다. 그렇잖아도 파스칼은 모든 명칭에 대해서 사전 선언을 요구하는 언어이니.. 이런 구분이 존재하는 것이 자연스럽다.

그 구획을 나누는 키워드가 interface와 implementation이라는 길고 어려운 단어이다. 본인은 저 단어를 중학교 시절에 파스칼 언어의 예약어 명목으로 처음으로 접했었다.;;

(5) 표준 입출력 말고.. 텍스트의 입출력과 관련해서 플랫폼 종속적인 비표준 기능을 제공하는 라이브러리가 Turbo C에서는 conio.h였다. 그리고 Turbo Pascal에서는 uses crt.. 즉 CRT라는 이름의 모듈이었다.
그런데 C/C++에서는 CRT라는 게 C runtime library의 약자이며 conio는 console I/O를 뜻한다. 그럼 파스칼에서 저 CRT는 무엇의 이니셜일까?

그건 화면이라는 뜻에서 그냥 브라운관 CRT를 의미하는 듯하다.
그나저나 C건 파스칼이건 함수를 호출하는 건 동일할 텐데.. 역사적으로 함수 호출 컨벤션에 왜 PASCAL이라는 명칭이 붙어 있는지는 개인적으로 의문이다. 잘 모르겠다.;;

아무쪼록.. 파스칼은 이대로 묻히기에는 좀 아까운 독특한 언어이지만, 어쩌다 보니 오늘날 주류에서 밀려난 비운의 언어가 된 듯한 느낌이다.;;

3. 여담: 관련 타 언어들

(1) 안드로이드 진영에서 새로 채택한 언어인 Kotlin, 그리고 애플 진영에서 새로 채택한 언어인 Swift에서 모두 함수의 인자 나열을 C/Java 스타일인 (Type1 val1, Type2 val2)가 아니라..
파스칼 같은 (val1: Type1, val2: Type2)
요 문법을 채택해 있다. 따끈따끈 신흥 언어에서 나름 복고풍 파스칼이 느껴지는 것 같다. ㄷㄷㄷ

그리고 Kotlin은 변수를 선언할 때는 파스칼처럼 var 키워드를 쓰는데, 상수 명칭을 선언할 때는 그냥 '값'이라는 뜻에서 val 키워드를 쓴다.
정작 변수(var)는 L-value라고 여겨지는 반면, 값(var)은 R-value인데도 말이다~! L과 R의 교묘한 언어유희가 아닐 수 없다.

(2) 프로그래밍 언어 분야에는 의외로 미국 말고 유럽.. 그것도 서유럽 영프독이 아닌 다른 마이너(?) 국가 출신들이 기여한 게 많다.

  • 파스칼은 저렇게 뜬금없이 스위스.
  • 파이썬은 네덜란드 (귀도 반 로섬!!)
  • C++은 덴마크 사람인 비야네 스트롭스트룹!!
  • 그리고 볼랜드와 마소에서 펄펄 날았던 PL 전문가 겸 엔지니어인 Anders Hejlsberg도 덴마크!!

애초에 터보 컴파일러 씨리즈로 왕년에 이름을 날렸던 '볼랜드' 사 자체가 덴마크계 사람이 창립한 기업이었다.
한편, Lua는 브라질인지 포루투갈인지 아무튼 그쪽 바닥이다.

Posted by 사무엘

2024/05/17 08:35 2024/05/17 08:35
, ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/2298

« Previous : 1 : 2 : 3 : 4 : 5 : ... 24 : Next »

블로그 이미지

그런즉 이제 애호박, 단호박, 늙은호박 이 셋은 항상 있으나, 그 중에 제일은 늙은호박이니라.

- 사무엘

Archives

Authors

  1. 사무엘

Calendar

«   2026/10   »
일 월 화 수 목 금 토
        1 2 3
4 5 6 7 8 9 10
11 12 13 14 15 16 17
18 19 20 21 22 23 24
25 26 27 28 29 30 31

Site Stats

Total hits:
4199059
Today:
2701
Yesterday:
2133