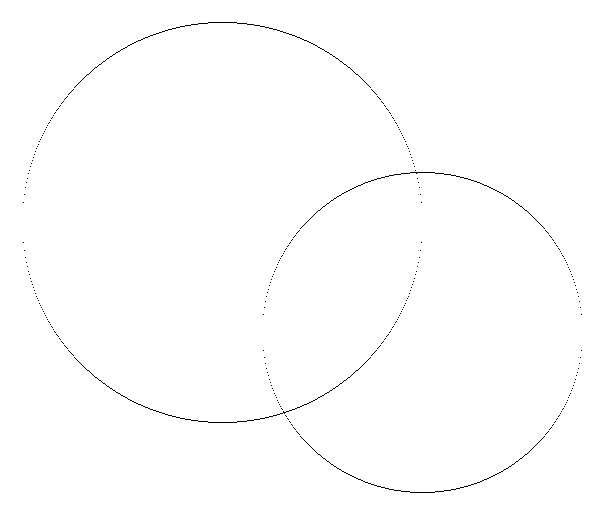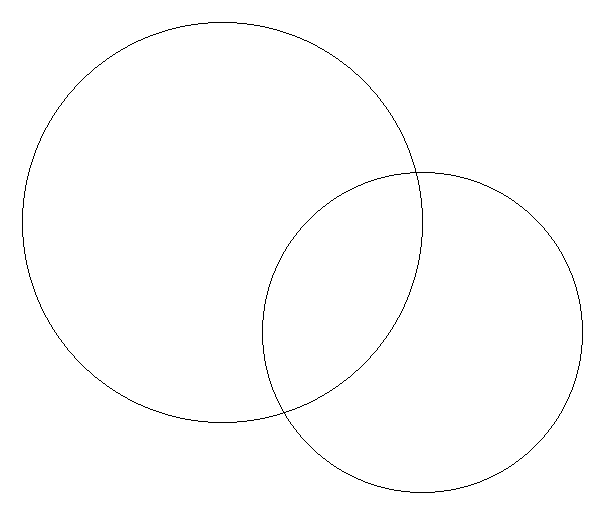« Previous : 1 : ... 17 : 18 : 19 : 20 : 21 : 22 : 23 : 24 : 25 : ... 32 : Next »

지금으로부터 수십 년 전에는 동네마다 컴퓨터 학원이 있었고, 꼬꼬마가 프로그래밍을 공부하겠다고 하면 으레 GWBASIC부터 시작하곤 했다. 베이직은 16비트 MS-DOS뿐만 아니라 각종 가정용 8비트 컴퓨터에도 특유의 인터프리터 환경이 내장되어 있기도 해서 접하기가 한결 쉬웠다.

그때와는 달리 오늘날의 컴퓨터 교육은 이미 만들어진 소프트웨어들을 활용만 하는 실무에만 치우친 편이다.
지금 컴퓨터 프로그래밍을 처음부터 공부하고 싶다면 무엇부터 시작하는 게 좋을까?
이 질문에 대한 답변은 그 사람이 무슨 프로그램을 작성하고 컴퓨터로 무엇을 하고 싶은지 목적에 따라 크게 달라진다.
이 글은 나의 지극히 좁은 편견만을 반영하고 있으므로, 당연히 프로그래머마다 생각이나 견해가 다를 수 있다.

1. 비전문가/비전공자로서 그냥 최소한의 시간 투자로 개인적인 컴퓨터 활용도만 높이고 싶다면(고급 계산기 + 기초 알고리즘 실습 + 파일 자동 조작 + 매크로/자동화 도구 등)

개인적으로 파이썬을 추천한다. 복잡한 자료형을 다루기가 쉬워서 여타 언어들에 비해 짧은 코드만으로 복잡한 일을 한번에 끝낼 수 있다. 방대한 크기의 파일을 읽어서 내가 원하는 처리를 한 뒤 출력을 뱉어내는 수십 줄 남짓한 프로그램만 짤 줄 알아도 인생이 굉장히 편해질 수 있다.
좀 수학 덕후 기질이 있다면, 함수형 프로그래밍 언어를 건드려 봐도 될 듯.

2. 1보다는 좀 더 나아가서 가성비가 뛰어난 개발 환경에서 최소한의 GUI까지라도 만들어 보고 싶으면

Windows 플랫폼 한정으로 C#급 언어가 가장 좋겠다.

3. 웹브라우저에서 어지간한 애니메이션이나 프레젠테이션을 다 띄우고, 글이나 그림을 계산 결과로서 출력하고 싶으면

HTML + 자바스크립트.
요즘은 HTML이 단순히 화면에 뿌려지는 글과 그림, 하이퍼텍스트 문서일 뿐이라고 생각하는 건 큰 오산이다.
문서에다 서식을 주는 건 이제 CSS라는 방대한 별도의 규격으로 독립해 나가고, HTML은 문서 반 코드 반이다. 실시간으로 내용이 업데이트되고 화면 끝까지 스크롤됐을 때 추가로 컨텐츠를 로딩하고.. 사용자의 조작에 반응하여 그림을 뿌려 주는 등, 예전에는 ActiveX나 하다못해 플래시라도 써야 했을 컨텐츠들이 지금은 저것만으로 다 된다.

웹브라우저가 거의 플랫폼 독립적인 프로그램 구동 플랫폼처럼 바뀌었으니, 이를 활용할 줄 알면 역시 컴퓨터 활용 능력이 크게 향상될 수 있다. 웹 프로그램은 다른 언어나 런타임, IDE 같은 걸 설치할 필요조차 없이, 그냥 메모장에서 코딩 후 웹브라우저에서 곧바로 돌려보면 된다.

4. 맥 OS용 응용 프로그램이나 아이폰 앱을 개발하고 싶다면

Objective C + xcode + COCOA API 등등으로 고고씽이다. 일단 맥북을 장만해야 할 것이고 Windows와는 너무 이질적인 개발 환경 때문에 처음에 고생 많이 할 것이다.

5. 안드로이드 스마트폰용 앱을 개발하고 싶다면

자바 + 이클립스 IDE에 익숙해져야 할 것이다. Java는 요즘 스마트폰 앱 개발용 언어로 입지가 확 되살아난 듯하다. 이게 완전한 웹용 언어도 아니고(자바스크립트는 자바와 전혀 다른 언어임), 자바 애플릿이 플래시/ActiveX를 완전히 대체하는 RIA (rich internet application) 프레임워크로 자리잡은 것도 아니고, 로컬에서는 느리고 성능이 안 좋다 보니 전통적인 기계어 프로그램들에 밀려서.. 예전까지는 위상이 좀 어정쩡했기 때문이다. 로컬에서는 일부 크로스플랫폼 소프트웨어의 GUI(프런트 엔드)를 돌릴 때나 좀 쓰이곤 했다.

6. 끝으로, PC + Windows 환경에서 네이티브 코드 + standalone으로 실행되는 프로그램을 개발하고 싶다면

아래아한글이나 <날개셋> 한글 입력기나 어지간한 온라인 게임과 같은 급의 기계어 실행 파일을 만들고 싶다면..
역시나 재래식 Visual C++이나 최소한 델파이 같은 툴로 가야 한다.
개발 환경, 언어 문법과 기본 라이브러리, Windows API, 그 뒤 개발 분야에 따라 추가적인 라이브러리 공부까지 산 넘어 산이다.

오늘날 프로그램 개발 환경이 결국 로컬 + 웹 + 앱이라는 세 양상으로 구분된다고 예전에 글을 쓴 적이 있는데.. 그것과도 관계가 있다.
프로그래밍, 더 나아가 소프트웨어 개발에 관심이 있는 분이라면 이런 아이템들을 참고하면 되겠다.
그런데 정작 이런 글을 쓴 본인은 6만 빼고 나머지 분야는 여전히 너무 모른다는 게 함정..ㅎㅎ

Posted by 사무엘

2013/09/17 08:37 2013/09/17 08:37
,
Response
No Trackback , 13 Comments
RSS :
http://moogi.new21.org/tc/rss/response/878

1. 클립보드 개론

과거에 Windows 3.x 시절에는 '클립보드 표시기'(clipbrd.exe)라는 프로그램이 있었다. 95/98 시절에도 있다가(16비트 바이너리 형태 그대로) 운영체제가 NT 계열로 바뀌면서 완전히 역사 속으로 사라진 듯하다.
그러나 지금도 그런 부류의 액세서리 프로그램이 있으면 좋겠다는 생각을 개인적으로 가끔은 한다. 번거롭게 여타 프로그램을 띄워서 '붙이기' 명령을 내리지 않고도 클립보드에 지금 무엇이 들어있는지를 확인할 수 있기 때문이다.

사실, 제3자가 개발한 클립보드 표시/관리 유틸리티는 당연히 존재한다. 이런 프로그램은 단순히 클립보드 표시 기능뿐만 아니라 클립보드 내용을 파일로 저장하거나 불러올 수도 있고, 지금 MS Office 프로그램들이 그러는 것처럼 여러 개의 클립보드 데이터를 관리하는 기능도 있어서 잘만 활용하면 대단히 편리하다.

기술적으로 봤을 때 클립보드는 여러 프로그램들이 한데 공유할 수 있는 메모리 핸들의 집합이다.
0과 1의 나열일 뿐인 데이터가 텍스트인지 이미지인지 포맷을 식별하는 정수값이 있고, 그 포맷 식별자와 메모리 핸들이 한데 대응하여 튜플을 이룬다.

클립보드에는 여러 종류의 데이터가 동시에 공존할 수 있다. 그래서 워드 프로세서라면 자신만의 고유한 포맷을 등록해서 자신이 만든 모든 정보가 완전히 보존되어 있는 데이터를 놔 둬야겠지만(예를 들어, 이 데이터가 일반 블록이 아니라 칼럼 블록이라는 표시도..), 같은 데이터에 대해서 메모장 같은 프로그램에서도 최소한 텍스트라도 붙여 넣을 수 있게 표준 텍스트 포맷으로도 데이터를 보관해 줘야 한다.

클립보드로부터 데이터를 가져오거나, 거기에다 내 데이터를 저장하려면 먼저 OpenClipbaord 함수를 호출해서 클립보드를 열면 된다. 이 함수가 왜 윈도우 핸들(HWND)을 인자로 받는지는 잘 모르겠다. 클립보드의 사용이 끝난 뒤엔 CloseClipboard를 하면 된다.

클립보드 API는 한 순간에 시스템 전체를 통틀어 단 한 프로그램/스레드만 클립보드에 접근하는 걸 가정하고 만들어졌다. 그래서 딱히 OpenClipboard 함수가 무슨 다른 핸들 같은 걸 되돌리지는 않는다.

2. 클립보드를 위한 메모리 할당 함수

클립보드에다 데이터를 지정하거나 가져오는 건 Set/GetClipboardData 함수로 하면 된다. 이때 주고받는 핸들은 GlobalAlloc 함수를 이용하여 특수하게 할당된 메모리이다.
클립보드 API는 구시대 16비트 Windows 시절의 디자인을 그대로 답습하고 있는 게 많다. 클립보드는 지금 같은 memory mapped file이나 가상 메모리 같은 게 없던 시절부터 존재했다. 그때는 운영체제에 global heap과 local heap이라는 두 종류의 메모리가 존재했고, 클립보드는 응당 global heap의 영역에 존재했다.

운영체제의 heap 함수는 고정된 메모리 주소에다 공간을 바로 할당시킬 수도 있고, 할당은 하되 당장 그 메모리를 사용하지 않을 경우 실제 위치를 운영체제가 재량껏 재배치도 하다가 응용 프로그램이 실제로 잠깐 사용을 할 때만 메모리를 고정시키는 '유동적인' 방식으로 할당할 수도 있다.

메모리를 사용하는 프로그래머의 입장에서는 무척 번거로운 일이지만, 당장 사용하지 않는 메모리를 운영체제가 필요에 따라 재배치 가능하게 할당해 놓으면, 아무래도 PC의 절대적인 메모리 공간이 충분치 않을 때 메모리의 단편화를 예방할 수 있어서 효율적이다. API 자체가 그렇게 헝그리 정신과 상호 협력 이념을 염두에 두고 설계돼 있다는 뜻이다.

GlobalAlloc 함수에는 메모리를 할당할 때 클립보드/OLE 공유가 가능하게 하는 GMEM_DDESHARE 같은 여러 플래그를 줄 수 있다. 이게 어찌 보면 16비트 시절의 VirtualAlloc 함수 같기도 하다. 하지만 32비트로 오면서 GlobalAlloc 함수의 잡다한 플래그들은 다 legacy 잉여로 전락했고, 메모리를 유동적으로 할당할지/고정적으로 할당할지, 그리고 할당된 메모리를 0으로 초기화도 할지를 설정하는 플래그만이 현재 유효하다.

이 함수는 이제 클립보드 복사나 OLE drag & drop 기능을 구현할 때밖에 쓸 일이 없다. 아니면 아주 특수한 상황에서 프로세스의 기본 heap에 의존하지 않고 메모리를 할당할 일이 있을 때나 쓰든가.
32비트 이후부터는 global heap과 local heap의 구분도 없고, 또 이 함수로 개당 몇십 바이트짜리 연결 리스트의 노드를 일일이 저장한다거나 하는 건 바보짓이다.

3. 클립보드 표시기 만들기

일반적으로는 클립보드에 접근해서 데이터를 읽고 쓰고, 클립보드를 비우는 것만 알면 된다.
그것보다 조금 더 고급으로 나가면 나만의 클립보드 포맷을 등록하고 다양한 클립보드 포맷을 조회하는 조작까지 필요해진다.
그 다음으로 클립보드와 관련된 가장 복잡한 조작은 바로, 클립보드 내용이 바뀌었을 때 통지를 실시간으로 받겠다고 운영체제에다 요청하고 실제로 그런 일이 일어났을 때 각종 뒷처리를 하는 일이다.

이렇게 클립보드의 변경 내역을 통지받는 프로그램을 개념적으로 '클립보드 표시기(viewer)'라고 부른다. 모든 프로그램들이 사용자가 누르는 Ctrl+C/X에 관심이 있는 게 아니니, 클립보드 변경 내역은 특별히 요청을 한 프로그램에게만 알려 주는 것이다. 통지가 오는 형태는 메시지이기 때문에, 클립보드 표시기는 응당 윈도우를 생성하고 메시지 loop을 돌고 있어야 한다.

자신(윈도우)을 클립보드 표시기로 등록하려면, WM_CREATE나 WM_INITDIALOG 같은 초기화 메시지에서 SetClipboardViewer 함수를 호출하여 자신의 핸들값을 전달하면 된다.
그러면 그 뒤부터는 어떤 프로그램에서든 클립보드의 내용을 건드린 뒤 CloseClipboard 함수를 호출해 주면, 내 창으로 WM_DRAWCLIPBOARD 메시지가 날아온다. 그럼 내 프로그램은 그때 클립보드 내용을 들여다보면서 적절한 출력을 해 주면 된다.

그런데 문제는 이게 전부가 아니라는 것이다.
클립보드 표시기 API는 엄청난 구시대 스타일로 굉장히 구리게 설계되어 있다. Windows API를 통틀어서 이 정도로 지저분한 물건은 흔치 않을 것 같다.

클립보드 변경 통지 요청을 한 윈도우는 우리 프로그램뿐만이 아니라 여러 개가 동시에 있을 수 있다. 그러니 운영체제는 그 윈도우들의 목록을 내부적으로 관리해야겠지만, 각각의 윈도우의 입장에서야 나 말고 다른 윈도우가 무엇이 있든 말든, 나만 통지를 곱게 받고 끝이어야 정상일 것이다.
그런데 클립보드 표시기 관련 API들은 그렇지 않다. 클립보드 표시기로 등록된 창들은 일종의 단방향 연결 리스트의 형태로 관리되는데, 운영체제는 그 리스트의 head 노드만을 갖고 있다. 그 뒤 나의 다음으로는 무슨 창이 있는지 관리를 해당 응용 프로그램이 직접 해야만 한다.. -_-;;;

SetClipboardViewer 함수는 인자로 받은 윈도우를 연결 리스트의 맨 앞 head 노드로 등록한 뒤, 예전에 head였던 윈도우 핸들을 되돌린다. 우리는 그 값을 반드시 따로 보관해 둬야 한다.

hwndNextCBViewer = SetClipboardViewer(hMyWindow);

그리고 내가 WM_DRAWCLIPBOARD 메시지를 받았다면, 우리는 자체 처리를 마친 뒤에 그 메시지를 저 창에다가 수동으로 전해 줘야 한다.

if(hwndNextCBViewer) SendMessage(hwndNextCBViewer, uMsg, wParam, lParam);
(uMsg는 어차피 WM_DRAWCLIPBOARD이고, wParam과 lParam은 쓰이지 않기 때문에 값이 모두 0임)

메시지를 DefWindowProc로 넘긴다 해도 이 일을 운영체제가 알아서 해 주지 않는다. 우리가 저렇게 메시지를 안 보내 주면 다음 클립보드 표시기들은 클립보드의 변경 내역을 전달받지 못하게 되어 동작이 죄다 꼬이고 만다!

내가 제어를 운영체제로 신속하게 돌려 주지 않으면 운영체제 전체를 다운시킬 수 있던 협력형 멀티태스킹의 암울한 냄새가 물씬 풍긴다.
훅 프로시저는 CallNextHookEx를 반드시 호출해 줘야 하는 것과 같은 스타일이기도 하고 말이다.

내 윈도우가 없어질 때(WM_DESTROY) 클립보드 표시기 지정 해제도 당연히 수동으로 해야 하는데, 이때 사용하는 함수는 ChangeClipboardChain이다. 얘에다가 내 윈도우뿐만 아니라 처음에 SetClipboardViewer의 리턴값으로 받았던 나의 다음 노드 윈도우도 같이 전해 줘야 한다. 마치 옛날에 C++에서 소멸자 함수가 존재하는 객체들의 동적 배열을 delete []연산자로 해제할 때, 배열 원소의 개수를 수동으로 전해 줘야 했던 것만큼이나 번거롭다.

ChangeClipboardChain(hMyWindow, hwndNextCBViewer);

그러면 운영체제는 자신이 내부적으로 갖고 있는 연결 리스트의 head 노드에 속하는 윈도우에다 WM_CHANGECBCHAIN 메시지를 보낸다. wParam에는 해제되는 윈도우, lParam에는 그 해제되는 윈도우의 다음 노드 윈도우가 들어있다.

클립보드 표시기 윈도우는 이 메시지도 살펴봐서 만약 내가 갖고 있는 '다음 노드' 값이 등록 해제되는 윈도우(wParam - hwRemove)라면, 나의 '다음 노드' 값을 등록 해제되는 윈도우의 다음 윈도우(lParam - hwNext)로 업데이트하면 된다. 물론, 나 자신이 등록 해제되고 있다면 저런 메시지 따위는 오지 않고 말이다. 아래의 소스 코드를 참고하라.

void On_WM_CHANGECBCHAIN(HWND hwRemove, HWND hwNext)
{
    if(hwndNextCBViewer==hwRemove) hwndNextCBViewer=hwNext;
    else if(hwndNextCBViewer) SendMessage(hwndNextCBViewer, uMsg, wParam, lParam);
}

hwRemove가 나의 다음 윈도우에 해당한다면 다음 윈도우를 그 다음 것으로 업데이트하고 처리를 종결한다.
그렇지 않으면 아까 WM_DRAWCLIPBOARD를 포워딩했던 것처럼 동일 메시지를 다음 윈도우로 전달해 준다.

연결 리스트에서 어떤 노드를 삭제하기 위해서는 그 노드의 이전 노드가 가리키는 다음 노드를 고쳐 줘야 한다. 그러나 클립보드 표시기 chain은 이전 노드 정보가 존재하는 이중 연결 리스트가 아니라, 오로지 '다음' 노드 정보만이 존재하는 단일 연결 리스트이다.
그렇기 때문에 임의의 노드를 삭제하려면 이전 노드를 파악하기 위해 리스트를 처음부터 다 조회해야 하고, 결과적으로 시간 복잡도 O(n)에 해당하는 절차가 필요해진 것이다. 그것도 운영체제가 알아서 처리해 주는 게 아니라 응용 프로그램들이 다 협조해 줘야 하는 번거로운 형태이고 말이다.

요컨대 클립보드의 내용을 실시간으로 업데이트하여 표시하는 프로그램이라면 최소한 나의 다음 윈도우 정보는 보관해야 하며, WM_DRAWCLIPBOARD와 WM_CHANGECBCHAIN 메시지를 정석대로 처리해 줘야 한다. 내가 프로그램을 잘못 짜면 다른 프로그램의 동작까지 망칠 수가 있으니 이건 운영체제의 보안 관점에서도 굉장히 안 좋은 디자인이다..

운영체제가 달랑 갖고 있는 클립보드 표시기 chain의 head 노드 윈도우를 되돌리는 GetClipboardViewer라는 함수도 있다. 얘는 가장 마지막으로 SetClipboardViewer함수를 호출한 윈도우의 핸들을 되돌리는 셈인데, 이 윈도우로부터 다음 윈도우를 알 수 있는 것도 아니고(다음 윈도우 핸들은 각 창마다 고유한 방식으로 저장하고 있을 테니), 이 함수는 사실상 아무짝에도 쓸모가 없다.

나 같으면, 표시기 윈도우 리스트의 관리를 운영체제가 전적으로 알아서 해 주고 WM_CHANGECBCHAIN 처리를 할 필요가 없는 새로운 SetClipboardViewerEx 함수라도 만들 것 같다. 새로운 응용 프로그램은 더 깔끔한 새로운 API를 쓰라고 말이다. 서브클래싱만 해도 더 깔끔하게 하라고 Windows XP부터는 종전의 SetWindowLongPtr을 대체할 SetWindowSubclass 같은 함수가 새로 추가되지 않았던가.

(* 2017. 7. 14 추가)
그렇게 생각했는데, 최신 MSDN을 우연히 뒤져 보니 역시나 AddClipboardFormatListener라고 내가 생각하는 것과 개념상 정확히 동일한 함수가 Windows Vista에서부터 추가됐구나. 저건 클립보드 내용이 변경될 때마다 내 윈도우로 통지 메시지가 오게 하는 함수로, 예전 같은 번거로운 chain 관리가 필요하지 않다. 등록이 아닌 제거는 Add 대신 Remove로 시작한다. 게다가 실제로 변경된 포맷이 무엇인지도 GetUpdatedClipboardFormats라는 함수로 알아올 수 있다.

이 새로운 listener에 등록되고 나면 클립보드가 변경되었을 때 WM_CLIPBOARDUPDATE라는 메시지가 날아온다. 안 그래도 1024개밖에 안 되는 시스템 메시지 영역은 부족해서 난리일 텐데.. WPARAM, LPARAM 아무 용도가 없는 새로운 메시지를 굳이 추가할 필요가 있나 싶은 생각이 든다. 기존의 WM_DRAWCLIPBOARD도 인자가 전혀 쓰이지 않으며, 메시지를 받는 클라이언트의 입장에서는 용도가 정확하게 동일할 텐데 말이다. 뭐 확실한 구분을 위해서 메시지도 따로 만든 것이지 싶다.
아울러, GetClipboardSequenceNumber라는 함수도 있다. 얘는 클립보드 내용이 변경될 때마다 1씩 증가하는 시퀀스 번호를 되돌리며, Vista가 아니라 2000 시절부터 존재해 온 물건이다.

이걸로도 모자라서 나만의 클립보드 포맷을 등록하여 그 내용을 화면에다 어떻게 표시할지까지 시시콜콜하게 다 지정하는 규격도 Windows API에 있긴 하다. 거기까지 가면 실생활에서 쓰이는 일은 정말 거의 없다시피한 잉여이다.

Posted by 사무엘
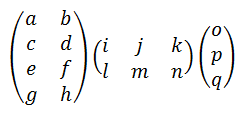
2013/09/12 08:29 2013/09/12 08:29
,
Response
No Trackback , 3 Comments
RSS :
http://moogi.new21.org/tc/rss/response/876

수학에서 행렬은 굉장히 흥미로운 물건이다.
행렬끼리의 덧셈이나 행렬의 상수배는 어려울 게 없는 쉬운 연산이지만, 행렬끼리의 곱셈은 그렇지 않다. 행렬 A와 B사이의 곱셈은 A의 가로 크기와 B의 세로 크기가 같아야 정의되며, 새로 생기는 행렬의 크기(dimension)는 반대로 B의 가로 크기와 A의 세로 크기로 결정된다.

이런 특성상 행렬의 크기는 세로, 즉 row부터 먼저 써 주는 게 직관적이다. 세로 x줄 가로 y줄짜리 x,y 행렬과 y,z 행렬의 곱은 x,z 크기가 된다고 표기가 가능하기 때문이다.

또한, 앞에 있는 행렬과 뒤에 있는 행렬이 원소가 서로 연산되는 방향이 다르기 때문에 행렬의 곱셈은 교환 법칙이 성립하지 않는다. A×B가 일반적으로 B×A와 같지 않다는 뜻. 그러나 결합 법칙은 성립한다. (A×B)×C와 A×(B×C)는 동일하므로, 같은 방향만 유지하면 아무 순서로나 행렬을 곱해 줘도 된다.

그래서 이것과 관련하여 흥미로운 문제가 하나 있다.
크기가 들쭉날쭉 다르지만 순서대로 곱셈은 가능한(= 인접한 행렬끼리는 앞 행렬의 가로 크기와 뒤 행렬의 세로 크기가 일치) N개의 행렬들이 있다. 우리는 이들을 모두 최소의 계산량만으로 곱하고 싶다.

역행렬이나 행렬식 값을 구하는 비용에 비할 바는 아니겠지만 행렬의 곱셈은 꽤 비싼 연산이다. 일반적으로 x,y 크기와 y,z 크기의 행렬을 곱하는 데는 원소들간에 x*y*z회의 곱셈이 필요하다. n 크기의 정사각행렬의 경우 이는 n^3으로 귀착된다. (뭐, 분할 정복법을 활용하여 n^2.x승으로 줄이는 복잡한 알고리즘이 있긴 하지만 이것은 초기 준비 오버헤드가 굉장히 크기 때문에 행렬이 무진장 클 때에나 의미가 있다.)

예를 들어 A는 4*2 크기, B는 2*3 크기, C는 3*1크기의 행렬/벡터라고 치자.
이것을 A*B*C 순으로 진짜 순서대로만 곱하면 A*B를 곱하는 데 4*2*3=24회의 곱셈이 동원되고, 그 결과물인 4*3 행렬을 C와 곱하느라 12회의 곱셈이 필요해서 계산량은 총 36이 된다.

사용자 삽입 이미지

그러나 B*C부터 먼저 곱한 뒤 A를 거기에다 곱하면 열수가 적은 C 덕분에 B*C는 겨우 6회 만으로 끝나고, 거기에다 4*2*1=8회의 곱셈이 추가되어 총 14의 계산량만으로 A*B*C를 구할 수 있다. 답은 결국 똑같은데도 (AB)C보다 A(BC)가 훨씬 더 나은 전략인 것이다.

신기하지 않은가? 그래서 이런 configuration을 일반화하여 {4, 2, 3, 1}이라고 표현하고, 더 나아가 n>=3인 n개의 자연수라고 치자.
이 입력에 대해서 최소 곱셈 횟수와 실제 곱셈 순서를 구하는 것이 문제이다.

정올 공부를 한 분이라면 아시겠지만, 이것은 다이나믹 프로그래밍, 혹은 동적 계획법이라는 알고리즘 설계 방법론을 학습하면서 예시로 다뤄지는 아주 기본 문제이다. 다이나믹 프로그래밍은 다음과 같은 경우에 유용하다.

  • 전체 구간에 대한 최적해가 부분 구간의 최적해에다가 추가 연산을 함으로써 구하는 게 가능하다.
  • 그리고 한번 답을 구해 놓은 부분 구간의 최적해는 더 바뀌지 않는다는 게 보장된다.

이 행렬의 곱셈 문제에서 가장 작은 구간은 3이며, 이때의 답은 그냥 두 말할 나위 없이 세 정수의 곱이다.
그리고 전체 구간 [1..n]에 대해서 최적해는 바로..

  • 1을 [2..n]과 곱했을 때의 계산량 (맨 앞의 행렬과 나머지)
  • [1..n-1] 과 n을 곱했을 때의 계산량 (앞의 행렬들과 맨 뒤의 행렬)

중 더 작은 놈이라고 간주하면 된다.

그럼 [2..n]과 [1..n-1]은? 각 구간에 대해서 또 동일한 해법을 적용하여 재귀적으로 구간을 계속 쪼개 나가는 것이다. 언제까지? 구간의 길이가 3이 될 때까지 말이다.
이렇듯, 다이나믹 프로그래밍은 재귀성을 띠고 있다. 이것은 수학적으로는 점화식으로 표현되며, 코드로는...

const int dat[]={4,2,3,1,2,6,5,8,3,2}; //배열

int GetMin(int f, int t)
{
    int i=t-f, j;
    if(i<3) return 0; //should not reach here
    else if(i==3) return dat[f]*dat[f+1]*dat[f+2]; //obvious case
    else {
        //사실은 i가 3인 경우도 이 조건의 특수한 케이스라고 간주할 수 있다.
        //단지 GetMin값이 0이고, t-2와 f+1이 동일한 값이 될 뿐이다.
        i=GetMin(f,t-1) + dat[f]*dat[t-2]*dat[t-1]; //(A*B)*C
        j=GetMin(f+1,t) + dat[f]*dat[f+1]*dat[t-1]; //A*(B*C)
        return i<j ? i:j;
    }
}

int answer = GetMin(0, 10);

과연 이렇게 하면 답이 구해질까?
프로그램을 돌려 보면, 10개의 정수로 표현된 9개의 서로 다른 크기의 행렬들의 곱은..
146회의 곱셈만으로 계산이 가능하다고 나온다.

구체적인 계산 순서는 이러하다.

4 (2 (3 (((((1 2 6) 5) 8) 3) 2)))

이 경우, 각 단계별 계산 순서는 다음과 같이 되기 때문에,

x y z x*y*z
1 2 6 12
1 6 5 30
1 5 8 40
1 8 3 24
1 3 2 6
3 1 2 6
2 3 2 12
4 2 2 16

곱을 전부 합하면 진짜로 146이 맞다!
참고로, 이런 전략을 쓰지 않고 진짜 FM대로 앞에서부터 뒤로 행렬을 순서대로만 곱하면 계산량은 최적해의 세 배를 넘는 492에 달한다.
이것이 바로 알고리즘이 만들어 내는 차이이다.

다이나믹 프로그래밍에는 반드시 수반되어야 하는 작업이 있다. 바로 예전에 구했던 구간 계산값들을 배열에다 저장해 두는 것이다. 그렇게 하지 않으면, 마치 피보나치 수열을 f(x) = f(x-1)+f(x-2)라고만 구현하는 것만큼이나 계산량이 n이 커짐에 따라 기하급수적으로 커지게 된다. 그것도 예전에 한번 했던 똑같은 계산을 매번 반복하느라 말이다.
그래서 이 방법을 사용한 알고리즘은 대체로 시간 복잡도와 공간 복잡도가 모두 O(n^2)이 된다. 시간 복잡도가 지수함수에서 그래도 다항함수로 바뀐다.

구간별로 최적해 자체뿐만이 아니라 구간 분할을 어떻게 했는지에 대한 정보도 따로 보관해 놓으면 아까와 같은 구체적인 계산 순서도 그 정보를 추적함으로써 구할 수 있다.

정올에서 다이나믹 프로그래밍의 중요성은.. 두 말하면 잔소리이다.
본인은 20세기에 정올 공부를 한 세대인지라 그 시절의 문제밖에 기억을 못 한다만..

1997년 한국 정보 올림피아드의 고등부 3번인 벽장 문제는 최적해를 구하고자 할 경우 공간과 시간 복잡도가 O(n^3)인 다이나믹 프로그래밍으로 풀 수 있다. 이 때문에, 16비트 환경임을 감안하더라도 이 문제는 입력의 범위가 작다. 벽장의 개수와 벽장 사용 순서가 최대 겨우 20까지밖에 안 올라가는 소규모이다. 실용적인 상황에서는 이런 부류의 시뮬레이션 문제는 휴리스틱이 동원되어야 할 것이다.

이 외에,

1999년 고등부 1번 검은 점 흰 점 연결,
2000년 고등부 1번 수열 축소

도 다이나믹으로 푸는 문제이다.
국제 정보 올림피아드의 기출 문제 중에는
10회(1998)의 둘째 날 마지막 문제인 폴리곤 게임,
11회(1999)의 첫째 날 첫 문제인 꽃 진열이 기억에 남는다. 특히 꽃 진열은 상당히 기초적인 다이나믹 프로그래밍 문제로, <날개셋> 타자연습의 문장 정확도 측정도 이와 거의 같은 발상의 알고리즘을 사용하고 있다.

난 이 바닥은 손 놓은 지가 너무 오래 돼서 기억이 가물가물하다.
정보 올림피아드에서 경시와 공모는 마치 과학과 공학, 어학과 문학의 차이와 비슷한 것 같다.

Posted by 사무엘

2013/08/14 08:34 2013/08/14 08:34
, ,
Response
No Trackback , 8 Comments
RSS :
http://moogi.new21.org/tc/rss/response/866

한자어로 '원'이라고 부르는 동그라미라는 도형은 시각적으로나 수학적으로나 아주 신기한 도형이다.
둥글다는 게 무슨 의미인지 기계가 계산으로 표현할 수 있을 정도로 엄밀하게 정의하자면 결국 '어떤 점에서 거리가 같은 점들의 집합'이라는 정의가 등장하게 되고, n차원 직교 좌표에서 거리라는 건 결국 차원을 구성하는 각 축의 거리들의 제곱의 합의 제곱근이라고 정의된다.

원의 지름과 원의 둘레의 비율은 그 이름도 유명한 '파이'이며, 3.141592... 로 시작하는 이 값은 무리수인 동시에 초월수라는 것도 상식이다.

그런데 이 원을 정사각형 격자 모양의 래스터 그래픽 장치에서 어떻게 하면 효율적으로 그릴 수 있을까? 그런 물건의 내부엔 컴퍼스 같은 직관적인 도구가 없는데 말이다.
중심이 x, y이고 반지름이 r인 원을 구성하는 좌표들을 어떤 계산을 통해 얻어 올 수 있을까?
원점이 중심인 원의 방정식은 x^2+y^2=r^2. 따라서 y=sqrt(r^2-x^2) 방정식을 이용하면 사분원 내지 반원을 구성하는 점을 구할 수 있다. 그리고 이 값을 바탕으로 나머지 방향의 점을 그리면 될 것이다.

#include <math.h>
template<typename T>
void Draw_Circle(int x, int y, int r, T f)
{
    double R_2 = r*r;
    for(int i=0;i<r;i++) {
        int v = (int)(sqrt( R_2 - i*i )+0.5);
        f(x-i, y-v); f(x-i, y+v);
        f(x+i, y-v); f(x+i, y+v);
    }
}

for문 자체는 0부터 r까지 사분원의 x좌표만 돌고, 이를 바탕으로 점을 찍는 함수 f를 4개 방향으로 모두 호출한다.
r의 제곱 값은 한 번만 계산하면 되므로 for문 밖에서 별도로 선언해 주는 센스도.
소숫점은 버림이 아니라 반올림이 되도록 0.5를 더한 뒤에 int로 캐스팅하는 게 좋다. 그래야 당장 그려지는 원도 90*n도 부근이 더 탱탱하고 보기 좋아진다.

함수의 사용은 MFC 기준으로 이런 식으로 하면 된다. 함수 안에서 또 다른 함수를 내부적으로 호출할 때 함수 포인터보다 람다가 참 깔끔하긴 하다. (너무 남발한 게 꼬이면 code bloat은 피할 수 없겠지만)

CPaintDC dc(this);
auto x = [&](int x,int y) { dc.SetPixel(x,y,0); };
Draw_Circle(220,220, 200,  x);
Draw_Circle(420,330, 160,  x);

사용자 삽입 이미지

그런데 아뿔싸, 역시 기울기가 1보다 더 커지는 곳에는 점이 듬성듬성 떨어져 있게 된다.
이 틈을 점 찍기가 아니라 선 그리기 같은 다른 함수로 메운다는 건 있을 수 없는 일이고..
결국, 우리의 원 그리기 알고리즘은 언제나 기울기가 1보다 작은 구간에서만 동작하게 loop 구조를 바꿀 필요가 있다.
우리는 원을 4등분했는데, 그렇게 4등분된 조각도 한쪽 끝과 맞은편 끝이 완벽하게 대칭으로 이들을 동시에 그려 보자.

가령, 1사분면에서는 x좌표를 1씩 증가시키면서 r로 근접하고(위의 코드에서 i) y좌표는 r이다가 점점 0으로 작아지는데(위의 코드에서 v),
이와 동시에 반대편에서는 y좌표를 1씩 증가시키면서 r로 근접하고, x좌표는 r에서 0으로 근접시키도록 점을 같이 그리는 것이다.
이제 loop는 변수 i의 값이 r에 도달한 지점에서 끝나는 게 아니라 v와 값이 같아지는 지점에서 끝나면 된다. (정확히는 sqrt(2)*r/2 지점이 됨)

{
    double R_2 = r*r;
    for(int i=0; ;i++) {
        int v = (int)(sqrt( R_2 - i*i )+0.5);
        f(x-i, y-v); f(x-v, y-i);
        f(x-i, y+v); f(x-v, y+i);

        f(x+i, y-v); f(x+v, y-i);
        f(x+i, y+v); f(x+v, y+i);
        if(i>v) break;
    }
}

사용자 삽입 이미지
와, 이로써 굉장히 찰진 모양의 원이 그려졌다. 한 번 루프를 돌 때마다 점이 8개가 그려지는 것이다.
그러나 이런 원 하나 그리는데 부동소숫점에, 곱셈에, 심지어 제곱근까지 꽤 부담스러운 연산이 많이 들어갔다.
이걸 좀 줄일 수는 없을까?

...
    int R_2 = r*r;
    int v = r;
    for(int i=0; ;i++) {
        if(i*i + v*v > R_2) --v;
...

loop의 앞부분을 이렇게 고쳐 보자.
x축에 속하는 i의 값이 1증가할 때마다 y축에 속하는 v의 값은 그대로 유지되거나 1 감소하거나 둘 중 한 변화만을 겪을 것이다.
i가 증가함에 따라 원점에서 i, v까지의 거리가 R보다 확 커지게 됐다면, 이 궤적은 원의 범위를 벗어나는 것이므로 y축에 속하는 v를 1 줄여 준다.

실질적으로 행해지는 연산을 이렇게 최적화해 주면 최소한 부동소숫점과 제곱근 연산은 없어진다.
그러나 최적화의 여지는 그래도 여전히 남아 있다. 저 꼴도 보기 싫은 곱셈을 없애려면 어떡하면 좋을까?

방법이 있다.
결국, i*i는 0, 1, 4, 9, 16 ...의 순열을 생성해 낼 텐데, 얘는 덧셈을 두 번 하는 걸로 대체할 수 있다. 한 번 덧셈을 한 뒤엔 증가치가 2씩 늘어나니까 말이다(1과 4의 차는 3, 4와 9의 차는 5, 9와 16의 차는 7). x^2의 도함수가 괜히 2*x가 아니다.

그리고 v는 초기값이 아예 R_2와 같으니 약분이 가능하다. 그 뒤에 v의 값이 줄어들면서 차이만이 발생할 뿐이다. 그런데 얼마를 빼 줘야 할까?
x^2가 (x-1)^2로 바뀌었을 때 감소하는 값은 잘 알다시피 2*x-1이다. 따라서 이 값만 초기에 계산해 놓은 뒤, v가 1 감소하게 됐을 때 가상의 v_square은 그만치 빼 주고, 그 델타값 자체도 2 감소시키면 된다.

...
    int v = r, i_square = 0, i_delta = 1;
    int v_delta=2*r-1, v_square_delta = 0;
    for(int i=0; ;i++) {
        if(i_square + v_square_delta > 0) {
            --v; v_square_delta-=v_delta, v_delta-=2;
        }

... //점 여덟 군데를 찍어 준 뒤

        if(i>v) break;
        else i_square+=i_delta, i_delta+=2;
    }

이로써 그 부드러운 원을 오로지 정수의 덧셈만으로, 그리고 곱셈이라고는 loop 돌기 전에 *2 단 한 번밖에 안 하는 깔끔한 원 그리기 알고리즘이 완성되었다. 놀랍지 않은가? 게다가 고정적인 두 배 연산은 잘 알다시피 bit shift로도 수행 가능한 아주 가벼운 연산이기도 하고 말이다.

GWBASIC, Windows GDI API, 옛날 볼랜드 BGI 등 모든 그래픽 라이브러리에 들어있는 원 그리기 함수는 기본적으로 이 알고리즘을 이용하여 원을 그린다. 각종 알고리즘 서적에 예제로 실려 있는 소스들도 세부적인 변수 활용이나 계수 계산에 차이가 있을지언정 기본적인 아이디어는 동일하다.

사실, 이건 거의 대학교 학부 수준이고 정보 올림피아드 공부라도 했다면 중· 고등학교 시절에라도 접했을 기초적인 내용이다. 진짜 어려운 건 이걸 응용하여 안티앨리어싱을 적용한다거나 타원을 그리거나, 아예 부채꼴 내지 회전된 원을 그리는 알고리즘이다.

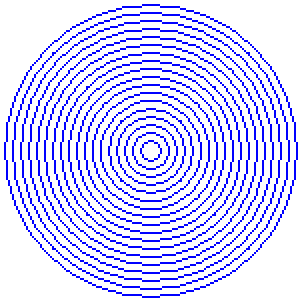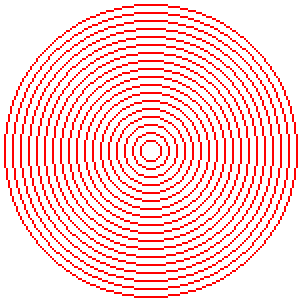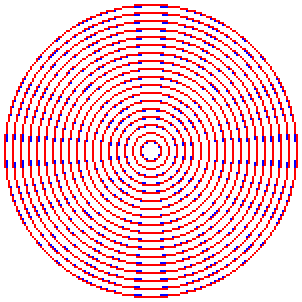
단, Windows GDI가 그리는 원은 왠지 좀 엉성하고 덜 예쁜 것 같다. 비교를 할 때 반올림 보정을 안 하는지 경계가 아주 약간 덜 통통하며, 특히 기울기가 1(45도)에 가까워지는 지점에 점의 배치가 지저분하다.
차이를 보이기 위해 움짤을 만들어 보았다. 파란색 원은 GDI 함수로 그린 것이고, 빨간색 원은 우리가 작성한 함수로 그린 것이다.

사용자 삽입 이미지

Posted by 사무엘

2013/07/28 08:27 2013/07/28 08:27
, , ,
Response
No Trackback , 6 Comments
RSS :
http://moogi.new21.org/tc/rss/response/860

3. 더 기괴하고 잉여력마저 의심되는 오버로딩

(1) 비트 연산자도 아니고 논리 연산자 && || !는 오버로딩할 일이 거의 없으며, 각종 C++ 디자인 패턴 책에서도 오버로딩을 권하지 않는 물건들이다. 그 연산자를 건드릴 게 아니라 개체를 건드리는 게 순리이다. 논리 연산자들이 취급할 수 있는 정수나 boolean 값으로 형변환하는 연산자를 제공하는 게 이치에 맞다.

굳이 논리 연산자를 오버로딩해 버리면, 일단 언어가 원래 제공하는 단축연산 기능이 사라지게 된다. 즉, A && B에서 A가 이미 false이면 B의 값은 아예 계산하지 않고 함수를 호출하지도 않는 것 말이다. 오버로딩된 함수는 논리 연산자라도 언제나 A와 B의 값을 먼저 계산한 뒤에 실행된다.

(2) 어떤 개체가 메모리에 차지하는 주소를 얻어 오는 기능은 그 어떤 타입이나 클래스에 대해서도 절대불변으로 동작해야 하는 기능이지 않은지? 마치 개체의 고정된 크기를 얻어 오는 sizeof 연산자처럼 말이다.
그럼에도 불구하고 C++의 단항 & (address-of) 연산자는 오버로딩 가능하다!

class Foo {
    //...
public
    int operator&() { return 0; }
};

void Bar(Foo *p)
{
    //...
}

이렇게 선언하거나 더 얄밉게 연산자 함수를 아예 private로 감춰 버리고 나면,
지역변수나 클래스/구조체의 멤버로 직접 선언된 Foo 개체는 Bar라는 함수에다 넘겨주는 게 불가능해진다. =_=;;;

Foo a; Bar(&a);

이런 테크닉이 무슨 필요나 의의가 있는지는 난 잘 모르겠다.

전통적인 &는 변수의 주소라는 R-value만 되돌리는 연산자인데, 이를 오버로딩하면 &는 참조자 같은 걸 되돌릴 경우 L-value를 되돌리는 것도 가능해진다. 따라서 그 값에 대해서 또 주소를 얻는 &를 적용하는 게 덩달아 가능해진다.
그러나 이 경우 &&를 연달아 쓸 수는 없으며, & &a 같은 식으로 토큰을 분리해 줘야 한다. 예전에 중첩 템플릿 인자를 닫을 때 > 사이에 공백을 넣어 줬던 것처럼 말이다.

(3) 게다가, 우선순위가 가장 낮으며 그저 여러 연산자들을 한데 나열하는 역할만을 하는 콤마 연산자도 오버로딩 가능하다! (,는 오버로딩 없이도 원래 아무 피연산자에 그 어떤 타입이 와도 무조건 괜찮은 유일한 이항 연산자임)
콤마는 함수 인자 구분용으로도 쓰인다는 특성상, 이 연산자는 가변 인자 함수 호출을 흉내 내는 용도로 쓰일 수 있을 것 같다. list, 3, 2, 1, 8, 4; 이라고 써 주고 list.add(3); list.add(2); ... 같은 효과를 낼 수도 있다는 뜻이다. 하지만 이걸 남발하는 건 좀 사악한 짓인 듯.

(4) 기괴한 오버로딩의 진정한 종결자로 내가 최후까지 남겨 둔 건 바로 ->* (pointer-to-member) 이다. 얘는 유사품인 ->하고는 오버로딩을 하는 방식이 사뭇 다르다!
-> 연산자가 아무 인자가 없는 멤버 함수인 반면, ->*는 단 하나의 인자를 받는다. 그 인자는 아무 타입이나 될 수 있으며, ->* 연산자 함수 자체도 다양한 타입으로 오버로딩될 수 있다. 가령,

POINT& operator->*(int x) { return m_pt[x]; }

이렇게 오버로딩이 된 클래스가 있다면

(obj->*0).x = 100;

이런 식으로 활용이 가능하다. 0이 연산자 함수의 인자로 전달된다. 0뿐만이 아니라 당연히 int 변수 n 같은 것도 줄 수 있다. .이나 -> 연산자 다음에는 구조체/클래스의 멤버가 뒤따라야 하는 반면, .*이나 ->* 연산자 다음에는 임의의 타입에 속하는 value가 올 수 있는 구조인 것이다. ->는 가리키는 대상 포인터이지만 .*는 대상으로부터 얻을 오프셋 자체가 고정이 아니라 동적이며, ->*는 대상과 오프셋이 모두 동적임을 뜻한다.

struct A { int x,y; };

struct B { A m_Obj; };

이렇게 A를 멤버로 갖는 B라는 클래스가 있다고 치자.
클래스의 멤버 포인터는 클래스에 종속적이다.
그러므로 클래스 B에 대해서 A에 소속된 멤버 포인터를 적용하고 싶다면 ->* 연산자를 오버로딩하여 다음과 같은 연산자 함수를 써 주면 된다.

int& operator->*(int A::*t) { return m_Obj.*t; }

그러면

B bar;
int A::*temp = &A::x;

bar->*temp = 100;
bar.m_Obj.*temp = 100;

위의 두 구문은

bar.m_Obj.x = 100;

과 동일한 의미를 지니게 된다. 실무에서 이걸 오버로딩할 일이 있을지는 잘 모르겠지만..;;
멤버 변수가 저렇고, 멤버 함수의 포인터에 대해서는 머리가 터질 것 같아서 생략하련다.
C++의 세계가 더욱 심오하게 느껴지지 않는가?

4. C++ 연산자 오버로딩의 한계

(1) 당연한 말이지만 원래 C++ 언어에 없는 새로운 토큰을 만들어 낼 수는 없다. 가령, @, ** 같은 듣보잡 기호를 연산자로 정의할 수는 없다. 특히 *는 포인터의 연쇄 역참조용으로도 쓰이기 때문에 ** 같은 건 C++에서 절대로 토큰으로 쓰일 수 없는 문자열이다.

(2) .(구조체 멤버 참조) .*(멤버 포인터) ::(scope) ?:(조건 판단. 유일한 삼항 연산자) sizeof 연산자는 의미가 완전히 고정되어 있으며 재정의할 수 없다.

(3) C/C++이 원래 정의하고 있는 연산자의 우선순위와 피연산자 결합 방향을 변경할 수는 없다. 그리고 built-in type에 대해 이미 정의되어 있는 연산의 의미를 재정의할 수도 없다.

이런 모든 구체적인 디테일들을 다 명시해야 한다면 C++의 참고용 매뉴얼은 정말 상상을 초월하게 두꺼울 수밖에 없겠다는 게 실감이 간다.

Posted by 사무엘

2013/07/17 08:36 2013/07/17 08:36
Response
No Trackback , 5 Comments
RSS :
http://moogi.new21.org/tc/rss/response/856

오늘은 C++에서 기초적이면서도 아주 심오하고 기괴한 문법 중 하나인 연산자 오버로딩에 대해서 좀 살펴보도록 하자.
정수, 포인터 같은 기본 자료형뿐만 아니라 사용자가 만든 임의의 개체도 연산자를 통해 조작할 수 있으면 천편일률적인 함수 호출 형태보다 코드가 더 깔끔하고 보기 좋아지는 효과가 있다. 물론, 아무 논리적 개연성 없이 오버로딩을 남발하면 코드를 알아보기 힘들어지겠지만 말이다.

C++은 연산자 오버로딩을 위해 operator라는 키워드를 제공한다. 그리고 개체에 대한 연산자 적용은 연산자 함수를 호출하는 것과 문법상 동치이다(syntactic sugar). 가령, a+b는 a.operator +(b) 또는 ::operator +(a,b)와 동치라는 뜻이다. 연산자 함수는 표준 규격이 없이 C++ 컴파일러마다 제각각으로 제정한 방식으로 심벌 명칭이 인코딩된다.

앞에서 예를 들었듯이 연산자 함수는 클래스에 소속될 수도 있고, 특정 클래스에 소속되지 않은 중립적인 전역 함수로 선언될 수도 있다. 클래스의 멤버 함수인 경우 this가 선행 피연산자에 포함된 것으로 간주되어 함수의 인자 개수가 하나 줄어든다. 연산자 함수는 명백한 특성상 default 인자를 갖는 게 허용되지 않는다.

한 클래스와 관련된 처리는 당연히 가능한 한 클래스의 내부에서 다 알아서 하는 게 좋다. 그러니 전역 함수 형태의 연산자 함수는 이항 연산자에서 우리 타입이 앞이 아니라 뒤에 나올 때 정도에나 필요하다. 가령, obj+1이 아니라 1+obj 같은 형태일 때 말이다. 그리고 이 전역 함수는 당연히 클래스의 내부에 접근이 가능해야 연산을 수행할 수 있을 것이므로 보통 friend 속성이 붙는다.

연산자가 클래스 함수와 전역 함수 형태로 모두 존재할 경우엔 모호성 에러가 나는 게 아니라 전역 함수가 우선적으로 선택되는 듯하다. a+b에 대해서 ::operator +(a,b)와 a.operator +(b)가 모두 존재하면 전자가 선택된다는 뜻. 언어의 설계가 원래 그렇게 된 건지는 잘 모르겠다.

본인은 연산자 오버로딩을 다음과 같은 양상으로 분류해 보았다.

1. 쉽고 직관적인 오버로딩

(1) 사칙연산, 대입, 비교, 형변환 정도가 여기에 속한다. 기본 중의 기본이다.
사칙연산을 재정의함으로써 C++에서도 문자열을 +를 써서 합치는 게 가능해졌다(동적 메모리 관리까지 하면서). 그리고 복소수, 유리수, 벡터 같은 복합적인 수를 표현하는 자료형을 만들 수 있게 되었다.

(2) 내부적으로 포인터 같은 외부 리소스를 참조하고 있기 때문에 단순 memcpy, memcmp 알고리즘으로는 대입이나 비교를 할 수 없는 클래스의 경우, 해당 연산자의 오버로딩이 필수이다. 이 역시 문자열 클래스가 좋은 예이다. 대입 연산자는 복사 생성자와도 비슷한 구석이 있다.
대입 연산자는 생성자와 역할이 비슷하다는 특성상, 연산자들 중 상속이 되지 않는다. 모든 클래스들은 상속에 의존하지 말고 자신만의 대입 연산자를 갖추고 있어야 한다는 뜻이다. 단, 순수 대입인 = 말고 +=, -= 같은 부류들은 상속됨.

(3) 비교 연산은 같은 클래스에 속하는 여러 원소들을 다른 컨테이너 클래스에다 집어넣어서 순서대로 나열해야 할 때 매우 요긴하게 쓰인다. 전통적인 C 스타일의 비교 함수보다 훨씬 더 직관적이다.

(4) 형변환 연산자야 상황에 따라 어떤 개체의 형태를 카멜레온처럼 바꿔 주고 개체의 사용 호환성을 높여 주는 기능이다. 포인터나 핸들 하나로만 달랑 표시되는 자료형에 대해서 자동으로 메모리 관리를 하고 여러 편의 기능을 수행하는 wrapper 클래스를 만든다면, 본디 자료형과 나 자신 사이의 호환성을 이런 형변환 연산자로 표현할 수 있다.
문자열 클래스는 const char/wchar_t * 같은 재래식 문자 포인터로 자신을 자동 변환하는 기능을 제공하며, MFC의 CWnd도 이런 맥락에서 HWND 형변환을 지원하는 것이다.

(5) 한편, 비트 연산자는 산술 연산보다야 쓰이는 빈도가 아무래도 낮다. 비트 벡터나 집합 같은 걸 표현하는 클래스를 만드는 게 아닌 이상 말이다.
단, 뭔가 직렬화 기능을 제공하는 스트림 개체들이 << >>를 오버로딩한 것은 굉장히 적절한 선택인 것 같다. MFC의 CArchive라든가 C++의 iostream 말이다. input, output이라는 방향성을 표현할 수 있고 또 비트 shift라는 개념 자체가 뭔가 '이동, 입출력'이라는 심상과 잘 맞아떨어지기 때문이다.

다른 연산자들보다 적당히 우선순위가 낮은 것도 장점. 하지만 산술 연산 말고 비교나 비트 연산자는 <<, >>보다도 우선순위가 낮으므로 사용할 때 유의할 필요가 있다.

2. 아까 것보다는 좀 더 생소하고 어려운 오버로딩

(1) 필요한 경우, operator new와 operator delete를 오버로딩할 수 있다. 물론, 객체를 생성하고 소멸하는 new/delete 본연의 기능을 완전히 뒤바꿀 수는 없지만, 이 연산자가 하는 일 중에 메모리를 할당하여 포인터를 되돌리는 기능 정도는 바꿔치기가 가능하다는 뜻이다. C/C++ 라이브러리가 기본 제공하는 heap이 아닌 특정 메모리 할당 함수를 써서 특정 메모리 위치에다가 객체를 배체하고 싶을 때 말이다.

특히 new/delete는 여러 개의 인자를 받을 수 있는 유일한 연산자 함수이다. size_t 형태로 정의되는 메모리 크기 말고 다른 인자도 받는 다양한 버전을 만들어서 new(arg) Object; 형태의 문법을 만들 수 있으며, 이때 arg는 Object의 생성자가 아니라 operator new라는 함수에다 전달된다. (delete 연산자는 어떤지 잘 모르겠다만..;;)

그리고 이놈은 전역 함수와 클래스 멤버 함수 모두 가능하다. 클래스 멤버 함수일 때는 굳이 static을 붙이지 않아도 이놈은 static이라고 간주된다. 당연히.. malloc/free 함수의 C++ 버전인데 this 포인터가 전혀 의미가 없는 문맥이기 때문이다..

사실, C++은 단일 개체를 할당하는 new/delete와 개체의 배열을 할당하는 new []/delete []도 구분되어 있다. 후자의 경우, 생성자나 소멸자 함수를 정확한 개수만치 호출해야 하기 때문에 배열 원소의 개수를 몰래 보관해 놓을 공간도 감안하여 메모리가 할당된다.
그러나 이것은 언제까지나 컴파일러가 알아서 계산을 하는 것이기 때문에 배열이냐 아니냐에 따라서 메모리 할당/해제 함수의 동작이 딱히 달라져야 할 것은 없다. 굳이 둘을 구분해야 할 필요가 있나 모르겠다.

(2) ++, --는 정수나 포인터 같은 아주 간단한 자료형과 어울리는 단항 연산자이다. 그런데 개체의 내부 상태를 한 단계 전진시킨다거나 할 때... 가령, 연결 리스트 같은 자료형에서 iterator를 다음 노드로 이동시키는 것을 표현할 때는 요런 물건이 유용하다. 난 파일 탐색 함수를 클래스로 만들면서 FindNextFile 함수 호출을 해당 클래스에 대한 ++ 연산으로 표현한 적이 있다. ㅎㅎ

++, --는 전위형(prefix ++a)과 후위형(postfix a++)이 둘 존재한다. 후위형 연산자 함수는 전위형 연산자 함수에 비해 잉여 인자 int 하나가 추가로 붙는다. 그리고 후위형 연산자는 자신의 상태는 바꾸면서 바뀌기 전의 자기 상태를 담고 있는 임시 객체를 되돌려야 하기 때문에 처리의 오버헤드가 전위형보다 더 크다. 아래의 코드를 참고하라.

A& A::operator++() //++a. a+=1과 동일하다.
{
    increment_myself();
    return *this;
}

A A::operator++(int) //a++.
{
    A temp(*this);
    increment_myself();
    return temp;
}

보다시피, 전위형과 후위형의 실제 동작 방식은 전적으로 관행에 따른 것이다. 전위형이 후위형처럼 동작하고 후위형이 전위형처럼 반대로 동작하게 하는 것도 프로그래머가 마음만 먹으면 엿장수 마음대로 얼마든지 가능하다.
정수의 경우 프로그래머가 for문 같은 데서 a++이라고 쓴다 해도 똑똑한 컴파일러가 굳이 임시 변수 안 만들고 ++a처럼 최적화를 할 수 있다. 그러나 사용자가 오버로딩한 연산자는 실제 용례가 어찌 될지 알 수 없으므로 컴파일러가 선뜻 최적화를 못 할 것이다.

일반적으로 a=a++의 실행 결과는 컴파일러의 구현 내지 최적화 방식에 따라 들쭉날쭉 달라지는 것으로 잘 알려져 있다. (당장 비주얼 C++와 xcode부터가 다르다!) 또한 a가 일반 정수일 때와, 클래스일 때도 동작이 서로 달라진다. 이식성은 완전히 안드로메다로 간다는 뜻 되겠다. 더구나 한 함수 호출의 인자 안에서 a와 a++이 동시에 존재하는 경우, 어떤 값이 들어가는지는 같은 컴파일러 안에서도 debug/release 빌드에 따라 차이가 생길 수 있으므로 이런 모호한 코드는 작성하지 않아야 한다.

(3) 포인터를 역참조하는 연산자인 * ->는 원래는 포인터가 아닌 일반 개체에 대해서 쓰일 수 없다. 그러나 C++은 이런 연산자를 오버로딩함으로써 인위적인 '포인터 역참조' 단계를 만들 수 있으며, 이로써 포인터가 아닌 개체를 마치 포인터처럼 취급할 수 있다. 형변환 연산자와 비슷한 역할을 하는 셈이다.

C++ STL의 iterator가 좋은 예이고, COM 포인터를 템플릿 형태로 감싸는 smart pointer도 .을 찍으면 자신의 고유한 함수를 호출하고, ->를 찍으면 자신이 갖고 있는 인터페이스의 함수를 곧장 호출하는 형태이다.
-> 연산자는 전역 함수가 아니라 인자가 없는 클래스 멤버 함수 형태로 딱 하나만 존재할 수 있다. 다음 토큰으로는 구조체나 클래스의 멤버 변수/함수가 와야 하기 때문에 리턴 타입은 구조체나 클래스의 포인터만이 가능하다.

(4) []도 재정의 가능하고 심지어 함수 호출을 나타내는 ()조차도 연산자의 일종으로서 재정의 가능하다!
[]의 경우 클래스가 포인터형으로의 형변환을 제공한다면 정수 인덱스의 참조는 컴파일러가 자동으로 알아서 그 포인터의 인덱스 참조로 처리한다. 그러나 [] 연산자 함수는 굳이 정수를 받지 않아도 되기 때문에 특히 hash 같은 자료구조를 만들 때 mapObject[ "H2O" ] = "산소"; 같은 구문도 가능해진다. 단, 진짜 고급 언어들처럼 인자를 여러 개 줄 수는 없다. map[2, 5] = 100; 처럼 할 수는 없다는 뜻.

()도 사정이 비슷한지라, 클래스가 함수 포인터로의 형변환을 제공한다면 굳이 () 연산자를 재정의하지 않아도 개체 다음에 곧장 ()를 붙이는 게 가능은 하다. 그러나 그 함수 포인터는 this 포인터가 없는 반면, () 연산자 함수는 this를 갖는 엄연한 멤버 함수이다.
함수 포인터로의 형변환 연산자 함수는 언어 문법 차원에서 토큰 배열의 한계 때문에 대상 타입을 typedef로 먼저 선언해서 한 단어로 만들어 놔야 한다.

Posted by 사무엘

2013/07/15 08:35 2013/07/15 08:35
Response
No Trackback , 5 Comments
RSS :
http://moogi.new21.org/tc/rss/response/854

이제는 딱히 새삼스러울 것도 없지만, Windows용 응용 프로그램들의 현대화 수준을 나타내는 지표로는 다음과 같은 것들이 있다.

1. 유니코드: 완전 기본 필수. 시대가 어느 시댄데 시스템 로케일(로캘?)이 한국어로 지정되어 있지 않은 운영체제에서 한글 UI가 ?로 죄다 깨진다거나 한글로 된 파일을 인식하지 못하는 프로그램은 처지가 참으로 안습하다. 한글 로케일에서도 상용 한자 4888자 이외의 한자를 인식할 수 없는 프로그램이라면 역시 무효임.

2. 64비트: 프로그램이 혼자서만 동작하는 EXE라면 32비트만 있어도 큰 상관이 없겠지만, 여타 프로세스 내부에서 동작하는 DLL(셸 확장, 훅, IME, 드라이버 등등)이라면 64비트 바이너리가 반드시 있어야 한다.

3. 멀티코어: 빡세게 많은 작업을 하는 프로그램이라면 요즈음의 컴퓨터에서 CPU를 최대 겨우 10~20%대밖에 안 쓰는 비효율적인 형태로 동작해서는 안 된다. 여러 코어가 작업을 어떻게 분담할지를 염두에 두고 프로그램이 개발되어야 한다.

4. 사용자 계정 컨트롤: Program Files 디렉터리 밑에다 개념 없이 사용자 데이터를 써 넣지 말며, XP 이하 OS에서는 신경 쓸 필요가 없던 권한 부족 에러가 제대로 처리되어야 한다. 레지스트리나 디렉터리가 redirection되는 일 없이 동작해야 한다.

5. 고해상도: 이제는 고해상도 모니터가 많이 보급되면서 종래의 100dpi가 아닌 120dpi 정도를 쓰는 빈도가 증가하고 있다. 이런 환경에서도 UI 화면은 적당하게 확대되어 나오거나 차라리 시종일관 동일한 픽셀 크기로 나오지, 글자가 깨지거나 GUI 요소가 들쭉날쭉 뒤죽박죽으로 배치되는 일은 없어야 한다.

이런 이슈들 중, 본인은 현재 5번을 주목하고 있다.
사실, 화면의 논리적 해상도를 바꾸는 건 엄청 옛날에 Windows 9x 시절부터도 있었던 기능이다. 하지만 그 당시는 화면 해상도가 겨우 800*600이나 1024*768이 고작이었기 때문에, 안 그래도 화면이 작아 죽겠는데 배율을 더 키우는 기능은 사실상 전혀 필요하지 않았다.

그러니 이건 정말 누가 쓰나 싶은 잉여로 전락했고, 수많은 프로그램들은 운영체제에 그냥 표준 해상도인 96dpi밖에 존재하지 않는 걸로 가정한 채 각종 좌표들을 하드코딩한 채로 개발되었다.

그랬는데 요즘 컴퓨터의 모니터들은 가로 해상도가 1500을 넘어가고 세로 해상도가 1000을 넘어가니, 이제는 화면을 좀 더 큼직하게 써도 되는 시대가 도래했다. 컴퓨터의 성능과 직접적인 관계가 있는 메모리와 CPU뿐만 아니라, 이런 디스플레이 기술의 발전도 컴퓨터의 발전에 큰 기여를 했음이 분명하다.

이제는 아이패드 같은 모바일 태블릿 기기조차 화면 해상도가 2000*1500을 넘어서 있다. 그러나 기술 발전을 아주 점진적으로 경험하여 legacy의 역사가 긴 PC 환경에서는, 고해상도를 고려하지 않고 설계된 프로그램들에게 재앙이 시작되었다. 논리 해상도에 따라 자동으로 크기가 조절되는 요소(시스템 글꼴 크기, 그리고 대화상자 크기)와 그렇지 않은 요소가 뒤섞이면 GUI 외형이 개판이 될 수밖에 없다.

현재 화면의 논리적 해상도는 데스크톱 화면의 DC를 얻어 온 뒤 GetDeviceCaps(hDC, LOGPIXELSX)를 하면 구할 수 있다. X뿐만 아니라 Y도 존재하는데, X축 값과 Y축 값이 서로 달라지는 경우는 (사실상) 없다고 생각하면 된다. 일반 배율인 100%일 때의 리턴값은 96이고, 125%일 때는 120이 돌아온다..

Windows에서 화면 DPI의 변경은 완전히 on-the-fly로 자유롭게 되는 작업은 아닌지라, 운영체제 재시작이나 최소한 로그오프가 필요한 이벤트이다. 그래서 그런지 Windows Vista는 전무후무하게 화면 DPI 변경을 '관리자 권한이 필요한 작업'으로 규정했었으나, 그 규제가 7 이후부터는 풀렸다. 또한, XP 이하의 버전은 100% (96dpi)보다 작은 값으로 변경하는 것도 가능했지만, Vista 이래로 더 작은 값으로는 지정 가능하지 않게 바뀌었다.

본인이 개발하는 <날개셋> 한글 입력기의 경우, 보조 입력 도구들은 옛날에 급조하느라 각종 버튼들의 좌표가 하드코딩되어 있었다. 다음 7.0 버전부터는 고해상도일 때는 전반적인 외형도 그에 비례해서 더 큼직하게 나오게 바뀔 예정이다.

하지만 편집기는 논리적 해상도에 관계없이 글자가 언제나 무조건 16*16 고정된 픽셀 크기로만 출력되며, 이것은 쉽게 개선되기 어려운 약점이다. 글꼴 자체는 16*16 비트맵만 쓰는 게 불가피하더라도, 고해상도에서는 그 상태 그대로 글자를 살짝 확대해서 찍어 주는 기능이 필요할 것 같다. 물론 anti-aliasing을 적용해서 부드럽게 확대해서 말이다.

고해상도 환경은 아이콘을 관리하는 것도 무척 까다롭게 만들었다. Windows 95/NT4 이전에는 아이콘은 오로지 32*32 크기밖에 없었는데 나중에 16*16 작은 크기가 추가되었다. 요즘은 그것도 모자라서 20*20이나 24*24 크기도 쓰이고 있다. 그래서 한 아이콘은 여러 크기의 아이콘 이미지들의 family 내지 컬렉션처럼 되었다고 본인이 예전 글에서 언급한 적이 있다.
예전엔 고해상도 모드에서 그냥 화면 왜곡을 감수하고라도 16*16 아이콘을 살짝 확대해서 보여주는 걸로 때웠지만, 이젠 안 그러고 20*20 크기용 아이콘도 직접 만들어 넣어 주는 셈이다.

사실 FM대로라면 운영체제가 사용하는 표준 아이콘 크기도 매번 GetSystemMetrics(SM_CXICON) 같은 식으로 쿼리를 해서 써야 고해상도 환경에서도 유연하게 대비를 할 수 있을 것이다. 하지만 맨날 봐 온 게 32나 16 같은 고정된 크기여서 하드코딩된 값을 쓰다가 나중에 그 코드를 고쳐야 하게 되면 대략 정신이 난감해질 수밖에 없다. 그리고 이것도 X값과 Y값이 서로 달라지는 일이 과연 존재할지 궁금하다.

그런데 문제는 Windows API는 아이콘이 여전히 단일 불변 크기만 있을 거라는 사상을 전제로 하고 설계되어 있다는 점이다.
HICON 은 여전히 그냥 단일 크기에 해당하는 아이콘 하나만을 나타내는 핸들이다. 즉, 한 아이콘 컬렉션 전체를 나타내는 자료형이 아니다. 그래서 LoadIcon이나 DrawIcon 같은 함수를 보면 아이콘의 크기를 받는 인자가 전혀 존재하지 않으며, 이 한계를 보완하는 LoadImage와 DrawIconEx 함수가 나중에 뒤늦게 추가되었음을 알 수 있다.

하지만 draw 기능은 몰라도 load 기능은 리소스 ID를 지정해 주면 그 ID가 가리키는 모든 크기의 아이콘을 다 로딩하게 하는 게 간편하지 않겠나 싶다. 그래서 draw 명령을 내리면, 원하는 크기와 가장 가까운 크기를 운영체제가 알아서 골라서 출력해 주는 것이다.

API의 기능이 그렇게 설계되었다면 윈도우 클래스를 등록할 때도 WNDCLASS에 이어서 굳이 작은 아이콘 핸들 hIconSm이 추가된 WNDCLASSEX 구조체가 번거롭게 또 만들어질 필요가 없었을 것이다. 그리고 응용 프로그램들이 고해상도용 아이콘을 지원하기도 훨씬 더 쉬워졌을 것이다. LoadIcon은 그냥 표준 크기 아이콘을 로딩하는 것만 지원하고, LoadImage는 아이콘을 로딩할 때 크기를 사용자가 일일이 지정해 줘야 하니 둘 다 불편한 구석이 좀 있다.

여담이지만, 응용 프로그램이나 운영체제별로 자신들이 설정하는 논리적 해상도는 제각기 좀 차이가 있다.
과거 도스용 아래아한글은 16*16 픽셀에 대응하는 글자가 10포인트였다. 그러나 Windows는 96dpi가 표준 해상도이며, 여기서는 12포인트가 16*16 크기이다.
한편, 맥 OS는 12포인트의 픽셀수가 Windows나 아래아한글보다 더 작다. 다시 맥 OS로 부팅해서 살펴보면 구체적인 비율을 알 수 있지만, 지금은 귀찮아서 생략.

이런 미묘한 문화 차이를 보면, FreeType API에서 FT_Set_Char_Size 함수에 굳이 상대 해상도 dpi값까지 인자로 받는 이유를 얼추 짐작할 수 있을 것이다. 번거롭지만 그런 것까지 다 수용할 수 있는 계층을 제공하기 위해서이다.

Posted by 사무엘

2013/06/20 19:19 2013/06/20 19:19
,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/845

요즘은 컴퓨터의 인터넷 접근성이 워낙 좋아져서 응용 프로그램의 도움말은 그냥 개발사의 웹페이지에 기재된 문서 링크를 여는 걸로 대체하는 경우가 많다. 그러나 사용자의 컴퓨터에 직접 저장되어 있는 형태의 도움말 시스템도 여전히 필요하며 수요가 있다.

Windows가 98 시절부터 도입한 CHM, 즉 HTML 도움말은 여러 HTML 문서와 그림들을 한 파일로 묶어서 단일 컬렉션 파일을 만들 수 있다. 그렇기 때문에 소프트웨어의 도움말뿐만이 아니라 웹 문서 아카이브로도 활용할 수 있고 대단히 유용하다. 그 잠재적 유용성에 비해서 MS가 이 기술을 너무 홀대하고 있다는 생각이 든다.

평소에야 HtmlHelp 함수를 호출할 때 부모 윈도우의 핸들로 내 창을 넘겨 주면 알아서 도움말 창이 잘 생성된다. 그런데 내 프로그램은 별도로 창을 만들지 않으면서 HTML 도움말만 띄우고 싶으면 어떻게 하면 좋을까?
가령, 프로그램을 /?라는 인자를 주고 실행하면 옵션 사용법 도움말만 HTML 도움말 형태로 나온 뒤 프로그램을 바로 종료하게 하고 싶을 때 말이다.

일단, 운영체제는 HH.EXE라고 간단히 HTML 도움말을 띄워 주는 껍데기 프로그램을 제공하며, CHM 확장자는 기본적으로 이 프로그램에 연결되어 있다. 그렇기 때문에 ShellExecute 함수로 내 도움말 파일을 "open" 구동을 하면 도움말이 바로 뜨긴 한다.

그러나 이 방식은 도움말을 띄우는 것 자체 말고는 도움말 창에 대해서 그 어떤 제어도 할 수 없다. 가령, index.htm 같은 기본 시작 화면이 아니라 도움말 파일 내부에 있는 특정 문서를 바로 열게 하고 싶으면 도움말을 열지 말고 HH.EXE를 열고, 옵션에다가 xxxx.chm::/yyyy.htm 같은 식으로, chm 파일과 내부의 문서 파일을 이어서 특이하게 줘야 한다.

또한, HH.EXE의 실행이 끝날 때까지 기다렸다가 다른 후속 처리를 하게 하려면 이 프로세스의 핸들을 얻어야 할 텐데, 그러려면 ShellExecute보다 사용하기가 훨씬 더 까다로운 CreateProcess를 써야 할 것이다.

사실, WinHlp32.exe로 구동되던 과거의 HLP 도움말과는 달리, HTML 도움말은 hhctrl.ocx라는 DLL을 통해 in-process로 구동된다는 큰 차이가 있다. 이 특성을 살려, 굳이 외부 껍데기 프로세스인 HH.EXE를 호출하지 않고 내 프로세스가 직접 HTML 도움말 창 하나만 띄웠다가 곱게 종료할 수는 없을까?

부모 윈도우에다가 NULL을 주고 그냥 HtmlHelp 함수만 호출한 뒤 프로그램을 종료해 버리면, 도움말 창이 한 0.1초가량 눈에 비쳤다가 곧바로 사라져 버린다.
이 함수는 도움말 창을 띄워 주는 CreateWindowEx 함수와 개념상 거의 같다고 생각하면 된다. 이 함수도 생성된 도움말 창의 핸들값을 되돌리며, 창을 만든 뒤에는 그 창을 실제로 동작하게 하는 message loop을 돌려 줘야 한다.

HWND hMyWnd=::HtmlHelp(NULL, _T("xxxx.chm"), 0, 0);
ASSERT(hMyWnd!=NULL);

MSG m;
while(::GetMessage(&m,NULL,0,0)>0) {
    ::TranslateMessage(&m); ::DispatchMessage(&m);
}

이렇게 하면 도움말 창이 나타나긴 하나..
이번엔 도움말 창을 닫아도 프로그램이 종료되지 않고 '작업 관리자'에 내 프로세스가 언제까지나 표시되어 보인다는 문제가 발생한다.

내가 직접 창을 띄우고 윈도우 클래스를 등록하고 윈도우 프로시저를 구현하였다면, WM_DESTROY 메시지에서 응당 PostQuitMessage 함수를 호출해 줘서 GetMessage가 while문을 종료하게 했을 것이다.
그러나 도움말 창은 일반적으로 닫는다고 해서 응용 프로그램을 종료시키는 용도로 쓰는 물건이 아니다. 그래서 도움말 창만 단독으로 띄울 때 이런 문제가 생기는 것이다.

HTML 도움말 창이 없어질 때 프로그램도 정상적으로 종료되게 하는 방법은 크게 두 가지이다.
첫째는, 도움말 창이 WM_DESTROY 메시지를 받는 시점을 우리 프로그램이 잡아내어 그때 인위로 PostQuitMessage 함수를 호출하는 것이다. 훅킹(SetWindowsHookEx) 또는 서브클래싱(SetWindowLongPtr)을 생각할 수 있는데, 훅킹까지 쓰는 건 너무 오버인 것 같고, 내 경험상 이럴 때는 WM_DESTROY에 대해서 추가 처리만 살짝 해 주는 서브클래싱이 무난하다.

일반적으로 서브클래싱은 대화상자 안에 있는 각종 자식 컨트롤들의 동작을 미묘하게 바꾸기 위해서 하는데, 이렇게 큼직한 프레임 윈도우도 서브클래싱이 가능하다. 뭐, 서브클래싱을 쓰든 훅킹을 쓰든 어쨌든 콜백 함수를 정의해 줘야 하고 콜백 함수에게 context를 제공하기 위한 전역 변수나 TLS 슬롯이 필요하니 일이 여러 모로 복잡해진다.

다음 둘째는 첫째보다 더 정석적인 방법이다.
사실은 HTML 도움말 시스템 자체에, 도움말 창이 종료될 때 WM_QUIT 메시지를 보내게 하는 옵션이 있다. 딱 한 번만 옵션을 지정해 주고 나면 뒤끝 없이 OK이고 훅킹이고 뭐고 같은 지저분한 루틴이 없으니 아주 좋다. 그러나 옵션을 지정해 주는 방법이 생각보다 굉장히 지저분하다. API가 좀 구리게 설계되었다.

HH_WINTYPE hwt, *pwt=NULL;
::HtmlHelp(NULL, _T("xxxx.chm>main"), HH_GET_WIN_TYPE, (DWORD_PTR)&pwt);
if(pwt) {
    hwt=*pwt;
    hwt.fsValidMembers=HHWIN_PARAM_PROPERTIES;
    hwt.fsWinProperties=pwt->fsWinProperties|HHWIN_PROP_POST_QUIT;
    ::HtmlHelp(NULL, NULL, HH_SET_WIN_TYPE, (DWORD_PTR)&hwt);
}

이미 도움말 창이 떠 있는 상태에서 HtmlHelp 함수를 또 호출한다. 그런데, 도움말 창에 대한 정보를 얻기 위해서 창 핸들을 넘기는 게 아니라 또 도움말 파일을 길게 지정하고(중복 과잉 정보 공급), 그 뒤에 창의 내부 이름을 지정해 줘야 한다. 창의 내부 이름은 그 도움말 파일을 만든 사람이 지정해 준 명칭이다(저 예에서는 main).

핵심은 property에다가 HHWIN_PROP_POST_QUIT라는 속성을 추가로 지정해 주는 것이다. 이 상수는 불행히도 MSDN에 제대로 문서화도 돼 있지 않은 완전 잉여이다. 덕분에 이 명칭으로 구글링을 해도 수 페이지에 걸쳐서 이 이름의 값이 선언된 헤더 파일만 잔뜩 걸려 나올 뿐, 더 자세한 설명은 사실상 존재하지 않는다. HTML 도움말을 이런 식으로 깊숙하게(?) 다룰 생각을 하는 사람도 없을 테고 말이다.

나도 htmlhelp.h 파일을 뒤지다가 이걸 정말 우연히 발견했다. 그래도 이걸 써 주니 도움말 창을 닫을 때 프로그램이 바로 종료되게 할 수 있었다. Windows 98부터 8까지 다 잘 동작한다. HTML 도움말을 만든 개발팀에서 이 도움말 창만 단독으로 뜨는 상황도 생각을 안 한 건 아니었던 것이다.

공용 컨트롤을 다루면서 LVITEM 같은 구조체를 다룬 경험이 있는 분이라면, 저건 API 설계가 좀 특이하다는 걸 알 수 있을 것이다. 보통은 구조체를 선언하고, 구조체의 크기(t.cbSize=sizeof(t))와 얻고 싶은 정보를 나타내는 비트 플래그를 지정한 뒤, 구조체의 주소를(&t) get 함수에다 넘겨 준다.

그런데 HtmlHelp의 GetWinType는 아예 내부 포인터를 받게 돼 있다.
그리고 내가 지정하는 값은 property밖에 없음에도 불구하고 set을 할 때 일단은 구조체의 모든 멤버들의 값을 넘겨 줘야 한다(hwt=*pwt). 안 그러니까 프로그램이 에러가 나더라. 여러 모로 형태가 이상하다.

사실, HTML 도움말에는 저런 옵션을 지정할 필요가 없이 부모 윈도우에다가 여러 이벤트를 알려 주는 기능이 있다. 도움말 창이 처음으로 뜰 때(HHN_WINDOW_CREATE), 각종 페이지 이동 버튼을 누를 때(HHN_TRACK), 어떤 페이지를 성공적으로 열었을 때(HHN_NAVCOMPLETE) 이렇게 세 개가 정의되어 있는데, 사용자가 X 버튼을 눌러서 도움말 창이 소멸하는 시점을 알려 주는 기능이 없는 것은 개인적으로 굉장히 뜻밖이다. 왜 정작 필요한 이벤트는 없는 걸까? 본인이 개인적으로 가장 직관적으로 생각한 형태는 이런 것이었는데 말이다. 물론, 메시지를 받으려면 나도 윈도우를 하나 만들어야 하는 번거로움이 있긴 하지만 말이다.

EXE의 형태로 독립적으로 돌아가는 응용 프로그램이 아니라 DLL 형태인 IME들도 도움말을 표시하는 기능이 있다. 그러나 IME들은 안정성이나 키보드 포커스 같은 이유로 인해, 또 다른 DLL을 주입시키는 HtmlHelp 함수를 호출하는 게 아니라 앞서 소개했던 HH.EXE 프로세스를 수동으로 띄우는 원시적인 방식을 사용한다.
그래서 도움말 명령을 여러 번 내리면 도움말 창이 한도 끝도 없이 여러 개 생기며, IME를 사용하는 응용 프로그램을 종료하더라도 도움말 창은 같이 없어지지 않는다. Microsoft가 제공하는 기본 한중일 3개 국어 IME들이 모두 그렇게 동작하며, <날개셋> 한글 입력기 역시 외부 모듈은 그 관행을 따르고 있다.

본인을 포함해 HTML 도움말을 사용하는 많은 개발자들이 잊고 사는 사항인데, HTML 도움말도 원래는 사용 전에 초기화가 필요하다. HH_INITIALIZE 및 HH_UNINITIALIZE를 해 줘야 하고, 심지어는 message loop에다가도 원래는 HH_PRETRANSLATEMESSAGE를 해 줘야 한다. 하지만 현실적으로 그런 것까지 신경 쓰는 프로그램은 거의 없다. in-process 형태인 대신에 WinHelp 시절보다 번거로운 게 많아졌으며, IME의 경우 그런 것을 응용 프로그램에서 다 기대할 수 없으니 도움말을 외부 프로세스 형태로 실행해 주는 게 실제로 더 안전할지도 모르겠다.

HTML 도움말은 다형성을 지닌 인자에다가 typecasting을 하면서 여러 명령을 전달한다는 점, 초기화 및 해제가 필요하고 state를 지닌 변수가 존재한다는 점 등으로 인해 나름 클래스 라이브러리로 만들기에 적절한 면모가 있다. 물론 이 클래스의 인스턴스는 딱 단일체(singleton) 형태로만 존재해도 충분할 테고. 앞서 언급했던 자체 message loop을 도는 기능 역시 이 클래스의 멤버 함수로 추가해서 제공하는 것도 디자인 차원에서 생각해 볼 만하다.
이 글에서는 어쩌다 보니 HTML 도움말 하나만으로 일반적인 Windows 프로그래밍 이슈를 비롯해 다양한 이야기가 나왔다. ^^

Posted by 사무엘

2013/05/21 08:30 2013/05/21 08:30
,
Response
No Trackback , 2 Comments
RSS :
http://moogi.new21.org/tc/rss/response/833

Windows 운영체제가 인식하는 실행 파일은 구조적으로 편의성의 상징인 GUI 프로그램과, 강력한 자동화의 상징인 콘솔(명령 프롬프트) 프로그램이라는 두 갈래로 나뉘어 있다. 이것은 SUBSYSTEM이라는 링커 옵션으로 지정 가능하다.

이 옵션이 콘솔로 되어 있으면 빌드 과정에서 링커는 C 라이브러리에서 main 함수를 찾아 호출하는 startup 코드를 연결하며, GUI로 지정되어 있으면 잘 알다시피 WinMain 을 호출하는 startup 코드를 연결한다. 해당 함수들은 물론 프로그래머가 따로 구현해 놓아야 한다.

어차피 GUI든 콘솔이든 EXE 파일이 제일 먼저 실행되는 지점은 실행 파일의 entry point에 지정된 주소이며 원래는 운영체제로부터 아무 인자도 전달되지 않는다. 그 대신, C 라이브러리가 GetModuleHandle, GetStartupInfo, GetCommandLine 등의 여러 기초적인 함수들을 먼저 호출하여 리턴값들을 WinMain에다가 전달해 줄 뿐이다.
콘솔 버전인 main도 마찬가지이다. 명령 옵션을 API 함수로 얻어 온 뒤, 그걸 C 라이브러리가 파싱하여 main에다가 argc와 argv의 형태로 전해 준다.

빌드 관점이 아닌 실제 실행의 관점에서 봐도, Windows는 콘솔 프로그램과 GUI 프로그램을 서로 약간 다른 방식으로 실행해 준다. 콘솔 프로그램의 경우 이미 명령창 같은 콘솔에서 실행되었다면 기존 콘솔을 자동으로 연결시키고, 프로그램이 탐색기 같은 GUI 환경에서 실행되어 콘솔이 없는 경우 “콘솔을 언제나 자동으로 생성”한다. 그 반면, GUI 프로그램에는 그런 조치를 취하지 않는다.

다만, 콘솔 프로그램이라고 해서 GUI 윈도우를 만들거나 메시지 loop을 돌지 말라는 법은 전혀 없으며, 반대로 GUI 프로그램도 추후에 자기만의 콘솔을 얼마든지 따로 생성해서 쓸 수 있다. 콘솔과 GUI를 적절한 혼용하면 유용한 경우가 의외로 매우 많다.

GUI 프로그램의 경우 디버깅 메시지를 찍기 위해 별도의 콘솔을 이용하는 것은 매우 흔한 테크닉이다. DOSBox가 대표적인 경우이다. 그리고 반대로 평소에는 명령창으로 문자열만을 취급하더라도, 가끔 그래프 같은 시각화된 결과물을 보여 줄 필요가 있을 때 제한적으로 GUI 윈도우를 생성하는 프로그램도 생각할 수 있다.

결국 GUI와 콘솔이 완벽하게 혼합된 프로그램이라면 이런 것도 가능해야 할 것이다.
프로그램을 아무 인자 없이 실행하거나, 또는 콘솔이 아닌 GUI 환경에서 실행하면 GUI가 나타난다. 반대로 콘솔에서 실행하거나 /? 같은 명령 옵션을 줘서 실행하면 콘솔로 메시지가 나타나고, 이미 콘솔이 있는 경우 그 콘솔을 사용한다. 압축 유틸리티 같은 게 이런 식으로 개발되어 있으면 아주 편리하지 않겠는가?

그런데 문제는 이 정도로 유연한 GUI/콘솔 하이브리드 프로그램을 만들기는 대단히 어려우며, 운영체제가 구조적으로 그런 것까지 고려하여 만들어지지는 않았다는 점이다. GUI와 콘솔 모두 2% 부족한 면모가 있다.

(1) 프로그램을 콘솔 방식으로 빌드하면, GUI 형태로 실행되어야 할 때에도 언제나 빈 콘솔창이 생겨 버린다. 프로그램이 실행되자마자 곧바로 API 함수를 호출하여 이 콘솔을 죽일 수는 있지만, 콘솔 창 같은 게 깜빡인 것이 사용자에게 그대로 드러나 보이기 때문에 이런 방식은 용납될 수 없다.

(2) 반대로 프로그램을 GUI 방식으로 빌드하면, 콘솔 환경에서 콘솔 형태로 실행되었을 때 기존 콘솔을 연결하는 방법이 없다. 콘솔 프로그램과는 달리 GUI 프로그램에서는 운영체제가 이것을 자동으로 해 주지 않는다. 콘솔에다 메시지를 찍는 것은 새로운 콘솔에다가만 가능하다. 기존 콘솔을 연결하는 AttachConsole이라는 함수가 차후에 추가되기는 했지만 방법이 완전하지 않다.

결국, 어느 방식을 선택하더라도 문제가 완전히 없을 수가 없다. 콘솔창을 필요할 때만 생성하면서 콘솔이 이미 존재하는 경우 기존 콘솔과 자동으로 연결이 되는 프로그램을 만들 수는 없는 것일까?

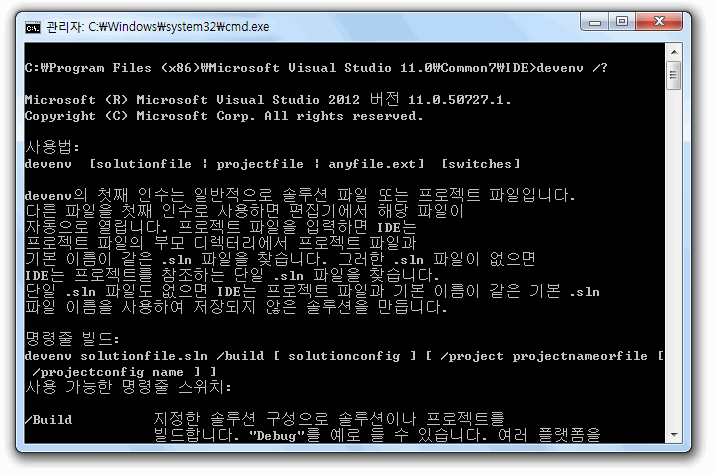
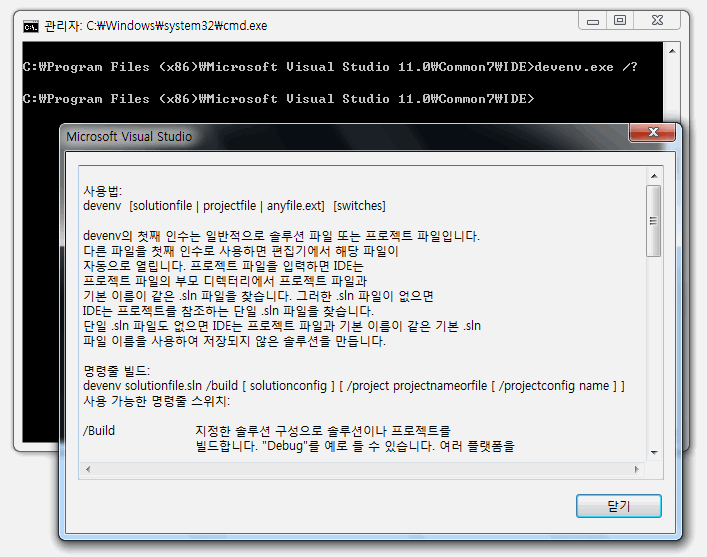
Visual Studio IDE인 devenv 프로그램은 이 문제를 해결한 듯해 보인다.
아무 인자를 안 주고 실행하면 잘 알다시피 커다란 IDE 창이 생긴다.
그러나 /? 를 주고 실행하면 각종 명령 옵션 사용법이 기존의 콘솔에다가 깔끔하게 찍힌다. 그냥 대충 도움말 창 하나 띄우고 끝인 게 아니다.
마소에서는 이것을 어떻게 구현하였을까?

그 비결은 너무 허무할 지경이다.
IDE 실행 파일이 있는 디렉터리를 가 보면, devenv 프로그램은 .exe도 있고 .com도 있어서 두 종류가 있다.

Windows는 도스 시절의 전통을 물려받았기 때문에 명령 프롬프트에서 사용자가 확장자 없이 실행 파일을 지정하면 EXE보다 COM을 먼저 실행한다. 그래서 COM은 /?  옵션 같은 걸 받아들이는 콘솔 프로그램으로 만들고, EXE를 GUI 프로그램으로 드는 꼼수를 쓴 것이다! devenv /?가 아니라 devenv.exe /? 라고 확장자를 강제 지정하면 명령 옵션 리스트가 역시나 대화상자 GUI 형태로 출력되는 걸 볼 수 있다. ^^

사용자 삽입 이미지사용자 삽입 이미지
도스 시절에 COM은 잘 알다시피 EXE보다 더 작고 단순한 실행 파일이다. 실행 파일 자체의 헤더나 파일 포맷 같은 게 존재하지 않으며, 메모리 재배치도 없이 최대 64KB의 크기 안에 x86 기계어 코드와 데이터가 모두 들어가고 컴퓨터의 고정된 메모리 주소에 그대로 주입되어 실행되었다.

요즘이야 COM이나 EXE나 모두 동일한 실행 파일이다. 오히려 COM 확장자를 사칭하여, 사용자가 의도한 프로그램 대신 악성 코드를 먼저 실행시키는 보안 위험이 문제되고 있는 지경이다. 마치 autorun 기능을 막듯이 COM의 실행을 막아 버리면 속 시원할지 모르나, 과거 프로그램과의 호환성 차원에서 그게 속 시원하게 가능할지는 모르겠다. 그래도 64비트 Windows는 아예 16비트 프로그램을 실행하는 기능 자체가 없어진 지 오래인데..

어쨌든, 실행 파일의 확장자로 콘솔용과 GUI용 프로그램을 구분시킨 건 Windows에서 배치 파일을 이용하여 자기 자신을 제거하는 프로그램을 만드는 것만큼이나 참 기발한 꼼수인 것 같다. 세상에 그런 방법을 쓸 줄은 몰랐다.

※ 추가 설명

1. Windows용 qt 라이브러리를 사용한 프로그램은 GUI 프로그램임에도 불구하고 main 함수에서 실행이 시작된다. 이것은 물론 qt 라이브러리의 내부에 WinMain 함수가 있어서 그게 사용자의 main 함수를 또 호출하기 때문일 것이다. MFC 라이브러리도 자체적인 WinMain 함수가 내부에 존재한다는 점을 감안하면 이는 충분히 수긍이 가는 디자인이다.

더구나 Windows를 제외한 다른 운영체제들은 실행 파일의 성격을 Windows처럼 GUI 아니면 콘솔 형태로 이분화하지 않으며 똑같이 main 함수를 쓴다. 그렇기 때문에, 크로스 플랫폼을 지향하는 qt는 응당 Windows에서의 프로그래밍 방식도 main을 기준으로 맞췄다고 볼 수 있다.

2. 과거의 16비트 Windows 시절에는 말 그대로 도스 프롬프트만이 있었을 뿐 콘솔이라는 게 없었다. 이것만으로도 그때 Windows는 구조적으로 기능이 굉장히 빈약했음을 알 수 있다.

Posted by 사무엘

2013/05/01 19:24 2013/05/01 19:24
, ,
Response
No Trackback , 4 Comments
RSS :
http://moogi.new21.org/tc/rss/response/825

컴퓨터 소프트웨어의 GUI 요소 중에는 잘 알다시피 체크 박스와 라디오 박스가 있다.
전자는 n개의 항목을 제각각 복수 선택할 수 있기 때문에 선택의 가짓수가 2^n개가 가능하다.
그 반면 후자는 n개의 항목 중 하나만 선택할 수 있기 때문에 선택의 가짓수가 딱 n이 된다.

그리고 이런 개념은 사실 메뉴에도 존재한다.
메뉴 항목은 사용 가능 여부(enabled)와 더불어 체크 여부(checked)라는 상태가 존재하여, 자신이 체크된 것처럼 보이는 시각적 피드백을 줄 수 있다.

Windows는 초창기엔(=16비트 시절) 말 그대로 √ 1종류만이 존재했다. 이를 제어하는 함수는 CheckMenuItem이다.
그러다가 Windows 95/NT4에서부터는 ● 모양의 체크를 표시해 주는 CheckMenuRadioItem 함수도 추가되었다. 이로써 각각의 항목들을 따로 체크할 수 있는 메뉴와, 여러 개 중 한 모드만 선택할 수 있는 메뉴의 구분이 가능해졌다.
CheckMenuRadioItem는 특정 메뉴 항목 하나의 속성을 바꾸는 여타 함수들과는 달리, 메뉴 항목들을 여러 개 한꺼번에 지정한 뒤 하나만 체크를 하고 나머지는 체크를 모두 자동으로 해제하는 형태로 동작한다.

그런데 재미있는 것은, MFC는 95/NT4 이전의 16비트 시절에서부터 메뉴에다 custom 비트맵을 지정하는 독자적인 방식으로 라디오 박스를 자체 지원해 왔다는 점이다.
운영체제에 CheckMenuRadioItem가 추가된 뒤에도 내부적으로 그 함수를 쓰지 않는다. 이것은 비주얼 C++ 2012의 최신 MFC도 변함이 없다.

MFC는 동일한 명령 ID에 대해서 메뉴, 도구모음줄 등 여러 GUI 요소에 대해 일관되게 checkd/enabled 상태를 관리할 수 있게 이 계층만을 CCmdUI라는 클래스로 따로 뽑아 냈다. 그리고 윈도우 메시지의 처리가 끝난 idle 시점 때 모든 GUI 상태들을 업데이트한다.
MFC 소스를 보면, CCmdUI::SetCheck는 CheckMenuItem 함수를 호출하는 형태이다. 그러나 CCmdUI::SetRadio는 운영체제의 API를 쓰는 게 아니라 자체 생성한 bullet 모양 비트맵을 SetMenuItemBitmaps로 지정하는 좀 더 힘든 방법을 쓴다.

고전 테마를 포함해 심지어 Windows XP의 Luna에서도 운영체제가 그려 주는 radio 그림과 MFC가 그려 주는 radio 그림은 차이가 거의 없었다. 둘 다 그냥 글자와 동일한 모양으로 동그란 bullet을 그리는 게 전부였다. 그렇기 때문에 두 구현이 따로 노는 건 그리 문제될 게 없었다.

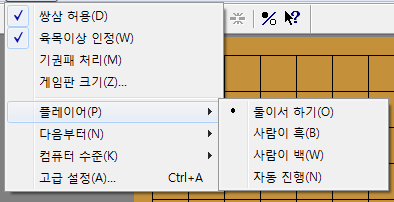
그러나 문제는 Vista 이후에서부터이다. 운영체제가 그리는 radio 그림은 더 알록달록해지고 배경까지 가미되어 화려해진 반면, MFC가 그리는 radio 그림은 아직까지 단색의 단조로운 bullet이 전부이다. 그래서 시각적으로 이질감이 커졌다. 그것도 일반 체크(√) 항목은 괜찮은데 라디오(●) 그림만 차이가 생긴 것이다.

사용자 삽입 이미지사용자 삽입 이미지

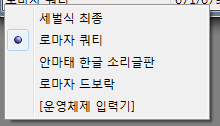
이해를 돕기 위해 그림을 첨부한다. Windows Vista 이후에 운영체제가 메뉴에다 그려 주는 라디오 체크는 배경에 은은한 무늬가 생겨 있다(왼쪽). 그러나 MFC가 그리는 라디오 체크는 여전히 옛날 스타일대로 단색 동그라미밖에 없으며, 일반 체크와도 형태가 다르다(오른쪽). 오른쪽의 프로그램은 본인이 예전에 MFC 기반으로 개발했던 오목 게임이다. ㅋㅋ

MFC는 운영체제의 새로운 함수를 왜 쓰지 않는 걸까?
그냥 이런 사소한 데에까지 신경을 안 써서 그런 것일 수도 있고, 또 CCmdUI는 각각의 메뉴 항목에 대해 개별적으로 호출되는 반면 CheckMenuRadioItem는 그 자체가 여러 메뉴 항목의 상태를 한꺼번에 바꾸는 함수이기 때문에 기능의 구현 형태가 서로 맞지 않아서 도입하지 않은 것일 수도 있다.

물론, SetMenuItemInfo라는 만능 함수를 쓰면, 개별적으로 라디오 체크 상태를 바꾸는 것도 불가능하지는 않다. 다만, 구조체를 준비해야 하는 데다, 상태(state)만 옵션으로 간단히 바꾸면 되는 게 아니라 메뉴의 유형(type)까지 바꿔야 하니 일이 좀 번거로운 건 사실이다.

다만, 요즘은 MFC에도 잘 알다시피 MS Office나 Visual Studio의 모양대로 GUI 외형을 싹 바꿔 주는 툴킷이 도입되었고, 이런 상태에서는 어차피 메뉴의 요소들이 무조건 모조리 자체적으로 그려진다. 그러니 저런 SetRadio와 SetCheck의 동작 방식의 차이 같은 것도 존재하지 않으며, 그런 걸 논하는 게 아무 의미가 없다. 저건 오로지 운영체제 표준 GUI를 쓸 때만 발생하는 이슈이기 때문이다. ^^

* 글을 맺으며..

WinMain 함수를 포함해 윈도우 클래스 등록, 프로시저 구현을 전부 직접 하면서 Windows용 응용 프로그램을 밑바닥부터 만들어 본 사람이라면, MFC가 내부적으로 프로그래머에게 몰래 해 주는 일이 얼마나 많은지를 어렴풋이 짐작할 수 있다.

  • 대화상자를 창의 가운데에다 배치해 주는 것,
  • 프레임 윈도우와 뷰 윈도우 사이의 경계에 깔끔한 입체 모양 테두리 넣는 것,
  • 고대비 모드일 때 도구 아이콘의 검은색을 흰색으로 바꾸는 것,
  • 심지어 콤보 박스 내부에 디폴트 데이터(리소스 에디터에서 만들어 넣었던)들을 집어넣는 것,
  • 프레임 윈도우가 키보드 포커스를 얻었을 때 그 아래의 view 윈도우로 포커스를 옮기는 것,
  • 프로퍼티 시트의 내부에 들어가는 프로퍼티 페이지들의 글꼴을 운영체제 시스템 글꼴로 바꾸는 것 등..

이런 사소한 것들도 공짜가 아니라 죄다 MFC가 내부에서 해 주는 일들이다.
Windows API만 써서 프로그램을 만드는 방식은 최고의 작고 가볍고 성능 좋은 프로그램을 만들 수 있지만 생산성도 미칠 듯한 저질이기 때문에, 인제 와서 이런 불편한 방식으로 프로그램을 만들 프로그래머는 거의 없을 것이다. 요즘 세상에 C++도 아닌 C는 사실상 어셈블리나 마찬가지다.

Posted by 사무엘

2013/04/29 08:34 2013/04/29 08:34
, ,
Response
No Trackback , 8 Comments
RSS :
http://moogi.new21.org/tc/rss/response/824

« Previous : 1 : ... 17 : 18 : 19 : 20 : 21 : 22 : 23 : 24 : 25 : ... 32 : Next »

블로그 이미지

그런즉 이제 애호박, 단호박, 늙은호박 이 셋은 항상 있으나, 그 중에 제일은 늙은호박이니라.

- 사무엘

Archives

Authors

  1. 사무엘

Calendar

«   2026/10   »
일 월 화 수 목 금 토
        1 2 3
4 5 6 7 8 9 10
11 12 13 14 15 16 17
18 19 20 21 22 23 24
25 26 27 28 29 30 31

Site Stats

Total hits:
4192437
Today:
673
Yesterday:
1684