« Previous : 1 : ... 23 : 24 : 25 : 26 : 27 : 28 : 29 : 30 : 31 : ... 32 : Next »

윈도우 프로그래머라면 이미 다 아시겠지만, 비스타에서부터 task dialog라는 아주 참신한 UI 기능이 추가되었다.
구닥다리 MessageBox를 쓰자니 뭐가 많이 부족하고,
그렇다고 해서 겨우 에러 메시지 하나 찍자고 별도의 대화상자를 또 만들자니 너무 번거로운데
task dialog는 가히 사막에 있는 오아시스 같은 존재가 아닐 수 없다.
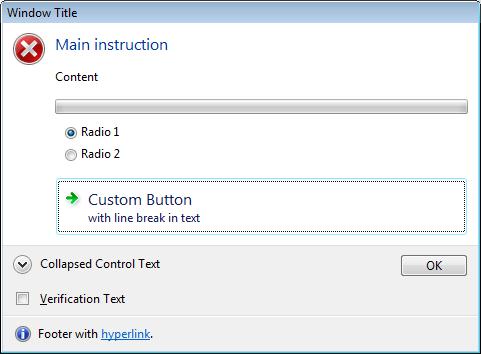
사용자 삽입 이미지
위의 그림은 바로 task dialog의 뼈대. (출처: MSDN)

이제 당장 운영체제부터가 상당수의 UI를 task dialog으로 구현하고 있고,
메모장부터 워드패드까지 모든 기본 프로그램들의 “문서를 저장하시겠습니까?” 대화상자도 죄다 task dialog로 바뀌었다.
덕분에 Yes / No 일색이던 버튼이 Save / Don't save로 바뀐 걸 알 수 있다. task dialog는 각 버튼들에 들어가는 텍스트를 사용자가 자유롭게 지정 가능하기 때문이다.

Y/N이라고만 하면 이게 무슨 질문에 대한 “예/아니요”인지, 응답에 대한 결과를 사용자가 한 단계 더 추론을 해야 한다.
그러나 대놓고 “저장함/저장 안 함”이라고 표시를 해 주면, 이 선택으로 인해 야기되는 결과를 사용자가 더 직관적으로 알 수 있다. MS는 저런 UI 용어 하나하나까지 세심하게 검토를 해 온 것이다.

이것뿐만이 아니라 또 개인적으로 본인은 task dialog가 유용하다고 가장 먼저 느낀 면모가 뭐냐 하면,

“다음부터 이 확인 질문 안 하기” 부류의 체크 상자를 간단하게 추가할 수 있다는 점이었다. 과거의 MessageBox에서 진짜로 2% 부족한 면모였다.
그래픽 모드나 해상도를 바꾼 뒤에 타이머를 걸어서 “화면이 잘 나타나 보입니까? n초 이내에 응답이 없으면 원래 모드로 되돌립니다”를 구현하는 것도 이 task dialog로는 드디어 가능하다. 예전에는 그런 걸 구현하려면 전용 대화상자를 따로 만들어야 했다.

task dialog에는 인터넷 URL 링크를 넣을 수 있고, 라디오 버튼을 넣어서 사용자의 간단한 선택을 받을 수도 있다. 제목-본문 형태로 텍스트를 깔끔하게 배치할 수 있다는 것도 아주 좋은 점이다.
물론, 워낙 기능이 많기 때문에 사용하기가 다소 까다롭다는 건 어쩔 수 없다. 그래서 이를 간소화하기 위해, 비주얼 C++ 2008의 확장팩 내지 2010부터는 MFC에도 CTaskDialog라는 클래스가 추가되었다. 자료구조 관리는 이 클래스가 다 알아서 해 주기 때문에 사용자는 코드 한 줄로 간단하게 원하는 버튼, 원하는 컴포넌트들을 대화상자에다 추가할 수 있다.

그런데 task dialog로 할 수 있는 일은 단순히 메시지를 찍고 사용자로부터 간단한 피드백을 받는 일에 국한되지 않는다.
progress bar를 넣는 기능이 있고 bar의 상태를 일정 주기로 업데이트까지 가능하기 때문에, 이를 이용하면 진행 상황 표시 대화상자도 간단하게 구현 가능하다.

본인은 task dialog를 제어하는 코드와 스레드 작업 관련 코드를 한데 합쳐서 별도의 클래스를 만들어 이를 개인적으로 매우 즐겨 사용한다. task dialog를 사용하는 형태는 딱 정해져 있으니까 별로 customize를 하지 않고, 작업 상황 표시와 작업 스레드의 customization이 이 클래스의 존재 목표가 되는 셈이다.

task dialog 콜백과 스레드 콜백 함수는 내부의 private static 함수로 숨겨 놓는다. 스레드 콜백 함수는 this 포인터에 대해서 아래의 순수 가상 함수를 호출한다.

virtual UINT Work() = 0; //오버라이드 할 것
volatile int m_nCurPos, m_nPosMax; //현재/전체 진행 상황
volatile bool m_bCancel;

그리고 task dialog 콜백은 당연히.. 주기적으로 m_nCurPos 값을 체크하여 progress bar를 업데이트한다.
사용자가 도중에 취소 버튼을 눌러 버렸다면, m_bCancel 플래그가 설정된다. 작업 스레드는 이 값을 수시로 체크해서 사용자가 중단을 요청했다면 신속히 작업을 중단해야 할 것이다.

일이 언제 끝날지 모르는 작업에 대해서는 게이지가 marquee 형태로 뱅글뱅글 돌기만 하게 만들 수도 있다. 윈도우 부팅할 때처럼 말이다.

다만 한 가지 아쉬운 것은, task dialog는 진행 상황 표시만 전문으로 하는 녀석이 아니다 보니, progress bar를 두 개 표시해 주는 기능은 없다는 점이다.
설치 프로그램이라든가 압축/FTP 유틸리티처럼 파일을 다루는 프로그램들은 현재 처리하고 있는 파일의 진행률과 그리고 전체 작업의 진행률을 한데 표시하고 있으며, 이건 매우 흔한 관행이다. 이건 여전히 내가 직접 대화상자를 만들어야 할 것 같다.

.
.

그나저나 드디어 윈도우 7도 SP1이 정식 출시된 지 한 달쯤 됐다.
콘솔에서 세벌식으로 한글 입력할 때 한글+기호 입력이 제대로 안 되던 버그도 고쳐졌으려나? (난 7 안 써서 잘 모르겠다) 했는데
어느 지인의 얘기에 따르면 여전하다고 하네... -_- 어쩌라고.

Posted by 사무엘
2011/03/17 08:32 2011/03/17 08:32
, , ,
Response
No Trackback , 2 Comments
RSS :
http://moogi.new21.org/tc/rss/response/481

큼직한 그래픽 화면에서 마우스로 조작하는 컴퓨터-사용자 인터페이스를 일명 GUI라고 부른다.
매킨토시가 원조라고 하는 이런 환경에서는 대화상자가 라벨, 입력란, 리스트박스, 버튼 같은 몇몇 기초 UI 요소들로 구성되며, 이 구성요소들을 윈도우 프로그래밍에서는 ‘컨트롤’이라고 부른다. GUI에서 일종의 부품과도 같다.

이런 GUI와는 달리, 그냥 전통적인 선택 막대만으로 각종 기능을 선택하고 옵션을 설정하는 단순한 인터페이스도 있는데, 과거의 도스용 아래아한글이 대표적인 예였다.
단순한 인터페이스는 말 그대로 너무 단조로워 보이기는 하지만, 다른 건 몰라도 화면 차지 면적이 작다는 장점 하나는 독보적이기 때문에 요즘은 스마트폰의 UI에서 제 위치를 찾은 것 같다.

이 글의 주제는 윈도우 GUI 컨트롤이므로 다시 GUI로 화제를 바꾸기로 한다.
아까 말했던 입력란(edit box), 라벨, 리스트박스, 버튼(체크, 라디오 등도 포함) 같은 건 기본 중의 기본 필수 요소이며, 까놓고 말해 윈도우 1.0 시절부터 존재했던 녀석이다. 해당 컨트롤의 기능은 운영체제와 완전히 일심동체가 되어 깊숙이 박혀 있다.
비단 운영체제의 GUI뿐만이 아니라 어느 GUI 툴킷을 보더라도 저런 컨트롤이 빠진 물건은 없다.

그런데 세월이 흐르다 보니 좀 더 새끈하고 산뜻한 컨트롤이 필요해졌다.
그래서 1990년대 후반, 윈도우 NT 3.51, 그리고 윈도우 95에서부터 운영체제 차원에서 새로운 컨트롤들이 여럿 도입되었다.
이름하여 공용 컨트롤(common control). 윈도우 1.0 때부터 있었던 innate한 선배들 system control과 구분하기 위해 붙은 이름이다.

무엇이 추가되었냐 하면,
트리 컨트롤: 계층 구조, 목차 따위를 표시할 수 있다.
리스트 컨트롤: 수많은 개체를 단순히 리스트 형태뿐만이 아니라 아이콘 모양으로도 표시할 수 있고, 개체의 특성을 여러 칼럼으로 분할해서 표현할 수 있어서 유용함.
도구모음줄(toolbar)과 상태표시줄(status bar)
탭 컨트롤
진행 상황 게이지 컨트롤(progress bar)

나름 쓸모 있는 것들이 많다. 특히 윈도우 95의 탐색기는 죄다 이 새로운 컨트롤을 잔뜩 우려먹어서 만든 것이다.
리스트 컨트롤과 기존 리스트박스는 하는 역할이 일면 비슷하다 할 수 있으나, 아이템을 추가하거나 정보를 얻어 오는 프로그래밍 인터페이스는 서로 완전히 다르다. 새로운 녀석이 기능이 워낙 많다 보니 훨씬 더 복잡하다. 게다가 둘은 사용법도 차이가 있다. 가령, 아이템을 복수 선택할 때 기존 리스트박스는 Shift+F8과 Space를 사용하지만, 리스트 컨트롤은 Ctrl+화살표와 Ctrl+Space를 사용한다.

이들 공용 컨트롤들은 어차피 MS가 오피스 같은 선구자적(?) 제품에서 자체 구현해 놓고 쓰던 컨트롤들을 운영체제 차원에서 정형화해 놓은 게 많았다.
예를 들어 도구모음줄과 상태표시줄은 어느 응용 프로그램들이나 자체적으로 구비해 놓던 GUI 요소였는데 그걸 다루기 쉬운 정식 컨트롤로 만들어 놨다. MFC도 16비트 시절에는 CToolBarCtrl이 도구 아이콘을 그리고 관리하는 자체 구현이었지만, 32비트부터는 공용 컨트롤에다 요청만 하는 형태로 바뀌었다.

윈도우 3.x의 매체 재생기는 자체 구현한 slider로 재생 위치를 표시했지만, 윈도우 95의 매체 재생기(지금 있는 Media Player의 전신)는 공용 컨트롤에 있는 slider를 썼다.
윈도우 3.x 시절의 설치 프로그램들은 자체 구현한 게이지로 설치 진행 상황을 표시했지만, 윈도우 95의 설치 프로그램은 공용 컨트롤에 있는 게이지를 쓴다. 컨트롤들의 재사용성이 향상된 셈.
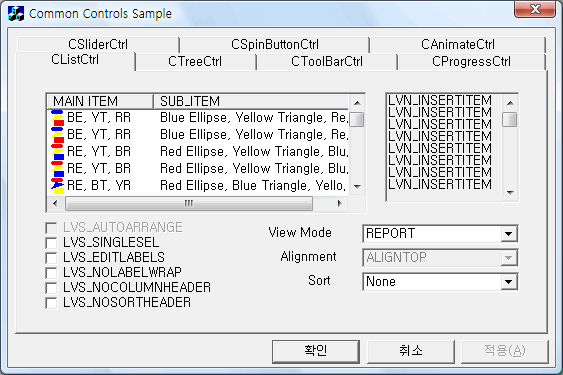
비주얼 C++ 4.x의 예제 프로그램 중에는 이런 공용 컨트롤들을 다루는 모습만 시연해 놓은 놈도 있을 정도였다. 아래 그림을 참고하라.

사용자 삽입 이미지

공용 컨트롤들은 시기적으로 나중에 추가된 만큼, 기존 시스템 컨트롤만치 운영체제와 뗄레야 뗄 수 없는 일심동체 형태는 아니었다. 시스템 컨트롤들의 코드가 운영체제의 3대 요소 중 하나인 user(32)에 통합되어 있다면, 공용 컨트롤은 comctl32라는 고유한 라이브러리에 따로 들어있었다. 그리고 이들 컨트롤을 쓰려면 응용 프로그램이 comctl32.dll을 로딩하고 InitCommonControls 같은 함수도 호출해 줘야 했다.

실제로, ListBox, ComboBox, Edit 같은 시스템 컨트롤들은 언제라도 GetClassInfo 함수로 컨트롤의 정체성 정보를 확인할 수 있는 반면 SysListView32, msctls_statusbar32 같은 공용 컨트롤은 comctl32.dll을 별도로 읽어들이고 나야 정보를 얻을 수 있다. 운영체제와 완전한 일심동체가 아니라는 말이 이런 의미인 것이다.

다만, 굳이 InitCommonControls 초기화를 할 필요는 없이 그 DLL을 LoadLibrary만 해 줘도 되는 듯하다.
또한, 이들 컨트롤을 운영체제의 대화상자에서 쓴다면, 어차피 DialogBox 같은 함수가 comctl32.dll의 로딩과 공용 컨트롤의 초기화 정도는 알아서 해 주는 것 같다. 따라서 현실적으로는 응용 프로그램 개발자가 일일이 InitCommonControls를 호출은 안 해도 된다.

공용 컨트롤 라이브러리는 저렇게 새로운 컨트롤만 부품 차원에서 제공하는 게 아니라, 이들 컨트롤을 이용한 자체 UI 기능도 함수 형태로 제공한다. 탭 컨트롤을 이용한 Property Sheet와, ‘이전, 다음’ 형태인 Wizard가 대표적인 예이다. 이것도 윈도우 3.x 시절부터 자체 구현이 하도 유행으로 뜨다 보니까 운영체제 차원에서 자동화 기능을 넣어 준 셈이다.

윈도우 95 이후로 공용 컨트롤 라이브러리는 윈도우 XP에서 또 큰 변화를 겪었다. 이는 물론 테마라는 기능이 추가되었기 때문이다.
컨트롤을 그리는 방식이 예전과는 근본적으로 완전히 다르게 바뀌었기 때문에, 예전 라이브러리를 고칠 수는 없어서 그건 호환성 차원에서 그대로 두고 새 라이브러리를 덧씌우는 방식이 채택되었다. 바로 윈도우 XP에서 추가된 DLL side-by-side assembly 매니페스트 방식으로 말이다.

윈도우 시스템 디렉터리에 있는 comctl32.dll은 이제 구형이다. 윈도우 비스타나 7에서도 이놈의 제품 버전은 6.x이지만 파일 버전은 5.8x에서 멈춰 있음을 알 수 있다. 그 반면, 새로운 comctl32.dll은 Windows\winsxs 같은 완전히 다른 곳에 숨어 있다.
새로운 comctl32는 원래 user32에 있던 기존 컨트롤들을 테마가 적용된 자기 걸로 다 대체해 버린다. 그래서 Spy++ 같은 프로그램으로 확인해 보면, Edit· Button 같은 시스템 컨트롤들도 클래스 스타일에 CS_GLOBALCLASS 같은 플래그가 있다.

또한, URL 링크 같은 새로운 공용 컨트롤이 XP에서 추가되었는데, 이런 것들은 응용 프로그램이 6.0 버전 이상의 새로운 공용 컨트롤 라이브러리를 사용하겠다는 표식을 명시적으로 해야만 사용 가능하다. 나중에 새롭게 추가된 기능은 호환성을 지키기 위해 옛날 프로그램들에게는 바로 노출되지 않으며, 접근 내지 사용하가 이런 식으로 더욱 까다로워진다는 걸 알 수 있다.

이거 지정을 위해 예전에는 개발자가 매니페스트 xml 문서를 직접 써 줘야 했지만 비주얼 C++ 2005부터는 #pragma comment(linker, ...) 한 줄로 손쉽게 할 수 있다. 사실, 2005부터는 MFC와 C 라이브러리 DLL 지정도 이런 방식으로 바뀌었고, 2008부터는 윈도우 비스타에서 추가된 응용 프로그램 권한 등급 지정도 이렇게 할 수가 있다는 것도 잘 알려진 사실이다.

윈도우 비스타에서부터 추가된 UI 기능인 Task dialog 역시 comctl32.dll에 기능이 구현되어 있으며, 공용 컨트롤 6.0 이상이 지정된 응용 프로그램에서만 사용 가능하다. 쉘(shell32)이나 공용 대화상자(comdlg32) 계층에 구현되어 있지 않나 생각했는데 그렇지는 않다.

닷넷 프레임워크에서는 저런 운영체제의 지저분한 버전 별 디테일을 전혀 신경 쓸 필요가 없다는 게 좋은 점 중 하나이겠다.

Posted by 사무엘

2011/02/26 08:12 2011/02/26 08:12
, , ,
Response
No Trackback , 2 Comments
RSS :
http://moogi.new21.org/tc/rss/response/471

칠레처럼 아주 길쭉한 국가가 있다고 치자. 이 국가에는 지형을 따라 거대한 간선 철도가 놓여 있고 n개의 역이 있으며, n개의 역에 모두 정차하는 완행 열차가 일정 간격으로 다닌다.

이 설정을 좀 극단적으로 확장하여 역 수가 수백, 수천, 수만-_-개에 달한다고 가정하자. 그렇다면 급행 열차를 운행할 필요가 응당 생긴다. 2000개역쯤 떨어진 지역에 가려고 하는데 전역정차 열차를 탈 수는 없는 노릇 아닌가. 그렇게 여행 거리가 길어지면, 급행 열차가 서는 곳까지 가서 환승하는 불편 정도는 급행의 빠른 속도가 충분히 보상하고도 남게 된다.

자, 이를 일반화하면.. 급행도 등급이 필요해서 특급, 쾌특 등 n차원의 급행을 생각할 수 있게 된다. 등급이 올라갈수록, 서는 역 수가 무척 적어서 타기 힘든 대신에 일단 타기만 하면 엄청난 이동성이 보장된다. 급행과 완행은 배차 간격은 모두 동일하다고 치자.

여기서 문제가 생긴다.
각 등급의 급행 열차들은 정차역 수를 얼마로 설정하는 게 좋을까?
또한, 철도역 수 n에 대해서, 최대 몇 등급의 급행이 존재하는 게 적당할까?

n개의 역이 모두 똑같이 중요하고 이용객 수가 균일하다고 가정할 때,
어떻게 급행을 운영하는 게 승객의 평균 표정속도를 최대화하고 반대로 평균 환승 대기 시간을 최소화할 수 있을까?
선로 수는 충분하기 때문에, 완급 결합으로 인한 대피 대기 오버헤드라든가 선로 용량 걱정은 할 필요 없다고 가정하겠다. ^^

역 수가 10개 남짓이라면 급행이 있을 필요가 없겠지만, 역 수가 100개쯤 된다면 3~4개역을 건너뛰는 1차 급행에 이어서 한 10~12개쯤 역을 쉬엄쉬엄 건너뛰는 2차 급행이 있어도 좋을 것 같다.

전산학을 전공한 친구라면, 이런 부류의 문제를 생각하면서 비슷한 형태의 아주 유명한 알고리즘을 하나 떠올리게 될 것이다.
바로 '쉘 정렬'이다!

쉘 정렬은 삽입 정렬을 원소별로 띄엄띄엄 적용하되 나중에 그 간격을 촘촘히 좁히는 방식이다.
삽입 정렬은 시간 복잡도가 O(n^2)이지만, n의 크기가 작아서 띄엄띄엄일 때는 오버헤드가 크지 않으며, 또 편차가 커서 리스트가 상당수 정렬되어 있을 때는 매우 빠르게 수행되기 때문에 그 특성을 이용한 것이다.
쉘 정렬은 알고리즘의 특성상 실제로 코딩해 보면 루프가 3중, 4중으로 들어가기 때문에 무거울 것 같지만 돌려 보면 성능이 매우 좋다. 프로그래밍 언어라고는 아직 어셈블리밖에 없던 1950년대에 고안된 알고리즘이다.

여타 정렬 알고리즘들이 O(n^2), O(n log n) 아니면 심지어 O(n) 같은 식으로 시간 복잡도가 딱 파악되는 반면, 이 쉘 정렬은 비록 O(n^2)보다야 훨씬 빠르긴 하지만 시간 복잡도가 제대로 분석되어 있지 않다.
삽입 간격을 설정해서 좁히는 방식을 어떻게 설정하냐에 따라서 성능이 크게 달라지기 때문이다.

완행 다음으로 급행을 겨우 1역 균일 통과, 특급을 2역 균일 통과처럼 정말 무식하기 짝이 없게 운행하지는 않는다. 급행 등급이 하나 올라갈 때마다 급행은 최소한 기하급수적으로 통과역 수가 늘어야 이치에 맞다.
쉘 정렬도 그와 마찬가지이다. 23, 10, 4, 1 같은 급으로 큼직하게 수가 바뀌고, 이 수들이 가능한 한 서로소가 되게 하는 게 정렬 효율에 좋다고 알려져 있다. 16, 8, 4, 2, 1처럼 정확하게 컴퓨터스럽게 배수· 약수 관계로 포개지는 간격은 매우 비효율적이며, 그런 나쁜 수열을 쓰면 쉘 정렬의 시간 복잡도가 최악의 경우 도로 O(n^2)로 치솟는다고 한다.

우리나라의 급행 전철이 정차역 수가 여전히 너무 많다는 지적이 있긴 하지만, 이것은 환승을 싫어하는 국민 정서 내지 환승이 불편한 구조, 급행도 어차피 최대 속도는 동일하고 완행보다 그렇게 많이 빠르지 않은 것, 역마다 weight가 현실적으로 차이가 나는 것, 급행의 소극적인 운행(긴 배차 간격) 같은 다른 환경적인 요인 때문에 그런 것이다. (현실에서는 환승역이냐 그렇지 않느냐의 여부 하나만으로도 역별 weight가 크게 벌어질 수밖에 없다)

이상, 철도와 전산학을 융합한 뻘글이었다.
쉘 정렬의 수열 설정 방식이 철도 운영에서도 이론상 효율적이라 말할 수 있을까? ^^;; (급행은 4역씩 건너뛰고 특급은 10개역, 쾌특은 23개역.. ㄲㄲ)
참고로 쉘 정렬은 수열을 제일 잘 설정했을 때 시간 복잡도가 O(n (log n)^2) 까지는 떨어진다고 한다.


* 덧붙이는 말:
어제는 KTX 열차가 개통 사상 처음으로 탈선 사고를 일으켰다고 한다.
여기에 대해 철도 덕후 사무엘 님의 공식 입장을 말하자면, 이건 두말 할 나위도 없이 선로 시설 문제이지 차량 문제가 아니라는 것이다.
차량이 떼제베가 아닌 산천이었다고 하는데, 지금까지 늘 말썽을 일으켜 온 것처럼 차량이 고장을 일으킨 거라면, 그대로 차가 멈춰서는 걸로 끝나지 지가 무슨 능력으로 탈선까지 하겠는가?

더구나 이 차는 보기 드문 광명 시종착 KTX였다. 광명이 단순 경유역이 아닌 종착역이기 때문에 여타 열차와는 다른 선로로 건너가야만 했다. 그래서 선로 분기기가 열차를 새 선로로 유도하고 있었는데, 열차가 다 건너기 전에 선로 분기기가 전산 착오 내지 추위로 인해 오작동한 것 같다. 그래서 뒷부분 객차의 진로를 막았고, 이것 때문에 찌이이이익 소음+타는 냄새+탈선이 야기된 것으로 추정된다.

열차가 고속으로 쌩쌩 달리다가 교량이 붕괴했다거나 차량이 자폭이라도 한 것과는 전혀 다른 부류의 사고이다. 오히려 열차는 종착역 진입을 앞두고 위와 같은 이유로 인해서 아주 천천히 달리면서 신호를 기다리고 있는 상태였을 것이다. 그리고 그 사고도 그런 특수한 상황에서나 발생한 사고이다. 이 사고가 KTX 차량 시스템 전반에 대한 불신풍조로 이어지기는 않기를 본인은 바란다.

이 사고로 인해 이 열차를 바로 뒤따라오던 상행 KTX는 평택쯤에서 다시 천안아산-_- 역으로 역주행하여 돌아가야만 했고, 대전-서울 구간의 고속선이 폐쇄되는 바람에 다른 KTX들은 아예 경부선 기존선으로 우회해서 다녀야 했다. 주말 임시 열차는 아예 선로 용량 부족으로 인해 운행 중단. 코레일의 입장에서는 손해가 그야말로 막심했을 것이다. 이로 인해 수원-천안 구간에서 KTX 산천이 보이는 진풍경이 연출되기도 했다.

Posted by 사무엘

2011/02/12 17:49 2011/02/12 17:49
, , , , ,
Response
No Trackback , 5 Comments
RSS :
http://moogi.new21.org/tc/rss/response/464

컴퓨터는 배열로 표현된 직사각형 형태의 데이터를 처리하는 걸 좋아하며, 이는 그래픽에서도 예외가 아니다.
그러나 사람이 생각하는 개념을 그래픽 개체의 형태로 표현하다 보면 직사각형이 아닌 임의의 모양의 그래픽을 찍어야 할 일이 생긴다.
게임에서는 스프라이트가 좋은 예이고, 굳이 게임이 아니더라도 GUI 환경에서는 아이콘이라든가 심지어 customized 마우스 포인터도 그런 부류에 속하는 그래픽이다.

이런 그래픽은 결국 큰 직사각형 안에서 투명색을 제외한 나머지 색상을 찍는 방법으로 처리하는데, 그 구체적인 테크닉은 역사적으로 아래와 같은 세 양상을 거치며 바뀌어 왔다.

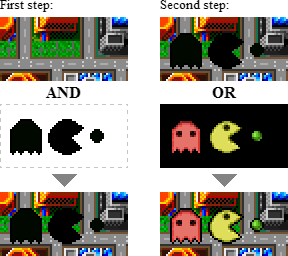
1. 모노크롬이나 그에 준하는 저색상: 비트 연산

그림을 두 장 준비한다. 그리고 그 두 장을 화면에다 그냥 copy만 하는 게 아니라, 화면에 이미 있는 픽셀과 비트 연산을 하여 그 결과를 찍는다. 이것을 raster operation이라고 하는데, 비트 연산은 CPU-friendly한 작업이기 때문에 컴퓨터가 나름 빠르게 수행할 수 있다.

준비해야 하는 그림은,
찍어야 할 내용이 그려져 있고 배경은 '검은색'(0)으로 처리되어 있는 '원래 비트맵'과,
원래 비트맵하고는 정반대로 배경은 무조건 '흰색'(1)이고 내가 차지하는 스프라이트 영역은 '검은색'(0)으로 처리되어 있는 '마스크 비트맵' 이렇게 둘이다. 마스크 비트맵은 1 아니면 0만 있는 모노크롬이다.
(따라서 '원래 비트맵'만으로는 검은색이 배경인지 아니면 스프라이트가 실제로 차지하는 검은색인지 알 수 없다.)

화면에다가는 먼저 마스크 비트맵을 AND 연산으로 그린다. 원래 화면에 있던 픽셀이 X라면, 마스크에서 배경으로 처리된 픽셀은 X AND 1이므로 X가 그대로 남고, 0이면 0이 되어 검은색이 된다.
즉, 마스크 비트맵에 대한 AND 연산은, 스프라이트가 칠해져야 할 영역만 시꺼멓게 만드는 효과를 낸다.

그리고 다음으로 이 자리에다가 원래 비트맵을 XOR 연산으로 그린다.
0 XOR X = X이므로, 이 연산을 수행해 주면 화면이 0으로(특히 마스크 비트맵 AND 연산으로 인해 0이 된) 시꺼먼 곳은 원래 비트맵이 그대로 그려지고, 원래 비트맵이 0인 배경은 아무 변화가 생기지 않는다.

사용자 삽입 이미지

그림의 출처는 위키백과.
이로써 스프라이트가 멋있게 그려졌다.
도스용 게임 중에 <위험한 데이브>는 이런 초보적인 XOR 방식으로 스프라이트를 찍었기 때문에, 검은 배경이 아니라 두 스프라이트가 겹치면 화면에 잔상이 남곤 했다.

옛날 윈도우 9x 시절에.. 컴퓨터 메모리가 많이 부족해서 하드디스크 스와핑/thrashing이 일어나고 프로그램의 각종 아이콘들이 그려지는 게 눈에 보일 때는... 아이콘이 차지하는 영역이 먼저 시꺼매지거나 반대로 잠깐 하얗게 번쩍이는 걸 볼 수 있었다. 흠, 프로토스 건물도 소환이 끝났을 때 실루엣이 허옇게 번쩍이다가 원래 형태가 드러나는데...;; raster 연산을 더블버퍼링 없이 화면에다 바로 그리다 보니, 컴퓨터 속도가 느려졌을 때 그 중간 과정이 눈에 띄는 것이다.

검정에다가 원래 비트맵의 색을 합성할 때는 이론적으로 OR을 써도 되는데 XOR이 의도적으로 쓰이고 있다.
이는 XOR이 유용하기 때문이다. XOR 1은 비트를 반전시켜 준다는 특성상, XOR 연산으로 그린 그림은 거기에다 XOR을 한번 더 해 주면, 다른 곳에 영향을 주지 않고 자기가 차지하고 있던 영역에서만 완전히 지워진다.

XOR 연산은 컴퓨터의 입장에서는 매우 부담이 가볍기 때문에, 마우스 선택 영역을 나타내는 점선 사각형이라든가 창 크기를 조절하는 작대기처럼 수시로 업데이트를 해 줘야 하는 비주얼 효과를 나타낼 때 즐겨 쓰인다.
아니, 텍스트 블록이라든가 깜빡이는 커서(캐럿)조차도 반전 사각형이니까 XOR이다.

마우스 포인터도 XOR 연산이다. 텍스트 입력란을 뜻하는 I자(beam) 모양의 마우스 포인터는 검은색이 아니라 배경색에 대한 반전색이다. 마스크 비트맵 값을 0이 아닌 1로 둬서 배경을 지우지 않은 상태에서 XOR 비트맵도 1로 해 주면 배경색이 반전되는 효과가 난다. ^^;;

XOR 연산은 디지털 컴퓨터가 존재하는 한 그래픽에서 언제까지나 없어지지 않고 쓰일 방식이긴 하지만... 오늘날은 다소 촌스러운(?) 것으로 간주되고 있기도 한다. GPU님이 계시니 화면 비주얼을 굳이 CPU 친화적인 방법만 고집할 필요는 없는 듯. 그래서 요즘은 뭔가 선택 영역을 나타낼 때 알파 블렌딩을 동원하여 다 옅은 파란 배경 + 더블버퍼링으로 대체되는 추세이다. 화면 전체의 DC를 얻어와서 XOR 연산을 시키는 건 Aero 환경에서는 오히려 성능을 더욱 떨어뜨리는 짓이기도 하니 말이다.

2. 모노크롬 이상 16~256색 사이: 컬러 키(color key)

그 후 컴퓨터의 그래픽 카드의 성능이 향상되면서, 256색 시대가 열렸다. 256색은 팔레트 조작이라는 과도기적인 괴악한 개념을 도입한 걸로도 유명하다.
색깔이 적당히 많아졌기 때문에, 비트맵에서 256색 중 하나만 투명색으로 예약하여 쓰지 않고 나머지 색은 그대로 찍게 하는 방식이 유리하다. 마스크 비트맵 따위를 번거롭게 구비할 필요가 없다. 또한 256색은 RGB 값이 아니라 인덱스 기반 컬러를 쓰기 때문에, xor 반전 연산이 어차피 그렇게 큰 의미를 지니지도 않는다. (실제 색깔값이 반전되는 게 아니라 팔레트 인덱스 번호가 반전되기 때문)

256색 전용으로 유명한 gif 그래픽 파일이 이런 컬러 키를 지정하여 투명색을 지정할 수 있다.
윈도우 API에도 비트맵이나 아이콘의 (0, 0) 위치 픽셀을 투명색으로 간주하고 그려 주는 함수가 있으며, SetLayeredWindowAttributes 함수는 컬러 키를 지정하여 해당색을 투명하게 처리함으로써 non-rectangular 윈도우를 만드는 효과를 내어 준다. region을 만들지 않고도 동일한 일을 할 수 있다는 뜻이다.

3. 트루컬러: 알파 채널

투명색 처리의 최종 완전체는 바로 알파 채널이다. 이건 과거의 픽셀 raster operation과는 차원이 다르며, 컴퓨터가 빨라진 정도를 넘어 그래픽 가속을 위한 별도의 GPU까지 등장하면서 가능해진 궁극의 기술이다.
매 픽셀에다가 이분법적인 투명 여부가 아니라, 이 픽셀이 배경과 얼마나 짙게 오버랩될지 반투명 등급 자체가 추가로 들어간다. RGB에 이어 A까지, 가히 색깔의 4차원화인데, 기계 입장에서는 한 픽셀당 딱 정확히 32비트이니 처리하기에는 다행히 좋다.

256색을 초월한 천연색 그래픽에는 워낙 많은 개수의 색상이 쓰이기 때문에.. 그 중 딱 한 색깔에다가만 컬러 키를 부여하는 게 무의미하다. 그리고 마치 글꼴에도 안티앨리어싱을 하듯, 스프라이트도 경계가 배경색과 부드럽게 융합해야 트루컬러의 진정한 의미가 살아난다. 그래서 알파 채널이 필요한 것이다.

윈도우 98에서 알파 채널을 적용한 비트맵 찍기라든가 그러데이션을 한번에 처리하는 API가 처음으로 추가됐다. 프로그램의 제목 표시줄에 그러데이션 효과가 윈도우 98에서 처음 추가되었는데, 바로 이 API를 쓴 것이다.
그리고 윈도우 XP에서는 알파 채널이 적용된 확장 아이콘이 처음으로 도입되었고, GDI+는 그리기 기능에 전반적으로 알파 채널을 염두에 두고 설계되었다. 하지만 GDI의 기본적인 벡터 드로잉 함수는 그런 새로운 기술로부터 소외되어 있으니 안타까울 뿐.

윈도우 비스타는 48*48도 모자라서 아예 256*256 크기의 아이콘을 지원한다. XP 때부터 이제 아이콘 하나가 2~3만 바이트에 달하는 시대가 됐는데(윈도우 3.1 시절에는 1~2천 바이트.. -_-), 전통적인 ico는 bmp와 같은 '무압축 포맷'인지라 256*256 크기의 32비트 픽셀을 저장했다간 크기를 감당할 수가 없기 때문에, ico 포맷은 내부적으로 png 파일도 포함할 수 있게 구조가 확장되었다.
gif를 대체하는 새로운 이미지 포맷인 png는 알파 채널을 지원한다. 그 자그마한 아이콘 하나도 전문 그래픽 디자이너가 포토샵으로 만들어야 하는 시대가 도래한 지 오래이다.

윈도우 내부적으로는 아이콘과 마우스 포인터 파일은 거의 동일한 포맷으로 간주된다. 아이콘은 이미지 이미지 비트맵과 마스크 비트맵 이렇게 둘 들어있는 형태이며, 마우스 커서는 거기에다 센터 위치가 추가되고.. 애니메이션 포인터는 gif스럽게 프레임이 더 추가되겠구나.
알파 채널이 등장하면서 마스크 비트맵은 존재 가치가 상당수 퇴색하긴 했으나, 오늘날에도 고전 테마(XP의 Luna, 비스타의 Aero 따위가 없는)에서 아이콘을 찍을 때라든가 disabled 상태 같은 변형 상태를 찍을 때 참고 정보로 쓰이기 때문에, 완전히 필요가 없어진 것은 아니다.

요컨대 오늘날은 기술 발전의 정도에 따라 최소한 세 가지 형태의 투명색 표현 기법이 쓰이고 있는 셈이다. 흥미로운 사실이다.

Posted by 사무엘

2011/01/24 07:35 2011/01/24 07:35
, , ,
Response
No Trackback , 7 Comments
RSS :
http://moogi.new21.org/tc/rss/response/454

오랜만에 알고리즘 얘기.
정보 올림피아드 공부를 한 적이 있는 분이라면, 제목에 등장한 용어가 아주 친숙할 것이다. 앞으로 LIS라고 줄여 일컫겠다.

어떤 수열이 왼쪽에서 오른쪽으로 나열돼 있으면, 그 배열 순서를 유지하면서 크기가 점진적으로 커지는 가장 긴 부분수열을 추출하는 것이 목표이다.
가령, {3, 2, 1, 4, 5, 2, 3, 5, 3, 6, 4} 같은 수열이 있으면
1, 2, 3, 5, 6이 가장 긴 solution이 된다. {3, 2, 1, 4, 5, 2, 3, 5, 3, 6,  4} OK?
정렬만큼이나 알고리즘 기초를 다지는 데 도움이 되는 흥미로운 문제이다.

이 문제는 간단하게 생각하면 다이나믹 프로그래밍(동적 계획법)을 적용한 O(n^2)의 시간 복잡도로 풀 수 있다. 작은 set에 대한 답을 구한 뒤 그 결과를 저장해 놓고, 그 set의 크기를 차츰 키우면서 작은 solution들을 종합하여 최종 solution을 구하는 방식.

매 원소에 대해서 자기까지 왔을 때 존재 가능한 subsequence의 최대 길이와, 그 subsequence 상에서 자기 앞 원소의 위치를 적어 놓는다. 그러면 다음 원소 차례가 됐을 때는 자기 앞 원소들을 일일이 탐색하여, 자기보다 값이 작으면서 잠재적 subsequence 길이가 최장으로 설정되어 있는 원소에다 자기를 연결해 놓는다. 물론 자기의 subsequence 길이는 1 증가시켜 놓고 말이다.

오프셋 0 1 2 3 4 5 6 7 8 9 10
n 3 2 1 4 5 2 3 5 3 6 4
LIS길이 1 1 1 2 3 2 3 4 3 5 4
이전오프셋 -1 -1 -1 0 3 2 5 6 5 7 6

위와 같은 표가 완성되고 나면, 그 후 개수가 5로 가장 큰 9번 오프셋부터 시작하여 이전 참고 위치를 따라 역추적을 하면 LIS가 구해진다.

그런데 이걸 구하기 위해서 꼭 O(n^2)이나 되는 계산량이 필요할까? 더 효율적인 알고리즘은 없을까?
답은 ‘있다’이다. 물론 메모리 복잡도도 아까처럼 O(n)으로 완전히 동일하고 말이다.
이 새로운 알고리즘은 역시 길이가 n인 버퍼에다가 작업을 하는데, 버퍼의 용도가 아까와는 살짝 다르다.

이 버퍼 A[i](1<=i<=n)의 의미는, 길이가 i인 LIS를 구한다고 쳤을 때 존재 가능한 가장 작은 LIS 마지막 원소(와 그 원소의 위치)이다. 즉, 이 버퍼는 구해진 LIS의 길이만큼만 사용된다.

위의 예제 수열에서 매 원소가 들어올 때마다 버퍼는 다음과 같이 바뀌게 된다. 뒤에 새로운 원소가 추가되거나 이미 있는 값의 업데이트만 발생하지(O(1)), 배열 원소들을 전부 하나씩 밀어야 하는 삽입이나 삭제(O(n))가 발생하지는 않음을 염두에 두기 바란다.
3: 3
2: 2
1: 1
4: 1 4
5: 1 4 5
2: 1 2 5
3: 1 2 3
5: 1 2 3 5
3: 변화 없음
6: 1 2 3 5 6
4: 1 2 3 4 6

즉, 버퍼가 가리키고 있는 것은 각 길이별로 가장 작은 수일 뿐이다. 그러나 버퍼가 가리키는 순서대로 배열을 참조하면 수열이 언제나 오름차순, 즉 정렬이 돼 있다는 게 보장된다.
최소값을 갱신할 위치를 찾는 것은 이분 검색(binary search)으로 할 수 있다. 이 덕분에 작업이 O(n^2)에서 O(n log n)으로 줄어들 수 있게 된다. 정확하게 말하면 O(n log k)(k는 LIS 길이)이니 더욱 빠르다. worst case로 증가 수열을 만들 수가 없는 내림차순 수열을 던져 주면, 거의 O(n)이나 다름없는 속도로 금방 실행이 끝난다는 뜻이다.

물론, 이 버퍼에는 각 길이별로 가장 작은 증가 수열을 구하는 힌트만 들어있을 뿐, 가장 긴 LIS를 추적하는 정보는 전혀 들어있지 않다. 그렇기 때문에 추적 순서는 역시 별도의 배열에다 따로 보관해 놔야 하며 이 역시 그리 어렵지 않게 구현할 수 있다. 심심하신 분은 이 알고리즘을 직접 코딩해 보기 바란다.

정보 올림피아드를 공부하던 시절엔 이런 유형의 문제도 재미있었다. 뭐, 본인은 머리싸움에 쥐약인 타입인지라 경시 부문에서는 별 재미를 못 보고, 대박은 공모 부문에서 다 냈지만 말이다.

- 양수와 음수가 뒤섞인 n개의 수열이 있을 때 합이 가장 큰 구간을 O(n) 시간 만에 구하기
- 위와 비슷한 예로, 0.x와 n.x가 뒤섞인 n개의 수열이 있을 때 곱이 가장 큰 구간을 역시 O(n) 시간 만에 구하기
- x*y 2차원 배열이 있을 때, 이런 조건을 만족하는 가장 넓은 면적을 구하기 (1999년도 IOI의 공항 건설 부지 찾기 같은)

알고리즘이라는 게 OR(operations research)과 밀접한 관계가 있는 것 같다. 선형 계획법, 동적 계획법 같은 개념도 원래는 그 분야에서 유래되었기 때문에 용어에서 그다지 전산학적인 어원은 찾을 수 없다.
덧. algorithm인데 왜 다들 알고리듬이라고 적지 않고 알고리즘(=algorism?)이 보편화해 있는 걸까?

Posted by 사무엘

2010/11/30 09:00 2010/11/30 09:00
, , ,
Response
No Trackback , 4 Comments
RSS :
http://moogi.new21.org/tc/rss/response/421

우리는 C/C++ 언어에 대해 배울 때, 이 언어는 근본적으로 컴파일과 링크를 거쳐 결과물이 만들어지며, 이 과정에서 소스 코드가 obj 파일로 바뀐다는 말을 듣는다. 그런데 이런 중간 파일들의 내부 구조는 어떨지, 최종 결과물인 실행 파일의 형태와 중간 파일 사이의 관계는 어떨지 등에 대해서 궁금하게 생각해 본 적은 없는가?

물론 obj 파일에는 컴파일된 기계어 코드가 잔뜩 들어있을 것이고 lib는 그냥 이미 컴파일된 obj 파일의 컬렉션에 불과하다. 하지만 그걸 감싸는 컨테이너 포맷 자체는 필요할 것이다.
C++의 경우, 함수의 이름을 prototype대로 decorate하는 방식이 표준으로 제정된 적이 없어서 그 방식이 컴파일러마다 제각각인 것으로 악명 높다. 그렇다면 이런 obj, lib 파일 포맷도 언어마다, 혹은 컴파일러마다 제각각인 것일까?

결론부터 말하자면, 정답은 ‘No’이다. obj, lib 같은 파일 포맷은 실행 파일의 포맷과 더불어 굉장히 시스템스러운 포맷이고, 일반적인 응용 프로그램의 개발자가 거의 관심을 가질 필요가 없는 분야임이 틀림없다. 컴파일러를 만든다거나, 골수 해커 같은 부류가 아니라면 말이다.

이런 건 그렇게까지 다양한 파일 포맷이 존재하지 않으며, 다양하게 만들 필요도 없다.
인텔 x86 기계에서는 전통적으로 인텔 사가 고안한 OMF(object module format이라는 아주 평이한 단어의 이니셜) 방식의 obj/lib 포맷이 독자적으로 쓰였다. 굉장히 역사가 긴 포맷이며, 볼랜드, 왓콤, MS 등의 컴파일러에서 다 호환됐기 때문에 서로 다른 컴파일러나 언어로 만든 obj 파일끼리도 이론적으로는 상호 링크가 가능했다. 물론, 언어별로, 특히 C++의 경우 아까 언급했듯이 decoration 방식이 다르면 명칭이 일치하지 않아 혼용이 곤란하겠지만, 이건 파일 포맷 자체의 문제는 아니었다.

그런데, 32비트 시대가 도래하면서 사정이 약간 달라졌다.
machine word의 크기가 커지고 CPU의 레지스터 구조도 달라지고.. 그에 따라 obj/lib 파일의 포맷도 일부 필드의 크기가 확장되는 등 변화를 겪게 되었으며, 인텔 사에서는 OMF 포맷을 32비트로 확장한 업그레이드 버전을 내놓았다. 마치 지금 윈도우의 PE 실행 파일도 64비트에서는 기본적인 뼈대는 그대로 유지하되, 규격이 확장된 것과 같은 이치이다.

컴파일러들은 대체로 그 규격을 따르기 시작했으나, 이때 MS에서는 꽤 과감한 결정을 내렸다.
기왕 32비트로 갈아타는 김에, 자기네가 만드는(OS/2의 밑천으로? ㄲㄲ) 순수 32비트 운영체제인 윈도우 NT에서는 공식 사용하는 실행 파일과 obj/lib 파일의 포맷을 싹 바꾼 것이다.
어디 그뿐일까? 메모리가 귀하던 1990년대에 그때 이미 유니코드를 고려하여 딱 16비트 wide string을 내부 자료 구조로 채택했다. 본인이 보기에 윈도우 NT는 출발이 굉장히 대인배스러웠다.

새로운 포맷은 단순히 구조체 필드만 32비트에 맞게 키운 게 아니라, 더 보편적인 이식성과 확장성을 고려해서 설계되었다. 코드, 데이터 등 용도별로 다양한 chunk를 둘 수 있고, CPU 정보도 넣어서 굳이 x86뿐만이 아니라 어느 플랫폼 코드의 컨테이너로도 활용할 수 있게 했다. 또한 어차피 똑같은 기계어 코드가 들어있는 파일인데 obj/lib/exe 사이의 구조적 이질감을 낮춰서 일단 컴파일된 코드의 링크 작업을 더욱 수월하게 할 수 있게 했다.

그래서 MS는 32비트 컴파일러에서는 AT&T가 개발한 COFF(Common Object File Format) 방식을 약간 변형한 obj/lib를 사용하기 시작했고, 32비트 실행 파일은 잘 알다시피 COFF의 연장선에 가까운 PE(Portable Executable) 방식을 채택했다. 이 컨벤션이 오늘날의 64비트에까지 고스란히 전해 내려오는 중이다.

그렇게 MS는 과거 유물을 미련 없이 내버렸지만, 볼랜드 컴파일러는 32비트 윈도우용도 여전히 OMF 방식을 사용했고, 왓콤처럼 당시 16비트/32비트 도스/윈도우를 모두 지원하던 컴파일러는 OMF와 COFF 방식을 혼용까지 해서 당시 개발자들에게 상당한 혼란을 끼쳤다고 한다. 윈도우 운영체제가 16비트에서 32비트로 넘어가면서 이런 것까지도 정말 넘사벽에 가깝게 세상이 바뀐 것이다. 참고로 DJGPP는 도스용 컴파일러이지만 32비트 기반이고 COFF 방식 파일을 사용한다.

1985년에 나온 윈도우 1.0 이래로 16비트 윈도우가 사용하던 NE 포맷은 chunk 같은 게 없었다. 정보 자체를 식별하는 방법이 없이 요 정보 다음엔 무슨 정보, 다음에는 무슨 정보.. 딱 용도가 고정되어 있었고, 뭔가 확장을 할 수가 없었다. 상당히 원시적인 포맷이었다는 뜻. 개인적으로 그 시절에는 컴파일과 링크가 어떻게 이뤄졌고 DLL import/export가 어떤 방식으로 되었는지 무척 궁금하다.

또 생각나는 게 있는데, 과거에 똑같은 베이직 컴파일러이지만 MS가 개발한 퀵베이직은 굉장히 C언어에 가깝고, 파워베이직은 파스칼에 가까운 빌드 모델을 사용했다. 전자의 경우 헤더 파일을 인클루드하고 소스 파일을 obj로 컴파일하고, 각종 라이브러리와 링크하고... C와 똑같지 않은지? obj/lib 파일 포맷은 당연히 인텔 OMF 방식이었다.

그 반면, 파워베이직은 파스칼처럼 unit이라는 패키지를 만들고, 그걸 간단하게 use하는 것만으로 여타 모듈의 루틴을 사용할 수 있었다. 자바, C#, D 같은 요즘 언어들이야 비효율적인 인클루드(text parsing이 필요!) 방식이 아닌 패키지 import를 선호하는 추세이지만, 그 당시 파워베이직을 개발한 Bob Zale은 분명 파스칼 언어에서 이 아이디어를 따 왔을 것 같다. 물론 그렇다고 해서 파워베이직도 기존 obj 파일과 링크하는 방식이 없는 건 아니었다.
Bob Zale과, 터보 파스칼을 개발한 필리페 칸과는 어떤 사이일지 궁금하다.

C/C++에 전처리기가 있다면, 베이직이나 파스칼 같은 언어는 주석 안에다가 메타커맨드를 넣는 방식을 써 온 것도 흥미로운 점.
아울러, tpu, pbu 같은 저런 unit 파일은 분명 컴파일된 기계어 코드가 들어있는 라이브러리에 가깝지만, 당연히 컴파일러 vendor마다 파일 포맷이 제각각이다. 마치 퀵베이직의 QLB(퀵라이브러리) 파일이 아주 독자적이고 특이한 실행 파일인 것처럼 말이다.

Posted by 사무엘

2010/11/16 10:29 2010/11/16 10:29
, , , , , ,
Response
No Trackback , No Comment
RSS :
http://moogi.new21.org/tc/rss/response/412

대학원에 간 뒤부터 컴퓨터나 프로그래밍 쪽 글은 눈에 띄게 줄고, 확실히 언어 쪽 글이 늘었다. 물론 철도 글은 예나 지금이나 비슷한 빈도로.. ㅋㅋㅋ
그래도 언젠가 한 번쯤 이런 글을 올리고 싶었다.

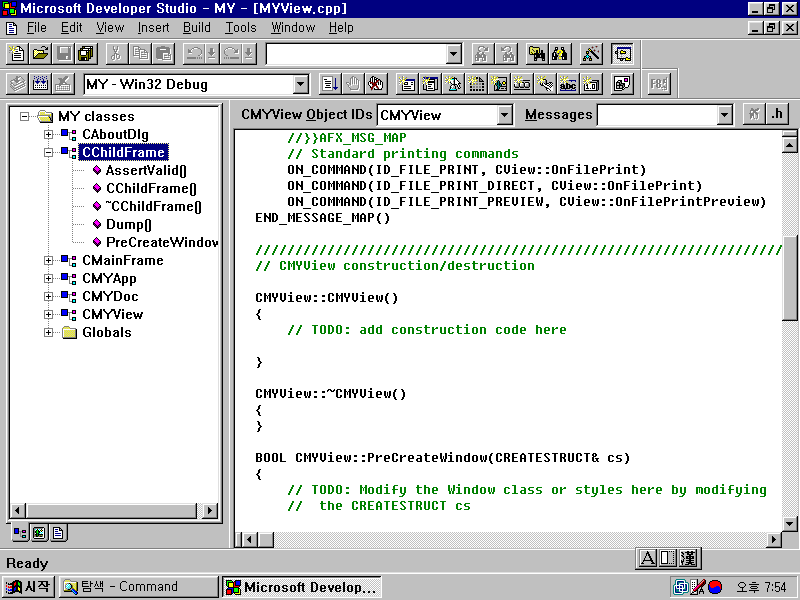
비주얼 C++ 4.2는 본인이 고등학교에 진학하고서 도스용 프로그램으로 정올 공모를 한 번 마친 후, 그때부터 공부하기 시작한 툴이다. 이때 윈도우 API, MFC, 심지어 C++ 객체 지향 개념까지 전부 뭉뚱그려서 동시에 공부를 시작한 셈이었다.
그로부터 10년이 지난 지금까지도 비주얼 C++은 나의 소중한 친구이고 내 마음의 고향이다. ^^;; <날개셋> 한글 입력기 1.0이 VC++ 4.2로 개발되었다.

참고로 4.2 버전은 4.0 버전이 몇 차례 마이너 업그레이드를 거친 것이었다. 4.2가 따로 4.0처럼 별도의 패키지로 출시되지는 않았으며, MSDN 구독자에게만 비공식적인 경로로 배포되었다고 한다. 이 점에서 4.2는 윈도우 95로 치면 마치 OSR2 업그레이드 에디션과 비슷한 위상이다.
지금은 윈도우든 개발툴이든 오피스든 MS에서 나오는 제품들은 다 서비스 팩이라는 개념으로 업데이트 방식이 통일되었지만 말이다.

그러나 4.2라는 버전은 굉장히 의미가 크다. 윈도우 운영체제가 시스템 차원에서 MFC 라이브러리의 하위 호환성을 보장해 주고 있는 최후 버전이 4.2이기 때문이다. 그 이름도 유명한 MFC42.DLL이다. MFC40.DLL이 아니다.

사용자 삽입 이미지

(<날개셋> 한글 입력기 1.0이 바로 윈도우 95 + 800*600 화면 + 비주얼 C++ 4.2 환경에서 개발됐다.)

그 전부터도, PC 환경에서 이제 윈도우가 대세로 넘어갔으니 윈도우 프로그래밍을 공부하려고 마음을 안 먹은 건 아니었다. 그러나 그때는 비주얼 베이직이나 델파이, C++ 빌더처럼 RAD 툴 수준에 머물러 있었다. 그러던 차에 접한 비주얼 C++은 굉장히 충격적이었다.
이 툴로는 다른 툴과는 달리, 운영체제와 직통으로 대화하고 다른 이상한 런타임이 필요하지 않은 가볍고 빠른 프로그램을 만들 수 있었기 때문이다.

비주얼 C++ 4.2 자체도 요즘 최신 버전에 비하면 정말 미치도록 작고 가볍다. ^^;;; 도움말은 RTF 기반이었고, C/C++ + 윈도우 API + MFC 레퍼런스를 전부 합해서 용량이 150MB 남짓밖에 안 했다. 그 당시 왼쪽의 class view는 실시간 업데이트가 되지 않았으며, 소스 코드를 저장해야 업데이트 됐다. ^^;;;
또한 프로그램 파일들이 압축되지 않은 형태로 CD에 그대로 들어있었기 때문에, 프로그램을 설치하지 않고도 CD에서 곧바로 MSDEV.EXE를 실행해서 프로그램을 실행할 수도 있었다. 물론 전기능을 제대로 활용할 수는 없었지만.

한동안 MS 오피스와 비주얼 C++은 요즘 서울 버스 색깔처럼 빨-노-초-파가 어우러진 4색 고리 모양 아이콘을 사용해 왔다. 4.2도 그랬다. 그런데 2010 버전은 둘 다 단색 아이콘으로 돌아갔으니 이 또한 흥미로운 점. 오피스는 노랑-주황색 사각형 창 4개 모양이 됐고, 비주얼 스튜디오(C++ 포함)는 보라색 ∞ 모양이 돼 있다.

세월이 흘러, 현재 <날개셋> 한글 입력기는 9개 모듈을 모두 비주얼 C++ 2008로 개발되는 중이다. 그러나 타자연습과 파워업은 적극적인 개발보다는 유지 보수만 하는 만큼 여전히 2003을 사용 중이다.

Posted by 사무엘

2010/10/29 16:10 2010/10/29 16:10
,
Response
No Trackback , 9 Comments
RSS :
http://moogi.new21.org/tc/rss/response/400

동일한 기능을 하는 프로그램이 여러 CPU 아키텍처로 포팅된 실행 파일을 살펴보면...
우리에게 아주 친숙한 x86 아키텍처용 EXE는 크기가 가장 작다고 단정적으로 말할 수는 없지만 상당히 작은 편이다.
이보다 코드 사이즈가 더 작게 컴파일되는 아키텍처는 본인이 보기엔 찾기가 어렵다.
EXE 파일의 기계어 코드 부분을 헥사 에디터로 들여다봐도 코드 바이트가 좀 조밀조밀 있는 편이다. 그 반면 IA64나 MIPS 같은 아키텍처 EXE의 기계어 코드를 들여다보면, 4~8바이트 단위로 패턴이 느껴진다.

물론 인텔 아키텍처도 그나마 32비트와 64비트로 가면서 인스트럭션의 평균적인 크기가 길어져 오긴 했다. 그런데 초기의 16비트 명령 체계는 정말 아담했으며, 어셈블리 튜닝을 쓰면 오늘날의 컴퓨터 아키텍처로는 상상도 할 수 없는 작은 크기의 프로그램으로 온갖 큼직한 기능을 넣을 수 있었다. ^^;;
인텔 아키텍처는 하위 호환성을 최대한 존중하고 있으니, 옛날에 정한 1바이트짜리 코드 바이트가 다 선점되었으면 32비트나 64비트 때 추가된 명령은 탈출문자 접두사를 붙여서 5바이트~6바이트... 이런 식으로... 근본적으로 길어질 수밖에 없는 셈이다.

컴퓨터 아키텍처에 대해서 배운 전산 전공자라면, CISC 방식과 RISC 방식의 차이에 대해서는 익히 들어 봤을 것이며, 오늘날엔 이런 식의 단편적인 구분이 별 의미가 없어졌다는 것까지도 알고 있을 것이다.

옛날은 메모리가 아주 귀한 자원이던 시절이었다. 그래서 인텔 x86은 코드를 적재하는 데 필요한 기억장소의 크기를 최대한 아끼는 방향으로 설계되었다. 기계어 코드의 크기가 1바이트부터 시작해 아주 가변적이고, 각 명령 하나하나에 꽤 함축적으로 많은 뜻을 포함시킬 수 있다.

많은 뜻이라 함은, 명령을 내릴 때 상대 주소라든가 절대 주소라든가 실제 상수 같은 개념을 한 인스트럭션에다가 바로 표현할 수 있음을 의미한다. 다른 아키텍처라면 임시값을 또 레지스터에다 먼저 저장하고 전처리를 해서 여러 인스트럭션을 거쳐 표현해야 할 명령을, 한 인스트럭션만으로 표현할 수 있다는 뜻이다. 이것을 CISC 방식이라고 하며, 앞의 C는 complex를 뜻한다. 인텔 x86은 CISC 방식 아키텍처의 대표적인 예이다.

CISC 방식는 상술했듯이 코드 길이가 짧아진다는 장점이 있지만 이를 하드웨어적으로 해석하는 회로가 필연적으로 복잡해지고 만들기 어려워진다는 단점이 있다. 이는 전력 소모의 증가로까지 이어진다. CPU에서 실제로 명령을 실행하는 부분이 아니라 이게 무슨 명령인지 파악하는 부분부터가 오버헤드가 커진다는 뜻이다.

그래서 CISC 방식은 근본적으로 임베디드나 모바일 환경에는 적합하지 않다. 이런 이유로 인해, 오늘날 전세계적인 각광을 받고 있는 스마트폰에서는 ARM이라는 RISC (Reduced) 방식 아키텍처가 쓰이고 있다. ARM이 스마트폰 세계에서 거의 인텔 x86 같은 본좌 인지도를 차지한 것이다.

RISC는 설계 철학이 CISC와는 반대이다. 인스트럭션의 크기는 기계가 한 번에 인식하는 machine word 크기와 일대일 대응하거나 최소한 배수 단위이다. 인스트럭션을 fetch, decode하고 의미를 파악하는 절차가 아주 간편하다. 최소 의미 단위가 작은 대신에 임시 작업용으로 범용 레지스터를 CISC 방식 CPU보다 꽤 많이 준다.

이런 CPU는 심지어 구조체 멤버를 인식하는 단위에도 제약이 있다. 포인터의 오프셋이 machine word의 배수 단위로 딱 떨어지지 않고 사이에 걸쳐 있는데 그 주소를 참조시키면 CPU가 에러를 일으킨다. 성능과 효율을 위해, 이런 복잡한 상황은 과감하게 처리를 거부하는 방법을 택한 것이다.

인텔 x86은 그렇지 않다. 명령어의 실행부터가 워낙 지저분한 바이트 단위 fetching에 익숙한지라, 오프셋이 저런 경우에도 한 사이클만에 참조를 못 하더라도 여러 사이클로 나눠서 사용자가 원하는 데이터를 얻어 준다.

RISC 아키텍처에서 돌아가는 실행 파일을 들여다보면 기계어 코드가 진짜로 4바이트나 8바이트 패턴으로 쫘르륵 나열되어 있는 걸 볼 수 있다. 그리고 동일한 코드를 컴파일한 실행 파일 크기가 x86 같은 아키텍처의 것보다 더 크고, 실행 파일의 압축률도 더욱 높다(듬성듬성하다는 뜻). 다만 한 기능을 수행하는 데 드는 CPU 명령 수가 증가하고 그럴 수록 side effect라든가 복잡도도 더 증가하는 만큼, RISC 아키텍처 코드를 컴파일러가 최적화하기는 더욱 어려울 것이다.

이렇듯, 컴퓨터 아키텍처에서 CISC냐 RISC냐 하는 케케묵은 논쟁은 자동차로 치면 전륜 구동이냐 후륜 구동이냐, 철도 차량으로 치면 동력 분산식이냐 동력 집중식이냐 하는 차원의 재미있는 주제이다. 요즘은 x86 같은 CISC 방식 CPU도 내부적으로는 복잡하고 함축적인 명령을 다시 RISC 식 명령으로 나눠서 파이프라인을 수행함으로써 RISC의 장점을 취하려고 하고 있다.

그리고 문득 든 생각:
어느 기계에서나 이식 가능한 평범한 C/C++ 코드는 자연어로 치면 "나는 철수입니다" 같은 평이한 문장에다 대응시킬 수 있다.
그렇다면 도저히 포팅이 불가능한 인라인 어셈블리 코드는, 자연어로 치면 특정 언어의 음운 특성이나 특정 문화 배경에 대한 이해 없이는 도저히 이해할 수도, 문자 그대로 번역할 수도 없는 함축적인 유머나 언어 유희에다 비유할 수 있겠다.

Posted by 사무엘

2010/09/20 09:16 2010/09/20 09:16
, , , ,
Response
No Trackback , 6 Comments
RSS :
http://moogi.new21.org/tc/rss/response/376

아래아한글이 윈도우 비스타부터 키매크로를 지원 안(못) 하는 이유는?
(관련 글: 아래아한글의 키매크로 )
이것과 관련하여 갑자기 떠오른 생각이 있어서 글을 남긴다. 본인은 한컴에 입사한 개발자도 아니고 아래아한글의 소스 코드를 본 적도 없지만, 본인이 보기에 이것 때문이 거의 확실하다.

윈도우 훅 중 WH_JOURNALRECORD와 WH_JOURNALPLAYBACK 훅이 비스타에서부터는 보안 강화를 이유로 차단되었기 때문이다. MSDN을 보면 알 수 있지만 저건 완전 키매크로를 구현하라고 만든 훅이다.
(관련 글: 훅킹 프로그래밍 )
실패 사유를 나타내는 에러 코드는 5(access denied)가 들어온다.
심지어는 프로그램을 관리자 권한으로 실행해도 차단은 풀리지 않는다. 이건 좀 너무 심하지 않았나?

물론, 키매크로를 구현하는 방법이 저 훅만 있는 건 아니기 때문에 다른 키보드/마우스 훅을 사용하여 동일 기능을 우회 구현할 수도 있다. 하지만 이래저래 개발자에게는 귀찮고 짜증나는 일이 하나 더 생긴 게 틀림없다.

참고로 이렇게 차단을 하는 주체는 사용자 계정 컨트롤(UAC)이다. 그렇기 때문에 이걸 끄면 비스타도 XP와 완전히 동일하게 동작은 한다. 하지만 보안상으로는 위험하기 때문에 개발자가 사용자에게 UAC를 끌 것을 강요해서는 안 된다.
UAC는 안전을 위해 프로세스 간 의사소통을 하는 메커니즘에도 상당한 제약을 부과했다. 단적인 예로, 권한이 낮은 프로그램이 권한이 높은 프로그램에게 임의의 메시지를 보낼 수 없다.

이미 아시는 분도 있겠지만 <날개셋> 한글 입력기는 5.3부터 입력 패드라는 프로그램을 제공하고 있다. 윈도우 IME 훅킹을 통해, 정식 외부 모듈이 아니면서도 외부 모듈의 동작을 흉내 내어 주는 프로그램인데, 이 프로그램을 제대로 사용하려면 관리자 모드로 실행해 줘야 한다. 그렇지 않으면 입력 패드보다 권한이 높은 프로그램(관리자 권한으로 실행된)에다가는 글자 입력을 할 수 없게 된다.

그런데, UAC 하에서도 예외적으로 실행 중인 모든 프로세스의 윈도우에다가 메시지를 보낼 수도 있고 심지어 봉인된 WH_JOURNAL* 훅까지 구사할 수 있는 만능 권한 등급이 없는 건 아니다. MS에서는 대표적인 예 중 하나로 장애인의 UI 접근성 개선을 위해 쓰이는 프로그램에게나 그런 만능 권한을 주고 있다.
예를 들어 화면 키보드 같은 프로그램이야 권한을 초월하여 아무 프로그램에게나 문자 입력 메시지를 전달할 수 있어야 하고 심지어 운영체제 로그인 UI에도 존재해야 하기 때문이다. (ID/패스워드 입력할 때)

단지 그 권한을 얻기가 더럽게 까다로워서 문제이다. 만능 권한을 얻을 수 있는 프로그램은 사용자의 컴퓨터에 반드시 관리자 권한으로 정식으로 설치되어 EXE 파일이 Program Files 같은 특정 경로에만 존재해야 한다. 잘 알다시피 UAC 하에서는 평소에는 Program Files 디렉터리 밑에다가 파일을 만들지도 못한다.

또한, 결정적으로 EXE 내부에 디지털 서명이 되어 있어야 한다. 과거에 마치 ActiveX를 배포할 때 안전한 코드 인증을 받는 것처럼 말이다. 이거 서명을 받으려면 $이 필요하고, 무엇보다도 사업자 등록 번호가 있어야 한다. 즉, 듣보잡 개인 개발자는 서명을 받지도 못한다는 뜻.
따지고 보면 <날개셋> 입력 패드도 일종의 화면 키보드처럼 UI 접근성 개선 프로그램의 성격이 강하기 때문에 저런 권한이 있어야 할 텐데... 그러지는 못하고 있고 그저 사용자가 알아서 충분히 높은 권한을 줘서 프로그램을 실행해 주길 바랄 뿐이다.

이래저래 보안이 안전을 빌미로 세상을 많이 복잡하게 만들고 있다.
(관련 글: 프로그램의 권한 )

Posted by 사무엘

2010/09/13 18:34 2010/09/13 18:34
, , ,
Response
No Trackback , 2 Comments
RSS :
http://moogi.new21.org/tc/rss/response/372

윈도우 운영체제에는 MDI (Multiple Document Interface)라는 규격이 존재하여, 한 응용 프로그램이 메모리가 허용하는 한 여러 파일 내지 문서를 한꺼번에 다루는 걸 수월하게 해 줬다. MDI 프로그램에는 '창'이라는 메뉴가 존재한다.
과거에 도스용 아래아한글이 기껏해야 겨우 두 개의 문서만 동시에 열 수 있었던 것에 비하면 이건 아주 획기적인 개념이 아닐 수 없었다. MDI는 무려 윈도우 3.x는 말할 것도 없고 원래 2.x 때부터 존재한 개념이라고 한다.

그래서 나만의 작업 문서라는 개념이 있고(스프레드 시트, 그래픽, 워드 프로세서 등등), 좀 규모가 있다 싶은 업무용 프로그램이라면 예외 없이 MDI 방식으로 만들어졌다. 그리고 본인이 개발한 <날개셋> 편집기 프로그램도 1.0 시절부터 MDI였다. ^^
프로그램 자체를 중복 실행하지 않고 한 프로그램 안에서 여러 문서를 동시에 열 수 있는 것은 작업 생산성 면에서 매우 바람직하고 시스템 자원 사용 효율면에서도 좋기 때문이다. (한 번에 소스 코드를 하나만 열 수 있는 에디터로 대규모 프로그래밍 작업을 해 보면 어떨까? -_-)

물론, 윈도우 운영체제가 제공하는 액세서리 프로그램들은 그 정도의 근성은 없는 그냥 말 그대로 액세서리에 불과하기 때문에 MDI 프로그램을 찾아볼 수 없다. 마치 워드패드나 그림판처럼 말이다.
하지만 과거 윈도우 3.x 시절에는 운영체제(?)의 쉘이요 간판 프로그램이라 할 수 있는 '프로그램 관리자'가 딱 MDI 프로그램이었다.

이 MDI 방식에 대해서는 비판도 많았다. 그 자체가 사실 등장한 지 20년 가까이 된 너무 구닥다리 인터페이스이도 하고.. 특히 Aero가 적용된 윈도우 비스타에서도 MDI 창들은 여전히 전혀 세련되지 못한 밋밋한 모양이다.
그래서 요즘은 프로그램 안에 또 여러 창이 타일처럼 더덕더덕 겹쳐 있는 모습 자체를 안 보이려고 하는 게 대세이다. 그 대안으로 각광받고 있는 건 탭 인터페이스이다.

이런 추세는 MS의 주력 상품인 오피스에서도 바로 나타났다. 그것도 꽤 오래 전부터 말이다.
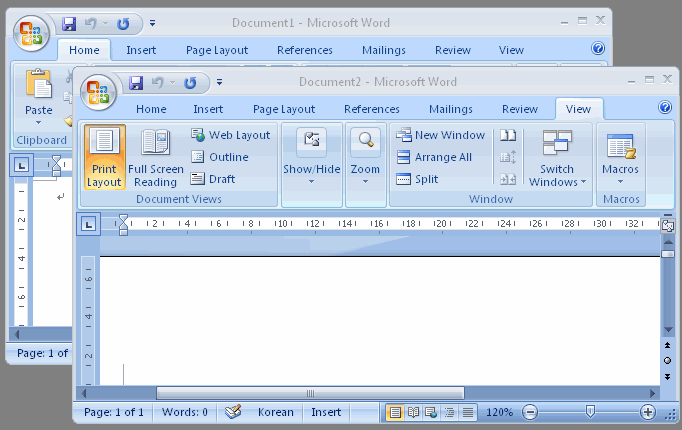
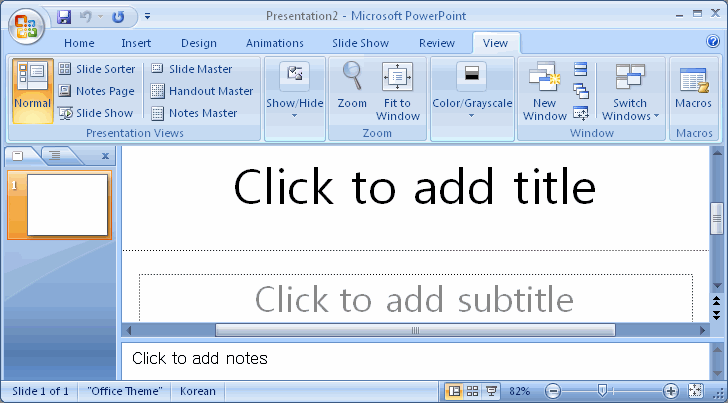
워드의 경우, 아예 10년 전 오피스 2000부터 MDI 방식을 버렸다. 그냥 모든 문서마다 응용 프로그램 프레임이 따로따로 붙어서 '창' 메뉴만 있을 뿐 SDI 프로그램을 여러 개 실행한 것처럼 동작한다.
마치 윈도우용 아래아한글처럼 말이다. 특이하게도 오피스 제품들 중, 워드만 유일하게 그렇게 따로 놀고 있다.

사용자 삽입 이미지

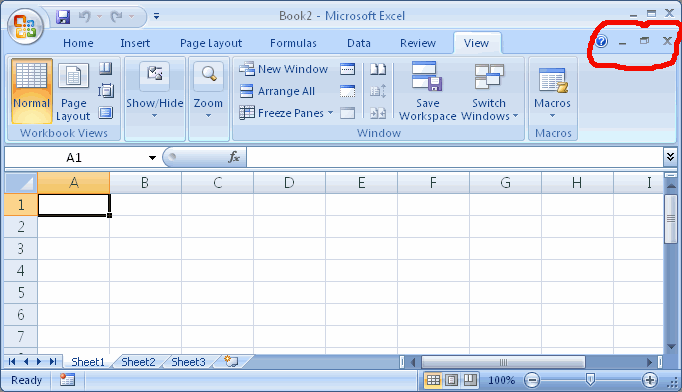
엑셀은 그래도 좀 전통적인 스타일을 유지하고 있다. MDI스러운 메뉴를 볼 수 있으며, 여러 문서 창들을 응용 프로그램 창 내부에다가 덕지덕지 배열할 수 있다. 엑셀은 표 형태로 된 각종 수치와 데이터를 처리하는 프로그램이지 않던가? 당연히 그런 식으로 한 화면에서 여러 파일을 대조할 수 있어야 한다.

사용자 삽입 이미지

하지만 파워포인트는 성격이 좀 다르다. 큼직한 화면 전체에다가 슬라이드 그림을 놓고, 그 곁엔 다른 슬라이드들 썸네일과 슬라이드 노트를 작성하는 공간이 들어가기 때문에 근본적으로 화면이 많이 필요하다.
즉, 파워포인트 슬라이드의 작업 화면은 엑셀 워크시트와 같은 MDI 식 덕지덕지 타일 배열 자체가 무의미하다. 그래서 파워포인트는 워드가 아닌 MDI 형태임에도 불구하고 MDI 메뉴를 갖추고 있지 않으며, 문서 창은 언제나 최대화되어 있다고 가정하고 동작한다. 굳이 최대화 상태를 해제려면 계단식 배열 같은 별도의 명령을 직접 내려 줘야 한다.

사용자 삽입 이미지

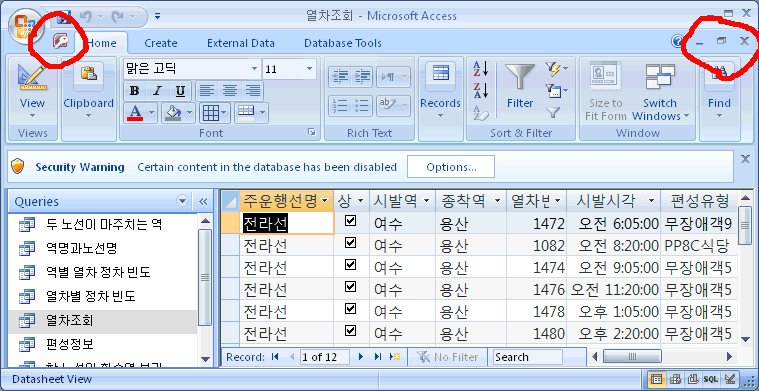
끝으로 데이터베이스 프로그램인 엑세스는 한 프로그램이 한 데이터베이스만 열 수 있고, 그 데이터베이스 안에 있는 각종 테이블, 쿼리, 모듈 등을 MDI 형태로 여럿 열어볼 수 있는 형태이다. 이런 점에서는 엑셀처럼 매우 MDI스러운 UI를 유지하고 있는 셈인데, UI 기반이 엑셀과는 다르다 보니 각 창에 대한 시스템 메뉴도 갖추고 있고, MDI 배경색이 엑셀이나 파워포인트의 배경색보다는 짙다. 또한 View 탭이 따로 없으며, 창과 관련된 메뉴가 Home 탭에 같이 들어있다.

사용자 삽입 이미지

이렇듯, MS 오피스의 주축을 이루고 있으며 2007부터 리본 UI가 첫 적용된 워드, 엑셀, 파워포인트, 액세스의 UI 형태는 다 조금씩 차이가 있다는 사실이 흥미롭다. 참고로, 엑셀이나 파워포인트는 워드처럼 매 문서창이 완전히 제각각 따로이지 않음에도 불구하고, 매 문서마다 운영체제의 작업 표시줄(Taskbar)에 제목이 마치 별개의 프로그램처럼 추가된다. 이 역시 2000부터 그렇게 되었는데, 무척 특이한 점이 아닐 수 없다.

MDI에 대해 끝으로 생각해 볼 점은, 웹브라우저나 파일 관리 유틸리티가 MDI 형태로 개발되고 있지 않다는 것.
이들은 분명 한 프로그램이 여러 창을 취급할 수는 있어야 하지만, 문서라는 개념을 다루는 프로그램이 아니라는 것이 독특하다.

Posted by 사무엘

2010/09/07 14:43 2010/09/07 14:43
, ,
Response
No Trackback , 5 Comments
RSS :
http://moogi.new21.org/tc/rss/response/367

« Previous : 1 : ... 23 : 24 : 25 : 26 : 27 : 28 : 29 : 30 : 31 : ... 32 : Next »

블로그 이미지

그런즉 이제 애호박, 단호박, 늙은호박 이 셋은 항상 있으나, 그 중에 제일은 늙은호박이니라.

- 사무엘

Archives

Authors

  1. 사무엘

Calendar

«   2026/10   »
일 월 화 수 목 금 토
        1 2 3
4 5 6 7 8 9 10
11 12 13 14 15 16 17
18 19 20 21 22 23 24
25 26 27 28 29 30 31

Site Stats

Total hits:
4192338
Today:
574
Yesterday:
1684